Codificador & Decodificador Base64

Codificador & Decodificador Base64

Codifique e decodifique strings Base64 ou arquivos binários instantaneamente. Suporte a base64url seguro para URLs, UTF-8, quebras de linha MIME, Data URLs e autorreparo em tempo real.

Selecionar Cenário Predefinido
Visualizador de Pipeline: 3 Octetos (24 bits) para 4 Sextetos (6 bits) (RFC 4648)
Tríade de Octetos (3 Bytes) #1 / 7RFC 4648 OK
Octetos Binários Brutos (3 Bytes = 24 Bits)A (0x41)01000001l (0x6C)01101100a (0x61)01100001010000 • 010110 • 110001 • 100001Sextetos Base64 (6 bits)[010000]#16Q[010110]#22W[110001]#49x[100001]#33h
Fluxo de Entrada de Dados
Data URL em 1 Clique:
Tamanho de Entrada19 caracteres
Tamanho de Saída28 bytes
Taxa de Expansão+47.4%
Modo AtivoCodificar
Variante Base64Padrão (RFC 4648)
Integridade Estrutural100% OK
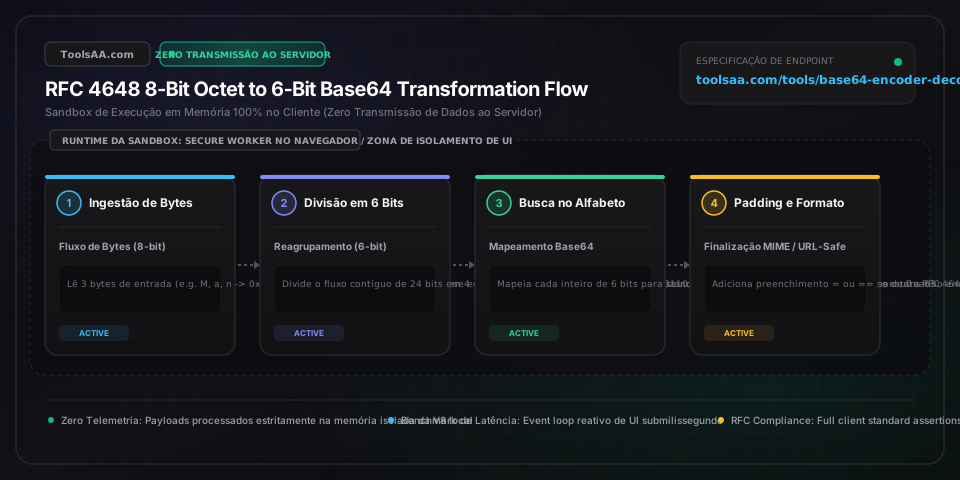
Referência técnica e guia de arquitetura

Codificador & Decodificador Base64 — Guia de referência

Codifique e decodifique strings Base64 ou arquivos binários instantaneamente. Suporte a base64url (URL-safe), Unicode UTF-8, quebra de linha MIME, Data URLs e correção de erros em tempo real.

Codificador & Decodificador Base64 — Guia de referência — Arquitetura em memória do lado do cliente e fluxo de dados

Parâmetros-chave e controles

Tabela do Alfabeto Base64Conjunto de Caracteres

Tabela de mapeamento de 64 caracteres atribuídos a valores de 6 bits de 0 a 63. O padrão RFC 4648 utiliza [A-Za-z0-9+/], enquanto a variante URL-safe substitui + e / por - e _.

Padrão: Padrão RFC 4648
Caractere de Preenchimento (=)String

Caractere de sufixo (padding) adicionado quando o fluxo binário de entrada não é múltiplo de 24 bits. Adiciona == para 1 byte restante ou = para 2 bytes restantes. Omitido no base64url.

Padrão: Habilitado (=)
Limite de Quebra de LinhaInteiro / Predefinição

Contagem de colunas após a qual uma quebra de linha CRLF ou LF é inserida. O padrão MIME utiliza 76 caracteres por linha, PEM utiliza 64 caracteres e APIs web modernas geralmente utilizam Nenhum.

Padrão: Nenhum (Contínuo)
Codificação de Caracteres do TextoEnum

Padrão de serialização de bytes para texto simples. UTF-8 processa todos os caracteres Unicode globais e emojis. ISO-8859-1 (Latin-1) e ASCII limitam-se a intervalos de byte único.

Padrão: UTF-8
Esquema de Data URLFormato de String

Formato de URI com prefixo MIME (data:[<mediatype>][;base64],<data>) que permite embutir imagens, fontes, áudio e documentos diretamente em arquivos HTML e CSS.

Padrão: Detecção Automática

Dicas profissionais e melhores práticas

Contorne a Exceção de Unicode do btoa() em JavaScript

A função nativa do navegador window.btoa() gera um InvalidCharacterError ao processar qualquer caractere fora do intervalo Latin-1 (code point > 255). Para codificar com segurança textos modernos em UTF-8 com emojis ou alfabetos internacionais, converta a string em um Uint8Array usando new TextEncoder().encode(str) antes de mapear o fluxo de bytes para Base64.

Evite Falhas em Parâmetros de URL com Base64url

O Base64 padrão utiliza os caracteres mais (+) e barra (/). Quando transmitidos em parâmetros de consulta (query strings) HTTP, servidores web frequentemente decodificam + como espaço em branco, corrompendo o payload. Utilize sempre a especificação Base64url (RFC 4648 §5), que substitui + por - e / por _, além de remover o padding final com =.

Avalie a Sobrecarga de 33% de Largura de Banda com Data URIs

Embutir recursos como Data URLs elimina requisições HTTP adicionais, mas o Base64 expande o tamanho do arquivo binário em exatamente 33,33% (4 caracteres para cada 3 bytes) e impede o cache independente do navegador. Reserve Data URLs inline para ícones minúsculos e SVGs críticos abaixo de 4 KB; mantenha mídias maiores como recursos externos em cache via HTTP/2 ou HTTP/3.

Automatize o Cálculo de Preenchimento para Base64 Truncado

Se uma API ou log truncar os sinais de igual finais, deduza o padding necessário usando aritmética modular: calcule resto = comprimentoDaString % 4. Se o resto for 2, adicione ==. Se o resto for 3, adicione =. Se o resto for 1, a string está corrompida, pois 6 bits não conseguem reconstruir um octeto completo de 8 bits.

Armadilhas comuns e solução de problemas

⚠️A string a ser decodificada não está codificada corretamente (DOMException / Erro de atob)

A string de entrada contém caracteres fora do alfabeto Base64 (como espaços, quebras de linha ou caracteres codificados por porcentagem em URLs, como %2B). Ative a opção de Limpeza Automática para remover espaços em branco e normalizar hífens/sublinhados, ou verifique se os dados foram codificados com base64url.

⚠️O texto decodificado exibe caracteres ilegíveis (mojibake como é, ü ou símbolos de substituição)

Isso decorre de uma divergência de codificação. O texto original foi convertido a partir de múltiplos bytes UTF-8, mas o decodificador está lendo como ISO-8859-1 (Latin-1), ou vice-versa. Altere o seletor de Codificação de Caracteres de Latin-1/ASCII para UTF-8 para restaurar a reconstrução correta dos caracteres multibyte.

⚠️Erro de comprimento Base64 inválido: comprimento da string módulo 4 é igual a 1

O Base64 agrupa blocos de 6 bits em caracteres; um comprimento codificado com resto 1 mod 4 significa que há apenas 6 bits disponíveis, insuficientes para reconstruir até mesmo um único byte de 8 bits. Isso comprova que a string foi cortada durante a transmissão pela rede ou ao copiar e colar. Obtenha o payload completo diretamente da fonte.

Perguntas frequentes (FAQ)

Como a codificação Base64 gera o acréscimo de 33% no tamanho?▼

A codificação Base64 converte cada 3 bytes (24 bits) de entrada binária em 4 caracteres ASCII (cada um representando 6 bits). Como cada caractere de saída é armazenado como um byte ASCII de 8 bits na memória e via HTTP, 24 bits de entrada transformam-se em 32 bits de saída. Isso gera uma proporção matemática constante de 4/3, resultando em um aumento exato de 33,33% no volume de dados antes de quebras de linha e preenchimentos.

Qual a diferença entre Base64url e a codificação Base64 padrão?▼

O Base64 padrão (RFC 4648 §4) utiliza + e / como o 62º e 63º caracteres do alfabeto e emprega = para preenchimento. Em URLs e nomes de arquivos, + é interpretado como espaço e / atua como separador de caminho. O Base64url (RFC 4648 §5) substitui + por hífen (-) e / por sublinhado (_), além de omitir o preenchimento com = final, garantindo tráfego seguro em query strings e tokens sem necessidade de percent-encoding.

Por que o btoa do JavaScript gera InvalidCharacterError com caracteres Unicode?▼

A função nativa btoa() do navegador foi desenvolvida para strings binárias em que o code point de cada caractere cabe em um único byte de 8 bits (0 a 255). Caracteres Unicode modernos (como emojis, acentos e caracteres asiáticos) utilizam de 2 a 4 bytes em UTF-8. Passar um code point superior a 255 viola as especificações do btoa. Aplicações modernas devem primeiro serializar a string em bytes UTF-8 com TextEncoder antes de executar a conversão para Base64.

Como converter uma string Base64 em uma imagem Data URL exibível no HTML?▼

Para exibir uma imagem Base64 em HTML ou CSS sem hospedar um arquivo externo, adicione o prefixo do tipo de mídia e o marcador base64: data:image/[formato];base64,[dados]. Por exemplo, para um PNG: data:image/png;base64,iVBORw0KGgo... Essa string completa pode ser inserida diretamente no atributo src de uma tag <img> ou na propriedade CSS background-image: url(...).

Quando o preenchimento (=) do Base64 deve ser omitido em web tokens e APIs?▼

O padding com sinal de igual (=) deve ser omitido na criação de JSON Web Tokens (JWTs), tokens de acesso OAuth e identificadores de URL sob as especificações RFC 7515 (JWS) e RFC 4648 §5. Como o decodificador conhece o comprimento exato da string, os bits faltantes são calculados matematicamente (comprimento % 4), tornando o preenchimento redundante e economizando bytes preciosos na URL.

Ferramentas e utilitários relacionados

Todas as ferramentas →