/
Konfidenzintervall Rechner (Z & t)
Inferenzstatistik & HypothesenprüfungStatistische Signifikanz & Stichprobenumfangsrechner

Konfidenzintervall Rechner (Z & t)

Berechnen Sie Konfidenzintervalle und Fehlerspannen für Mittelwerte und Anteile mittels Z- oder Student-t-Verteilung mit interaktiven Kurven und Stichprobenplaner.

Praxis-Szenarien & Vorlagen
95.00%
50%99.99%
Parameter für metrische Mittelwerte
Punktschätzung
12.40
Punktschätzung Mittelwert (x̄)
Fehlerspanne (MoE)
±1.44
95% Statistische Sicherheit
Konfidenzintervall (KI)
[10.96, 13.84]
Zweiseitig (symmetrisch)
Standardfehler (SE)
0.716
t* = 2.015 (Freiheitsgrade (df)=44)
Statistische Zusammenfassung & Kennzahlen
Verteilungsmodell
Verteilungstyp:Student-t-Verteilung (t-Score) (Freiheitsgrade (df) = 44)
Kritischer Wert (z* / t*):2.0154
Signifikanzniveau (α):5.00%
Präzisions- & Fehlermetriken
Basis-Standardfehler (SE₀):0.7155
FPC-Korrekturfaktor:Deaktiviert (n/N ≤ 0,05)
Intervallbreite (2 × MoE):2.884
Verständliche Interpretation im KlartextMit einer statistischen Sicherheit von95liegt der wahre Mittelwert der Grundgesamtheit im Intervall zwischen10.96und13.84.1.44.
Wissenschaftlicher Hinweis & MethodikStatistische Berechnungen dienen Orientierungs- und Analysezwecken. Für klinische Zulassungsstudien, juristische Gutachten oder regulatorische Nachweise sind validierte Biostatistik-Pakete heranzuziehen.
Z- & Student-t-Verteilung
Automatische Methodenwahl zwischen Standardnormal- und t-Verteilung inklusive Welch-Satterthwaite-Freiheitsgraden.
100% DSGVO-konform
Kein Server-Upload – sämtliche Berechnungen laufen ausschließlich lokal im Arbeitsspeicher Ihres Webbrowsers ab.
Zweiseitig & Einseitig
Exakte Intervallgrenzen für symmetrische zweiseitige Intervalle sowie gerichtete obere oder untere Schranken.
Technische Referenz & Architektur-Leitfaden

Konfidenzintervall Rechner (Z & t) — Referenzhandbuch

Berechnen Sie Konfidenzintervalle und Fehlerspannen für Mittelwerte und Anteile mittels Z- oder Student-t-Verteilung. Inklusive Stichprobenrechner und Kurven.

Konfidenzintervall Rechner (Z & t) — Referenzhandbuch — Client-seitige In-Memory-Architektur und Datenfluss

Wichtige Parameter & Einstellungen

Konfidenzniveau (1 - α)Wahrscheinlichkeitsmaß (%)

Der langfristige Anteil wiederholter Zufallsstichproben, deren Intervalle den wahren Populationsparameter tatsächlich enthalten. Typische Branchenstandards: 90 % für explorative Vorstudien, 95 % als wissenschaftlicher und betriebswirtschaftlicher Standard sowie 99 % oder 99,9 % für Hochsicherheitsbereiche wie klinische Pharmakologie und Luft- und Raumfahrt.

Standard: 95%
Stichprobenumfang (n)Ganzzahl (n ≥ 2)

Gesamtzahl unabhängiger Beobachtungen. Steuert die Gültigkeit des Zentralen Grenzwertsatzes (n ≥ 30 bei stetigen Merkmalen; np ≥ 10 und n(1-p) ≥ 10 bei Binomialanteilen) und bestimmt die Freiheitsgrade df = n - 1 bei der Student-t-Verteilung.

Standard: 100
Punktschätzer (x̄ oder p̂)Skalare Stichprobenstatistik

Der erwartungstreue Stichprobenmittelwert (x̄) oder relative Anteilswert (p̂ = x / n) als Mittelpunkt des symmetrischen Konfidenzintervalls, welcher die empirisch beste Schätzung des wahren Parameters der Grundgesamtheit darstellt.

Standard: 50.0
Standardabweichung (s oder σ)Streuungsmaß

Maß für die Streuung in der Grundgesamtheit (σ) oder Stichprobe (s). Ist die wahre Populationsstandardabweichung σ unbekannt (was in über 99 % praktischer Untersuchungen der Fall ist), wird die Stichprobenstandardabweichung s eingesetzt, was kritische Werte der t-Verteilung anstelle des Z-Werts erfordert.

Standard: 10.0
Standardfehler (SE)Standardabweichung der Schätzfunktion

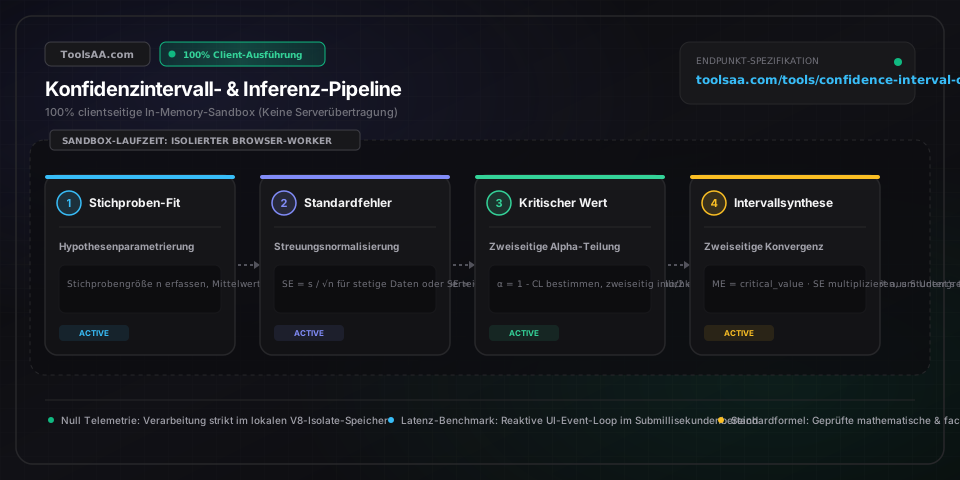
Die Standardabweichung der Stichprobenkennwerteverteilung des Punktschätzers, berechnet als SE = s / √n für Mittelwerte oder SE = √[p̂(1 - p̂) / n] für Anteilswerte. Quantifiziert die zu erwartende Fluktuation der Kennzahl von Stichprobe zu Stichprobe.

Standard: 1.00
Fehlerspanne (E / ME)Konfidenzradius

Die halbe Breite des Konfidenzintervalls, berechnet aus kritischem Wert multipliziert mit dem Standardfehler (E = z* · SE bzw. E = t* · SE). Repräsentiert die maximal erwartete Abweichung zwischen dem wahren Populationsparameter und dem Stichprobenergebnis beim gewählten Konfidenzniveau.

Standard: ±1.96

Profi-Tipps & Best Practices

Die frequentistische Interpretationsfalle: Parameter besitzen keine Wahrscheinlichkeiten

Ein berechnetes 95-%-Konfidenzintervall wie [12,4; 16,8] bedeutet NICHT, dass der wahre Populationsmittelwert mit 95 % Wahrscheinlichkeit in diesem konkreten Zahlenbereich liegt. Der wahre Mittelwert ist eine feste, deterministische Konstante: Er liegt entweder zu 100 % darin oder zu 0 %. Die 95 % beschreiben die Verlässlichkeit der Methode: Zöge man 100 unabhängige Zufallsstichproben und berechnete jeweils das Intervall, würden rund 95 dieser Intervalle den wahren Wert einschließen.

Warum das Wald-Intervall bei Randwerten versagt: Null-Breite und Bereichsverletzung

Die klassische Wald-Formel CI = p̂ ± z*·√[p̂(1-p̂)/n] kollabiert, wenn p̂ nahe 0 oder 1 liegt oder n klein ist. Bei p̂ = 0 wird der Standardfehler 0, was zum unsinnigen Intervall [0, 0] führt. Zudem berechnet die Wald-Approximation oft unzulässige Werte unter 0 % oder über 100 %. Nutzen Sie stattdessen stets das Wilson-Score-Intervall oder die Agresti-Coull-Korrektur ('Plus-Vier-Methode'), die Grenzen strikt innerhalb von [0, 1] garantieren und exakte Überdeckungswahrscheinlichkeiten wahren.

Das Wurzel-n-Gesetz (1/√n) und abnehmender Grenznutzen bei der Stichprobenplanung

Die Fehlerspanne sinkt proportional zu 1/√n und nicht zu 1/n. Um die Fehlerspanne zu halbieren (z. B. von ±4 % auf ±2 %), muss der Stichprobenumfang vervierfacht werden (von 600 auf 2.400). Eine Zehntelung der Fehlerspanne erfordert die 100-fache Datenmenge. In der Budgetplanung müssen die exponentiell steigenden Erhebungskosten gegen den abnehmenden Präzisionsgewinn sorgfältig abgewogen werden.

Endlichkeitskorrektur (FPC): Wenn n/N > 5 % bares Budget einspart

Beim Ziehen ohne Zurücklegen aus einer endlichen Grundgesamtheit mit einem Auswahlsatz von über 5 % (n/N > 0,05) überschätzen Standardformeln den Standardfehler systematisch. Der Korrekturfaktor √[(N - n)/(N - 1)] verkleinert die Fehlerspanne. Bei einer Belegschaft von N = 1.000 sinkt der benötigte Stichprobenumfang von n = 384 unkorrigiert auf n = 278 mit FPC – das spart über 27 % der Befragungskosten bei exakt gleichem 95-%-Konfidenzniveau.

Häufige Fehlerquellen & Fehlerbehebung

⚠️Konfidenzintervall für Anteile unterschreitet 0 % oder überschreitet 100 %

Dies tritt auf, wenn die asymptotische Wald-Normalapproximation auf extreme Anteile (z. B. p̂ < 0,05 oder p̂ > 0,95) bei moderaten Stichproben angewendet wird. Schalten Sie in den Einstellungen auf das 'Wilson-Score-Intervall' oder 'Agresti-Coull' um. Diese mathematischen Modelle begrenzen die Intervallgrenzen zwingend auf den zulässigen Wahrscheinlichkeitsbereich [0, 1].

⚠️Abweichung zwischen kritischem Z-Wert (1,96) und berechnetem Ergebnis

Wenn die Populationsstandardabweichung σ unbekannt ist und durch die Stichprobenstandardabweichung s geschätzt wird, wechselt der Rechner automatisch zur Student-t-Verteilung mit df = n - 1. Bei kleinen Stichproben (z. B. n = 15, df = 14) lautet der kritische Wert t* = 2,145 statt z* = 1,960, da die t-Verteilung dickere Enden (Heavy Tails) besitzt. Erst ab n > 100 konvergiert t* asymptotisch gegen 1,960.

⚠️Umgekehrter Stichprobenplaner liefert unendliche Werte oder NaN

Dies geschieht, wenn die Ziel-Fehlerspanne auf null gesetzt wurde (E = 0) oder die Varianz des Anteils p(1-p) undefiniert ist. Die gewünschte Fehlerspanne muss echt positiv sein (E > 0). Liegt kein Erfahrungswert für den Anteil p vor, wählen Sie p = 0,50. Dies liefert die maximale Varianz (0,25) und garantiert eine konservative, stets abgesicherte Stichprobengröße.

⚠️Starke Schiefe und Nicht-Normalverteilung verletzen den Grenzwertsatz

Im Rohdaten-Modus bei kleinen Fallzahlen (n < 30) mit ausgeprägter Rechtsschiefe oder extremen Ausreißern ist die Normalverteilungsannahme der t-Verteilung verletzt. Prüfen Sie das Diagnosefeld: Übersteigt die Schiefe |1,5|, erhöhen Sie die Stichprobe auf n ≥ 50, damit der Zentrale Grenzwertsatz greift, oder wenden Sie eine logarithmische Transformation auf die Messwerte an.

Häufig gestellte Fragen (FAQ)

Wie berechnet man ein 95-%-Konfidenzintervall für einen Mittelwert?▼

Ein 95-%-Konfidenzintervall für den Mittelwert wird mit der Formel KI = x̄ ± (t* · s / √n) berechnet, wenn die Standardabweichung der Population unbekannt ist, bzw. KI = x̄ ± (z* · σ / √n), falls σ bekannt ist. Hierbei ist x̄ der Stichprobenmittelwert, s die Stichprobenstandardabweichung, n der Stichprobenumfang und t* der kritische Wert der t-Verteilung für df = n - 1 bei beidseitigem α = 0,05 (für n > 100 gilt z* = 1,960). Beispiel: Bei x̄ = 50, s = 10 und n = 25 (df = 24, t* = 2,064) beträgt der Standardfehler 10 / √25 = 2,0, woraus sich eine Fehlerspanne von 2,064 · 2,0 = 4,13 und ein Intervall von [45,87; 54,13] ergibt.

Welchen Stichprobenumfang benötigt man für 3 % Fehlerspanne bei 95 % Konfidenz?▼

Für eine unendliche Grundgesamtheit mit unbekanntem Anteilswert (unter der konservativen Annahme maximaler Varianz p = 0,5) werden exakt n = 1.068 Befragte benötigt. Die Formel lautet n = (z*² · p(1 - p)) / E² = (1,960² · 0,5 · 0,5) / 0,03² = 0,9604 / 0,0009 = 1.067,11, was kaufmännisch auf 1.068 aufgerundet wird. Bei einer bekannten endlichen Population von N = 10.000 sinkt der Bedarf durch die Endlichkeitskorrektur (FPC) auf n = 965 Personen.

Was ist der Unterschied zwischen einem Z-Wert- und einem T-Wert-Konfidenzintervall?▼

Das Z-Intervall basiert auf der Standardnormalverteilung und setzt eine bekannte Standardabweichung der Grundgesamtheit (σ) oder sehr große Stichproben (n > 100) voraus. Das T-Intervall basiert auf der Student-t-Verteilung und ist zwingend erforderlich, wenn σ unbekannt ist und aus der Stichprobe (s) geschätzt wird. Da das Schätzen von σ zusätzliche Unsicherheit einbringt, weist die t-Verteilung breitere Ränder auf und liefert höhere kritische Werte (z. B. t* = 2,228 bei df = 10 gegenüber z* = 1,960), was zu realistischeren, breiteren Intervallen bei kleinen Stichproben führt.

Bedeutet ein 95-%-Konfidenzintervall, dass der wahre Wert zu 95 % im Intervall liegt?▼

Nein. In der klassischen frequentistischen Statistik ist der wahre Populationsparameter eine feste, wenn auch unbekannte Konstante und keine Zufallsvariable. Die Wahrscheinlichkeit, dass der wahre Wert in einem konkret berechneten Intervall (wie [10,2; 14,8]) liegt, beträgt daher entweder genau 1 oder 0. Das 95-%-Niveau beschreibt die Zuverlässigkeit des Verfahrens: Würde man unendlich oft Stichproben aus derselben Population ziehen, würden exakt 95 % aller so gebildeten Intervalle den wahren Parameter einschließen und 5 % ihn verfehlen.

Verwandte Tools & Hilfsprogramme

Alle Tools →