Calcule intervalos de confianza y margen de error para medias y proporciones muestrales con distribución Z y t de Student. Incluye curvas interactivas y cálculo de tamaño muestral.
Calcula intervalos de confianza y margen de error para medias y proporciones muestrales mediante distribución Z o t de Student. Incluye curvas interactivas y cálculo de tamaño muestral.
Proporción a largo plazo de intervalos aleatorios repetidos que contendrán el verdadero parámetro poblacional. Convenciones habituales: 90 % para investigación exploratoria preliminar, 95 % como estándar académico, empresarial y biomédico, y 99 % o 99,9 % en farmacología clínica crítica e ingeniería aeroespacial.
Número total de observaciones independientes recogidas. Gobierna el umbral de convergencia del Teorema Central del Límite (n ≥ 30 para variables continuas; np ≥ 10 y n(1-p) ≥ 10 para proporciones binomiales) y determina los grados de libertad gl = n - 1 en la distribución t de Student.
Media muestral insesgada (x̄) o proporción muestral (p̂ = x / n) que actúa como punto medio del intervalo de confianza simétrico, representando la estimación empírica óptima del verdadero parámetro poblacional.
Medida de variabilidad en la población (σ) o en la muestra (s). Si se desconoce la desviación típica poblacional σ (caso que ocurre en más del 99 % de los estudios reales), se sustituye por la desviación típica muestral s, lo que exige emplear valores críticos de la t de Student en lugar de la normal estándar Z.
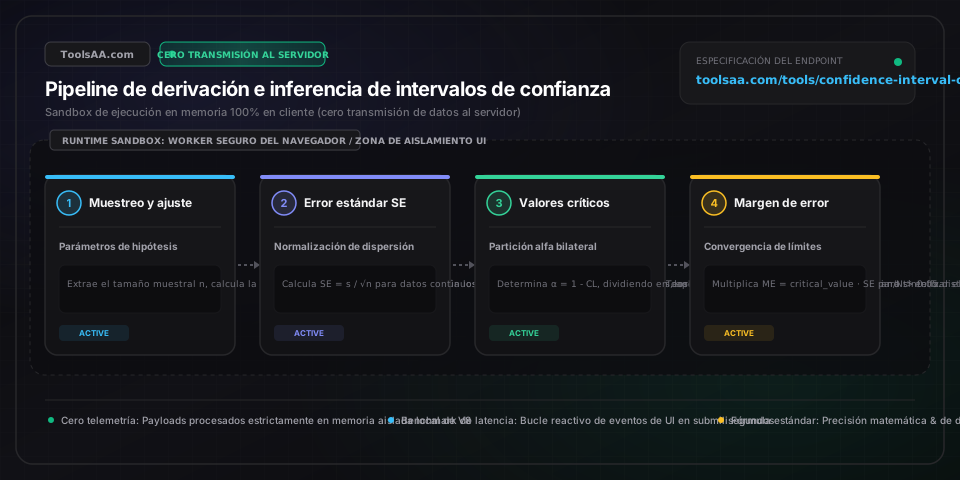
Desviación típica de la distribución muestral del estimador puntual, calculada como EE = s / √n para medias, o EE = √[p̂(1 - p̂) / n] para proporciones. Cuantifica cuánto fluctúa el estadístico muestral de una muestra aleatoria a otra.
Semiamplitud del intervalo de confianza, obtenida multiplicando el valor crítico por el error estándar (E = z* · EE o E = t* · EE). Representa la máxima diferencia esperada entre el parámetro poblacional real y la estimación muestral para el nivel de confianza fijado.
Un intervalo de confianza calculado al 95 % como [12,4, 16,8] NO significa que haya un 95 % de probabilidad de que la verdadera media poblacional se encuentre entre esas dos cifras concretas. La media real es una constante fija y no aleatoria: o se encuentra al 100 % dentro o al 0 % dentro. El valor del 95 % describe la fiabilidad del procedimiento metodológico: si se extrajeran 100 muestras aleatorias independientes y se calcularan 100 intervalos, aproximadamente 95 de ellos contendrían el verdadero parámetro.
La fórmula clásica de Wald de los manuales, IC = p̂ ± z* · √[p̂(1 - p̂) / n], colapsa cuando p̂ se aproxima a 0 o a 1, o cuando n es pequeño. Si p̂ = 0, el error estándar se anula, dando lugar a un intervalo absurdo de amplitud cero [0, 0]. Asimismo, suele generar límites inferiores negativos (< 0 %) o superiores por encima del 100 %. Emplea siempre el intervalo de puntuación de Wilson (Wilson Score) o el ajuste de Agresti-Coull ('plus four'), que aseguran matemáticamente límites válidos dentro de [0, 1] y mantienen una cobertura empírica exacta.
El margen de error disminuye de forma proporcional a 1/√n, nunca de manera lineal (1/n). Para reducir el margen de error a la mitad (por ejemplo, del ±4 % al ±2 %), es indispensable cuadruplicar el tamaño muestral de 600 a 2.400 observaciones. Para reducirlo por un factor de 10, se necesitaría multiplicar el volumen muestral por 100. Los equipos de planificación deben sopesar el coste exponencial de recopilación de datos frente al beneficio marginal en precisión estadística.
Al realizar un muestreo sin reposición en una población finita donde la fracción muestral supera el 5 % (n/N > 0,05), las fórmulas habituales sobreestiman sistemáticamente el error estándar. La aplicación del multiplicador FPC √[(N - n) / (N - 1)] reduce el margen de error. En una organización de N = 1.000 empleados, un tamaño muestral sin corregir de n = 384 desciende a n = 278 aplicando FPC, ahorrando más de un 27 % en costes de administración de encuestas sin perder el 95 % de confianza rigurosa.
Ocurre al aplicar la aproximación normal asintótica de Wald a proporciones extremas (por ejemplo, p̂ < 0,05 o p̂ > 0,95) con tamaños muestrales moderados. Cambia el método de cálculo en el selector de opciones a 'Intervalo de puntuación de Wilson' o 'Agresti-Coull', que restringen matemáticamente los límites del intervalo estrictamente dentro del rango de probabilidad legítimo [0, 1].
Cuando la desviación típica poblacional σ es desconocida y se estima a partir de la desviación típica muestral s, la calculadora conmuta automáticamente a la distribución t de Student con gl = n - 1. En muestras pequeñas (por ejemplo, n = 15, gl = 14), el valor crítico es t* = 2,145 en lugar de z* = 1,960 debido a las colas más pesadas de la distribución t. Al superar n = 100, t* converge asintóticamente hacia 1,960.
Sucede cuando el margen de error objetivo se establece en cero (E = 0) o la varianza de la proporción p(1 - p) queda indefinida. El margen de error debe ser estrictamente positivo (E > 0). Si careces de una estimación previa de la proporción poblacional p, fija p = 0,50, lo que genera la máxima varianza posible (0,25) y garantiza una estimación del tamaño muestral segura y conservadora.
Al utilizar el modo de datos sin procesar con muestras reducidas (n < 30) que exhiben una marcada asimetría hacia la derecha o valores atípicos severos, se invalida el supuesto de normalidad de la distribución t de Student. Examina el panel de métricas automáticas: si el coeficiente de asimetría supera |1,5|, amplía la muestra hasta n ≥ 50 para que el Teorema Central del Límite restaure la normalidad, o aplica una transformación logarítmica a los datos observados.
Un intervalo de confianza del 95 % para la media muestral se calcula mediante la fórmula IC = x̄ ± (t* · s / √n) cuando se desconoce la desviación típica poblacional, o IC = x̄ ± (z* · σ / √n) cuando σ es conocida. Aquí, x̄ es la media muestral, s es la desviación típica de la muestra, n es el tamaño muestral y t* es el valor crítico de la distribución t de Student para gl = n - 1 con un nivel de significación bilateral α = 0,05 (para muestras grandes n > 100, z* = 1,960). Por ejemplo, con x̄ = 50, s = 10 y n = 25 (gl = 24, t* = 2,064), el error estándar es 10 / √25 = 2,0, lo que proporciona un margen de error de 2,064 · 2,0 = 4,13 y un intervalo final de [45,87, 54,13].
Para una población infinita con proporción desconocida (aplicando el supuesto conservador de máxima varianza p = 0,5), se requieren exactamente n = 1.068 encuestados. La fórmula matemática es n = (z*² · p(1 - p)) / E² = (1,960² · 0,5 · 0,5) / 0,03² = 0,9604 / 0,0009 = 1.067,11, que se redondea siempre al siguiente entero superior (1.068). Si el muestreo procede de una población finita conocida de N = 10.000 individuos, aplicar el factor de corrección por población finita (FPC) reduce el tamaño muestral necesario a n = 965 personas.
El intervalo Z se basa en la distribución normal estándar y se utiliza cuando la desviación típica de la población (σ) es conocida o cuando el tamaño muestral es muy grande (n > 100). El intervalo T recurre a la distribución t de Student y es preceptivo siempre que se desconozca σ y deba estimarse mediante la desviación típica muestral (s). Como estimar σ introduce incertidumbre estadística adicional, la distribución t de Student cuenta con colas más densas y arroja valores críticos superiores (por ejemplo, para gl = 10 al 95 % de confianza, t* = 2,228 frente a z* = 1,960), produciendo intervalos de confianza más anchos y realistas en muestras reducidas.
No. En estadística frecuentista, la media poblacional verdadera es un valor fijo y constante, no una variable estocástica o aleatoria. Por tanto, la probabilidad de que la media real quede comprendida en un intervalo numérico específico ya calculado (como [10,2, 14,8]) es estrictamente 0 o 1 (o está dentro, o no está). El nivel de confianza del 95 % alude a la tasa de acierto del método a largo plazo: al extraer infinitas muestras aleatorias de la misma población, exactamente el 95 % de los intervalos construidos contendrá el parámetro real, mientras que el 5 % restante no lo alcanzará.
Calcula la depreciación del coche y el valor de reventa según año y kilometraje. Estima curvas de valor residual a 5 años, equidad frente al préstamo y coste total.
Calcula el gasto eléctrico y la factura de la luz por electrodoméstico. Estima el consumo en kWh, compara costes de uso y proyecta tu recibo mensual.
Convierte unidades de presión al instante entre PSI, bar, kPa, Pascal, atm y mmHg. Conversor preciso de presión manométrica y absoluta con matriz de profundidad.
Convierte torque al instante entre newton metros (Nm), libras-pie (ft-lb), libras-pulgada (in-lb) y kgf-m con cálculo de apriete de pernos, palanca y RPM de motor.
Calcula tus necesidades diarias de electrolitos (sodio, potasio y magnesio) según tu tasa de sudoración, intensidad de ejercicio, calor, dieta keto y pérdida de agua.
Calcula el tiempo de recarga, el coste eléctrico y la autonomía añadida para coches eléctricos en Nivel 1, Nivel 2 y carga rápida CC. Incluye curva de reducción al 80%, límite del cargador embarcado (OBC) y ahorro frente a gasolina.