HTML zu Markdown Konverter (GFM)
HTML zuverlässig in GitHub Flavored Markdown (GFM) mit Tabellen und Code-Blöcken konvertieren. Inline-Styles bereinigen und saubere MD-Dateien exportieren.
Keine Ausgabe generiert
HTML zuverlässig in GitHub Flavored Markdown (GFM) mit Tabellen und Code-Blöcken konvertieren. Inline-Styles bereinigen und saubere MD-Dateien exportieren.
Keine Ausgabe generiert
HTML sekundenschnell in sauberes Markdown (GFM) mit Tabellen, Code-Blöcken und Bildern umwandeln. Bereinigt Web-Tags und kopiert reines MD lokal im Browser.
Steuert die AST-Serialisierung von Überschriften gemäß CommonMark-Spezifikation §4.2. ATX-Hashes (# H1 bis ###### H6) garantieren deterministische Token-Grenzen ohne das Risiko unbeabsichtigter Absatzverschmelzungen oder Setext-Unterstreichungskollisionen.
Definiert die Spaltenausrichtungs-Begrenzer in Zeile 2 von GitHub Flavored Markdown (GFM §4.10) Tabellen. Mappt Inline-CSS (text-align) sowie HTML-align-Attribute präzise auf Doppelpunkt-Anker (:--- linksbündig, :---: zentriert, ---: rechtsbündig).
Extrahiert Syntax-Highlighting-Klassentoken (z. B. class="language-typescript", class="highlight-source-python") aus verschachtelten <pre><code>-DOM-Knoten und hängt CommonMark §4.5 Info-Strings direkt an die öffnenden Backtick-Zäune an.
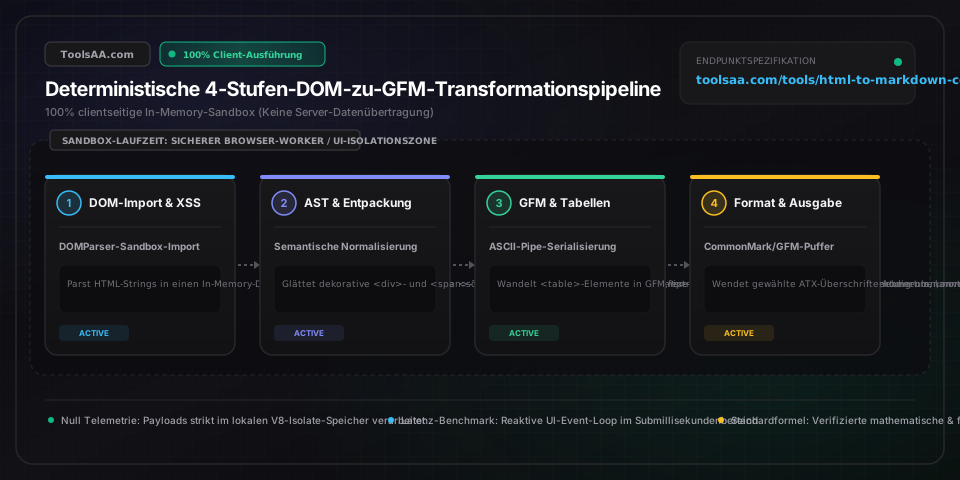
Entfernt aktive Skripte und inhaltsfremde DOM-Teilbäume (<script>, <style>, <iframe>, <object>, <nav>, <noscript>) während des O(n)-Tiefendurchlaufs. Nicht-semantische <div>- und <span>-Wrapper werden bereinigt, während der innere Text erhalten bleibt.
Dekodiert benannte (©, &), dezimale ( ) und hexadezimale (—) HTML-Entities in standardmäßige UTF-8-Zeichen. Aktive CommonMark-Steuerzeichen (\*, \_, \`, \#, \|) werden automatisch maskiert, um Parsing-Kollisionen zu verhindern.
Steuert die Serialisierung von Anchor- (<a>) und Bildknoten (<img>). Die Inline-Syntax platziert Ziel-URLs direkt neben dem Ankertext; die Referenz-Syntax generiert konsolidierte Fußnoten-Dictionaries am Dokumentende zur Optimierung der Token-Dichte.
Standard-GFM-Pipe-Tabellen erfordern, dass jede Tabellenzeile auf einer einzigen physischen Zeile verbleibt; unmaskierte Newline-Zeichen (\n oder \r\n) zerstören das Tabellen-Parsing sofort. Ersetzen Sie <br> und Block-Elemente (<p>, <div>) innerhalb von <td>-Zellen durch Inline-<br />-Tags oder Leerzeichen, um das Tabellenlayout zu wahren.
GFM-Tabellenparser trennen Spalten anhand von Pipe-Zeichen (|) noch bevor Inline-Backtick-Abschnitte ausgewertet werden. Enthält eine Zelle Shell-Befehle oder bitweise Operatoren (z. B. `cat file | grep key`), maskieren Sie die Pipe als \| oder kapseln Sie den Code in doppelte Backticks mit Leerzeichen (`` `cat | grep` ``), um ein versehentliches Aufspalten der Spalten zu verhindern.
CommonMark §5.2 schreibt vor, dass Unterblöcke innerhalb von Listenelementen (Unterlisten, Blockquotes oder Fenced Code) bündig zum ersten Nicht-Leerzeichen nach dem Listenmarker eingerückt werden (in der Regel 4 Leerzeichen oder 1 Tab). Ein 2-Leerzeichen-Einzug führt bei strikten Parsern zu einem vorzeitigen Abbruch der Liste.
Syntax-Highlighter (wie Prism.js oder Highlight.js) hinterlegen Sprachbezeichner oft im übergeordneten <pre class="brush: js"> oder untergeordneten <code class="language-python">. Stellen Sie sicher, dass die Sprach-Token-Extraktion beide Knoten per Regex ((?:lang|language)-([a-zA-Z0-9_-]+)) scannt, bevor nicht-semantische Attribute verworfen werden.
GFM §4.10 verlangt eine strukturelle Trennzeile unmittelbar unterhalb der Kopfzeile (| :--- | ---: |) mit exakt übereinstimmender Spaltenanzahl. Prüfen Sie, ob die Quelltabelle ein semantisches <thead> oder eine eindeutige erste <tr> mit <th>-Zellen enthält, und stellen Sie sicher, dass zellinterne Zeilenumbrüche zu <br /> normalisiert werden.
Tritt auf, wenn das Quell-HTML auf gestylte <div>- oder <p>-Tags mit CSS white-space: pre setzt, statt semantische <pre><code>-Tags zu nutzen. Transformieren Sie Container vor dem AST-Durchlauf in semantische <pre>-Elemente oder aktivieren Sie eine CSS-bewusste Whitespace-Extraktion, um Zeilenumbrüche und Einrückungen beizubehalten.
DOM-Konverter behalten unbekannte Elemente oder Tags mit komplexen Inline-Stilen oft als rohes HTML bei. Aktivieren Sie im Parser das strikte Entpacken nicht-semantischer Wrapper (Unwrapping), um Container-Tags rekursiv zu entfernen, während alle Textknoten und gültigen Inline-Elemente (<em>, <strong>, <a>) intakt bleiben.
Bei der Konvertierung von HTML-Tabellen in GitHub Flavored Markdown (GFM) müssen <th>-Zellen in Spaltenköpfe überführt, eine Trennzeile mit Ausrichtungsdoppelpunkten (| :--- | :---: | ---: |) eingefügt und alle Zeilenumbrüche innerhalb von Zellen in <br />-Tags umgewandelt werden. Standardmäßige GFM-Pipe-Tabellen verlangen zwingend, dass jede Zeile genau eine ununterbrochene physische Textzeile belegt; unbehandelte Zeilenumbrüche (\r\n) in <td>-Elementen zerreißen die Tabellenstruktur sofort in isolierte Textfragmente. Inline-Ausrichtungsattribute (align="left|center|right") oder CSS-Eigenschaften (style="text-align: *") müssen geparst und in die Doppelpunkt-Marker der zweiten Zeile übertragen werden.
CommonMark ist die formale Basisspezifikation, die die Markdown-Kernsyntax (RFC 7764) standardisiert. GitHub Flavored Markdown (GFM) hingegen ist eine strikte Obermenge (Superset), die native Spezifikationen für Pipe-Tabellen (§4.10), Aufgabenlisten (§5.3), Durchstreichungen (§6.5), automatische Linkerkennung (§6.9) und sprachspezifische Fenced-Code-Blöcke ergänzt. Während reines CommonMark Pipe-Zeichen (|) als einfachen Text interpretiert und Tabellenstrukturen in unformatierte Absätze umwandelt, parst GFM tabellarische Daten in strukturierte Matrizen, wie sie in modernen Repositories, Dokumentations-Engines und Wikis Standard sind.
Um das Syntax-Highlighting beizubehalten, müssen Sprachbezeichner aus den HTML-Klassenattributen (z. B. class="language-typescript", class="lang-python" oder class="highlight-source-sql") der <pre>- oder <code>-Tags ausgelesen und als Info-String direkt hinter die öffnenden dreifachen Backticks (```typescript) gesetzt werden. Verwendet das Quell-HTML rein span-basierte Stile ohne Klassenannotationen, prüfen moderne AST-Parser übergeordnete Datenattribute wie data-language oder data-lang, um konforme Fenced-Code-Blöcke nach CommonMark §4.5 zu rekonstruieren.
Verschachtelte <div>- und <span>-Elemente verursachen unsauberes Markdown, da es sich um rein visuelle Container ohne syntaktisches Äquivalent in CommonMark handelt. Parser neigen dazu, diese entweder als rohe HTML-Tags durchzureichen oder überflüssige Zeilenumbrüche zu generieren. Fehlt der Konvertierungs-Engine ein semantisches AST-Unwrapping, führen solche Tags zu redundanten Absatzwechseln, doppelten Abständen und verwaisten Steuerzeichen. Eine rekursive DOM-Bereinigung in O(n) flacht die Containertiefe ab und bewahrt gleichzeitig den eigentlichen Textinhalt.
Die Konvertierung von gecrawltem Web-HTML in bereinigtes Markdown senkt den Token-Verbrauch in LLM-Prompts typischerweise um 55 % bis 75 %. Dabei werden überflüssige Boilerplate-DOM-Knoten (<nav>, <header>, <footer>, <script>, <style>) und aufgeblähte CSS-Klassennamen eliminiert und verschachtelte Tags durch kompakte Markdown-Syntax ersetzt. Diese hohe Informationsdichte schont das Kontextfenster, verringert die Inferenz-Latenz und steigert die Vektoreinbettungsqualität bei RAG-Pipelines (Retrieval-Augmented Generation) durch die Eliminierung von syntaktischem Rauschen signifikant.
Vergleichen Sie Text, Code und Dateien mit unserem schnellen Diff-Checker. Prüfen Sie Side-by-Side- oder Inline-Änderungen auf Zeichenebene, ignorieren Sie Leerzeichen und exportieren Sie Unified Diffs.
Erstellen Sie gültige rel=canonical-Tags und HTTP-Header mit unserem Canonical-Tag-Generator. Entfernen Sie Tracking-Parameter, normalisieren Sie URLs und beheben Sie Duplicate-Content-Probleme im SEO.
cURL-Befehle sofort in moderne Fetch-API-Syntax umwandeln. HTTP-Header, Auth-Tokens, Cookies und JSON-Payloads in asynchronen JavaScript-Code parsen.
XML-Sitemaps und Sitemap-Indexdateien sofort validieren. Prüfung auf 50.000-URL-Limits, W3C-Datetime-Syntax, hreflang-Attribute, Medienschemata und Google Search Console-Fehler.
Google-Suchergebnisse für Desktop und Mobilgeräte pixelgenau simulieren: Inklusive Abschneidegrenzen, Rich-Snippet-Schema, Sitelinks und Live-CTR-Analyse.
Erstellen Sie mehrpunktige CSS-Mesh-Gradients, animierte Hintergründe und SVG-Farbnetze. Passen Sie Kontrollpunkte und Filmkorn an und kopieren Sie CSS- oder Tailwind-Code.