Diff Checker & Text-Vergleichstool

Diff Checker & Text-Vergleichstool

Echtzeit-Myers-Diff-Engine

Vergleichen Sie Text, Code und Dateien mit unserem schnellen Diff-Checker. Prüfen Sie Side-by-Side- oder Inline-Änderungen auf Zeichenebene, ignorieren Sie Leerzeichen und exportieren Sie Unified Diffs.

Vorlagen
Myers-LCS-Berechnungspipeline
Myers-Ähnlichkeitsrate69.6%Myers-Edit-Distanz (D)8
EingabeaufnahmeCRLF→LF • NormalizedNormalisierungD = 8 (O(ND))Myers-LCS-EngineWortweiseIntra-Line-Micro-Diff+5 / -3 (2 hunks)
Vergleichsgranularität
Originaler Quellpuffer: 11L • 21W • 193C|Modifizierter Zielpuffer: 12L • 24W • 237C
LF
1/2
1{
2 "status": 200,
3 "service": "auth-gateway",
4 "version": "1.4.2",
5 "features": ["oauth2", "jwt", "rate-limit"],
6 "timeoutMs": 5000,
7 "cache": {
8 "enabled": true,
9 "ttl": 3600
10 }
11}
1{
2 "status": 200,
3 "service": "auth-gateway",
4
5 "version": "1.5.limit"],
6 "features": ["oauth2", "jwt", "rate-limit", "mfa-totp,
7 "timeoutMs": 3000,
8 "cache": {
9 "enabled": true,
10 "ttl": 7200,
11 "ttl": 3600
12 }
13}
+5-3|2 Diff-Abschnitte
Wortweise|69.6% Myers-Ähnlichkeitsrate
Myers-Ähnlichkeit
69.6%
Levenshtein-Myers-Ähnlichkeitswert
Erkannte Änderungen
+5 / -3
2 Zusammenhängende Änderungsblöcke
Diff-Abschnitte
Speicheroptimiert O(ND)
Null Telemetrie

Clientseitige Verarbeitung

Hochleistungsberechnung direkt im Browserspeicher ohne Serverlatenz.

Zero-Server-Upload-Datenschutz

Alle Nutzdaten verbleiben strikt lokal ohne externe Serverkommunikation.

Produktionsreifer Export

Saubere, optimierte Ausgabeformate für den sofortigen Produktiveinsatz.
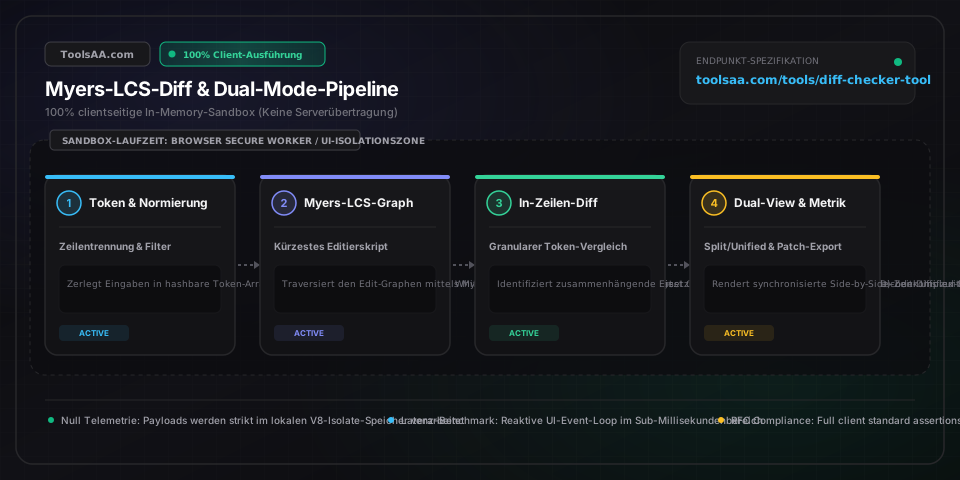
Technische Referenz & Architektur-Leitfaden

Diff-Checker & Text-Vergleich — Referenzhandbuch

Vergleichen Sie Texte, Code und Dateien mit unserem schnellen Diff-Checker. Prüfen Sie synchrone Side-by-Side- oder Inline-Änderungen auf Zeichenebene, ignorieren Sie Whitespaces und exportieren Sie standardkonforme Unified-Diffs.

Diff-Checker & Text-Vergleich — Referenzhandbuch — Client-seitige In-Memory-Architektur und Datenfluss

Wichtige Parameter & Einstellungen

Diff-Granularität (diffGranularity)String (lines | words | chars)

Definiert die Tokenisierungs-Auflösung für den Myers-Edit-Graphen. Der Zeilenmodus (lines) segmentiert anhand von Zeilenumbrüchen (\n) für syntaktische Code-Diffs; der Wortmodus (words) tokenisiert entlang von Unicode-Wortgrenzen (\b) für redaktionelle Textvergleiche; der Zeichenmodus (chars) führt atomare UTF-16-Codepoint-Vergleiche für kryptografische Hashes und Token durch.

Standard: words
Ansichtsmodus (viewMode)String (split | unified)

Steuert die visuelle Layout-Darstellung. 'split' rendert eine synchrone zweispaltige Gegenüberstellung (Side-by-Side) mit Viewport-Scroll-Verankerung; 'unified' erzeugt eine einspaltige, POSIX-konforme Patch-Ansicht mit Hunk-Trennzeichen (@@ -l,s +l,s @@) gemäß IEEE Std 1003.1.

Standard: split
Whitespace ignorieren (ignoreWhitespace)Boolean

Normalisiert Whitespace-Token vor der Konstruktion des kürzesten Edit-Skripts (Shortest Edit Script). Entfernt Wagenrückläufe (\r\n zu \n), fasst aufeinanderfolgende Leerzeichen und Tabulatoren zu einzelnen Trennzeichen zusammen und schneidet nachgestellte Leerzeichen ab, um rein kosmetische Formatierungsunterschiede zu eliminieren.

Standard: true
Groß-/Kleinschreibung ignorieren (ignoreCase)Boolean

Wendet vor dem Myers-Diagonalendurchlauf ein Case-Folding mittels vollständigem Unicode-Case-Mapping an. Groß- und Kleinbuchstaben werden als identische Token behandelt, während die originale Schreibweise in den gerenderten Hunks zur visuellen Darstellung erhalten bleibt.

Standard: false
Ähnlichkeitswert (similarityScore)Number (Prozentsatz 0,0 - 100,0 %)

Normalisierter semantischer Ähnlichkeitskoeffizient, berechnet über die Dice-Sørensen-Metrik: (2 × |LCS|) / (|A| + |B|) × 100 %. Werte >= 80 % deuten auf geringfügige Überarbeitungen hin, 50–79 % kennzeichnen substanzielle Refactorings und < 30 % signalisieren eine nahezu vollständige inhaltliche Divergenz.

Standard: 100.0%

Profi-Tipps & Best Practices

Wort-Granularität für Verträge und redaktionelle Korrekturen nutzen

Schalten Sie beim Abgleich von Verträgen, NDAs oder Markdown-Dokumentationen von der Zeilen- auf die Wort-Granularität um. Ein zeilenbasierter Myers-Diff markiert einen gesamten Absatz mit 200 Wörtern als vollständige Löschung und Neueinfügung, selbst wenn nur ein Satzzeichen oder ein Datum geändert wurde. Die Tokenisierung auf Wortebene hebt dagegen exakt das veränderte Wort in kontrastreichen smaragdgrünen und rosafarbenen Spalten hervor.

Fehlalarme durch Whitespace-Normalisierung eliminieren

Bei plattformübergreifender Zusammenarbeit treten häufig unsichtbare Diskrepanzen bei Zeilenumbrüchen (Windows-CRLF '\r\n' vs. Unix-LF '\n') sowie Drift zwischen Leerzeichen- und Tabulator-Einrückungen auf. Durch Aktivieren von 'Whitespace ignorieren' werden Wagenrückläufe entfernt und Leerzeichenfolgen zusammengefasst, sodass echte semantische Logikänderungen sauber von funktionslosen Formatierungsunterschieden isoliert werden.

Saubere Patches für Git- und CI/CD-Pipelines exportieren

Wechseln Sie vor dem Herunterladen von .patch-Dateien in den Ansichtsmodus 'unified'. Die Ausgabe folgt strikt dem POSIX IEEE Std 1003.1- und RFC-Unified-Diff-Format mit gültigen zweizeiligen Dateiköpfen ('--- a/original' und '+++ b/modified') sowie standardisierten Hunk-Headern ('@@ -k,l +m,n @@'). Dadurch lässt sich der Patch unmittelbar via 'git apply patch.diff' oder 'patch -p1' einspielen.

SVG-Minimap für die schnelle Prüfung langer Dokumente nutzen

Nutzen Sie bei der Analyse von Dateien mit mehr als 1.000 Zeilen die SVG-Diff-Minimap am rechten Rand. Farbige Markierungslinien berechnen proportionale vertikale Koordinaten (y = lineIndex / totalLines * canvasHeight) und ermöglichen eine Ein-Klick-Navigation direkt zu einzelnen Änderungen, ohne mühsam durch den gesamten DOM-Baum scrollen zu müssen.

Häufige Fehlerquellen & Fehlerbehebung

⚠️Das gesamte Dokument wird trotz identischem Inhalt als gelöscht und neu eingefügt markiert.

Dies geschieht bei unterschiedlichen Zeilenumbruch-Standards verschiedener Betriebssysteme (Windows CRLF '\r\n' vs. Unix LF '\n') oder abweichenden UTF-8-BOM-Byte-Order-Marks (0xEF, 0xBB, 0xBF). Aktivieren Sie 'Whitespace ignorieren', um Carriage Returns bei der lexikalischen Tokenisierung herauszufiltern, oder normalisieren Sie Zeilenumbrüche vor dem Diff-Lauf auf '\n'.

⚠️Der zeichengenaue Diff arbeitet bei riesigen minifizierten JavaScript- oder einzeiligen JSON-Dateien träge.

Der zeichenweise Vergleich weist eine Worst-Case-Zeitkomplexität von O((N+M)D) auf, wobei D für die Edit-Distanz steht. Schalten Sie bei einzeiligen komprimierten Dateien mit mehr als 50.000 Zeichen die Granularität auf 'Zeilen' (lines) um oder strukturieren Sie das JSON vorab mit einem Formatierer (Pretty-Printer), bevor Sie den Vergleich starten.

⚠️Das synchrone Scrollen zwischen den beiden Bereichen gerät bei langen Absätzen aus dem Takt.

Die Split-View-Bereiche richten Inhalte über eine virtuelle Zeilenverankerung anhand von Myers-Lösch- und Einfüge-Hunk-Paaren aus. Wenn ein Dokument große asymmetrische Einfügungen enthält, stellen Sie sicher, dass die synchrone Scroll-Sperre ('Side-by-Side Lock') aktiv ist; das Werkzeug fügt automatisch virtuelle Platzhalter-Gutter auf der gegenüberliegenden Seite ein, um die parallele Ausrichtung beizubehalten.

Häufig gestellte Fragen (FAQ)

Wie berechnet der Myers-Diff-Algorithmus Zeileneinfügungen und -löschungen?▼

Der Myers-Diff-Algorithmus modelliert den Textvergleich als Suche nach dem kürzesten Pfad in einem Edit-Graphen, bei dem horizontale Schritte Löschungen und vertikale Schritte Einfügungen repräsentieren. Durch eine Greedy-Suche entlang diagonaler Pfade, die übereinstimmende Token darstellen, ermittelt der Algorithmus die längste gemeinsame Teilsequenz (Longest Common Subsequence, LCS) und erzeugt das minimal mögliche Edit-Skript in einer Laufzeit von O((N+M)D), wobei N und M die Dokumentlängen und D die Edit-Distanz angeben.

Was ist der Unterschied zwischen einem Unified-Diff und einem Side-by-Side-Split-Diff?▼

Ein Side-by-Side-Split-Diff stellt Original- und modifizierten Text in zwei parallelen Spalten nebeneinander dar und synchronisiert das Scrollen für den direkten visuellen Abgleich. Ein Unified-Diff fasst beide Versionen in einer einzigen fortlaufenden Spalte zusammen: Unveränderte Kontextzeilen werden zusammen mit gelöschten Zeilen (mit '-' Präfix in Rot) und hinzugefügten Zeilen (mit '+' Präfix in Grün) dargestellt – exakt nach dem Standardformat, das von Git, GitHub und Terminal-Patch-Werkzeugen verwendet wird.

Wie ignoriere ich Whitespace-Änderungen und Carriage Returns beim Textvergleich?▼

Aktivieren Sie die Option 'Whitespace ignorieren' in der Konfigurationsleiste. Dadurch filtert der Präprozessor Wagenrückläufe heraus (CRLF zu LF), entfernt nachgestellte Leerzeichen an Zeilenenden und fasst mehrere aufeinanderfolgende Leerzeichen oder Tabulatoren zu einem einzigen Trennzeichen zusammen. So werden echte Code- und Inhaltsänderungen zuverlässig von reinen Formatierungsunterschieden getrennt.

Kann ich mit diesem Diff-Checker standardkonforme Git-Patch-Dateien erzeugen?▼

Ja. Das Werkzeug generiert RFC- und POSIX-konforme Unified-Diff-Patch-Dateien. Wechseln Sie in die Ansicht 'Unified Diff' oder klicken Sie auf 'Export .patch', um eine saubere Textdatei mit standardisierten Dateiköpfen ('--- a/original', '+++ b/modified') und Hunk-Headern ('@@ -1,5 +1,6 @@') herunterzuladen, die direkt mit dem Terminal-Befehl 'git apply' eingespielt werden kann.

Wie wird der prozentuale Ähnlichkeitswert bei der Diff-Analyse berechnet?▼

Der Ähnlichkeitswert wird über den Dice-Sørensen-Koeffizienten auf Basis der längsten gemeinsamen Teilsequenz (LCS) des Myers-Algorithmus ermittelt: Ähnlichkeit = (2 × |LCS|) / (|Original-Token| + |Modifizierte Token|) × 100 %. Eine exakte Übereinstimmung ergibt 100,0 %, während völlig disjunkte Dokumente einen Wert von 0,0 % aufweisen.

Verwandte Tools & Hilfsprogramme

Alle Tools →