Comparateur de Texte & Diff Checker

Comparateur de Texte & Diff Checker

Moteur diff 100 % côté client

Comparez vos textes, codes et fichiers avec notre comparateur de diff instantané. Visualisez les écarts côte à côte ou en ligne au caractère près, ignorez les espaces et exportez vos patchs unifiés.

Exemples prédéfinis :
Pipeline de calcul Myers LCS
Taux de similarité69.6%Distance d'édition de Myers (D)8
Réception des donnéesCRLF→LF • NormalizedNormalisation syntaxiqueD = 8 (O(ND))Moteur Myers LCSMot par motMicro-diff intra-ligne+5 / -3 (2 hunks)
Niveau de granularité
Texte d'origine (version source): 11L • 21W • 193C|Texte modifié (version cible): 12L • 24W • 237C
LF
1/2
1{
2 "status": 200,
3 "service": "auth-gateway",
4 "version": "1.4.2",
5 "features": ["oauth2", "jwt", "rate-limit"],
6 "timeoutMs": 5000,
7 "cache": {
8 "enabled": true,
9 "ttl": 3600
10 }
11}
1{
2 "status": 200,
3 "service": "auth-gateway",
4
5 "version": "1.5.limit"],
6 "features": ["oauth2", "jwt", "rate-limit", "mfa-totp,
7 "timeoutMs": 3000,
8 "cache": {
9 "enabled": true,
10 "ttl": 7200,
11 "ttl": 3600
12 }
13}
+5-3|2 Blocs de diff
Mot par mot|69.6% Taux de similarité
Similarité structurelle
69.6%
Score de similarité structurelle Levenshtein-Myers
Modifications détectées
+5 / -3
2 Blocs contigus de modifications détectées
Blocs de diff
Espace mémoire optimisé O(ND)
Zéro télémétrie

Calcul 100 % côté client

Exécution ultra-rapide réalisée intégralement en mémoire dans votre navigateur.

Zéro transfert de données

Vos données restent strictement locales : aucun payload ni code n'est envoyé vers un serveur tiers.

Export prêt pour la production

Formats de sortie propres et optimisés, prêts à être injectés dans vos pipelines de déploiement.
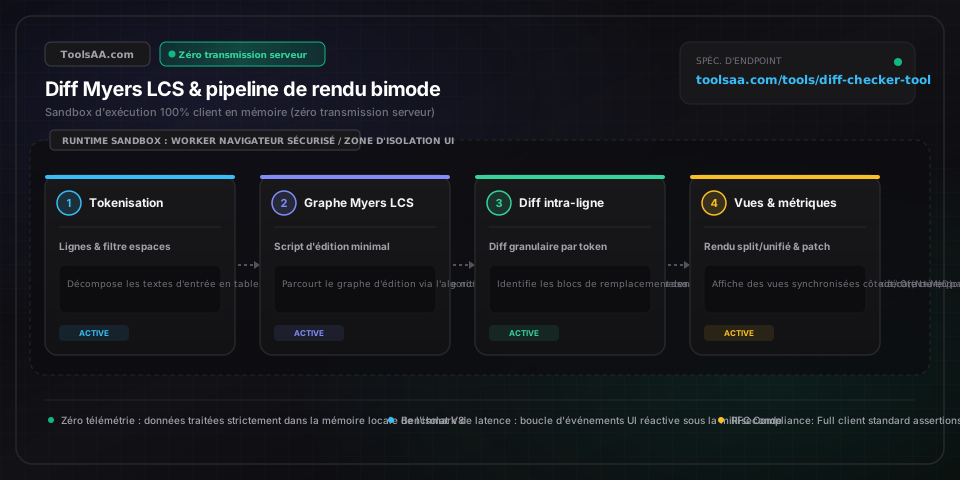
Référence technique et guide d'architecture

Comparateur de Texte & Code Diff — Guide de référence

Comparez du texte, du code et des fichiers grâce à notre outil de diff rapide. Visualisez les écarts côte à côte ou par caractère, ignorez les espaces et exportez des patchs unifiés.

Comparateur de Texte & Code Diff — Guide de référence — Architecture en mémoire côté client et flux de données

Paramètres clés et contrôles

diffGranularitystring (lines | words | chars)

Définit la résolution de segmentation pour le graphe d'édition de Myers. Le mode ligne segmente selon les sauts de ligne (\n) pour le diff syntaxique de code ; le mode mot segmente via les frontières lexicales Unicode (\b) pour la relecture juridique ; le mode caractère compare de manière atomique chaque point de code UTF-16 pour les empreintes cryptographiques et les jetons.

Par défaut : words
viewModestring (split | unified)

Contrôle la disposition visuelle. Le mode « split » affiche deux colonnes synchronisées côte à côte avec ancrage du défilement ; le mode « unified » compile une vue de patch sur une seule colonne conforme à la norme POSIX avec délimiteurs de hunks (@@ -l,s +l,s @@) selon la norme IEEE Std 1003.1.

Par défaut : split
ignoreWhitespaceboolean

Normalise les espaces avant de construire le script d'édition le plus court (SES). Supprime les retours chariot (conversion de \r\n en \n), fusionne les espaces consécutifs et tabulations en un séparateur unique, et tronque les espaces en fin de ligne pour éliminer les retouches purement cosmétiques.

Par défaut : true
ignoreCaseboolean

Applique le repliement de casse (case folding) via le mappage intégral Unicode avant le parcours diagonal de Myers, traitant majuscules et minuscules comme des glyphes identiques tout en préservant la casse d'origine dans les hunks affichés.

Par défaut : false
similarityScorenumber (percentage 0.0 - 100.0%)

Coefficient normalisé de similarité sémantique calculé selon la métrique de Dice-Sørensen : (2 × |LCS|) / (|A| + |B|) × 100 %. Un score ≥ 80 % indique des révisions mineures, entre 50 et 79 % un refactoring substantiel, et < 30 % une divergence quasi-totale du contenu.

Par défaut : 100.0%

Conseils de pro et bonnes pratiques

Utilisez la granularité par mots pour les relectures juridiques et éditoriales

Lors de la comparaison de contrats, d'accords de confidentialité (NDA) ou de documentation Markdown, basculez de la granularité ligne à la granularité mot. Le diff de Myers par ligne traite un paragraphe entier de 200 mots comme une suppression et réinsertion intégrale si une simple date ou ponctuation varie, tandis que la segmentation par mot isole précisément le terme modifié dans des encadrés vert émeraude et rose contrastés.

Éliminez les faux positifs grâce à la normalisation des espaces

La collaboration multiplateforme engendre fréquemment des discordances invisibles de fin de ligne entre Windows (CRLF, \r\n) et Unix (LF, \n), ainsi que des dérives d'indentation espaces/tabulations. L'activation de « Ignore Whitespace » supprime les retours chariot et compresse les espaces superflus, isolant ainsi la véritable logique applicative des modifications cosmétiques d'indentation.

Exportez des patchs propres pour Git et l'automatisation CI/CD

Basculez le mode d'affichage sur « unified » avant de télécharger vos fichiers .patch. La sortie respecte scrupuleusement le format de diff unifié RFC et la norme POSIX IEEE Std 1003.1 avec des en-têtes bilignes valides (« --- a/original » et « +++ b/modified ») et des sections de hunks normalisées (« @@ -k,l +m,n @@ »), permettant une application directe via « git apply patch.diff » ou « patch -p1 ».

Exploitez la minicarte SVG pour auditer rapidement de longs documents

Lors de l'analyse de fichiers dépassant 1 000 lignes, utilisez la minicarte de diff SVG située à droite. Des repères colorés calculent des coordonnées verticales proportionnelles (y = indexLigne / totalLignes * hauteurCanevas), offrant une navigation en un clic vers les modifications isolées sans devoir faire défiler manuellement le DOM.

Pièges courants et dépannage

⚠️Le document entier apparaît surligné comme supprimé puis réinséré malgré un contenu identique.

Ce problème survient lors de la comparaison de fichiers présentant des conventions de fin de ligne divergentes (CRLF Windows « \r\n » vs LF Unix « \n ») ou un marqueur d'ordre des octets UTF-8 BOM (0xEF, 0xBB, 0xBF) hétérogène. Activez « Ignore Whitespace » pour éliminer les retours chariot lors de la segmentation lexicale, ou convertissez vos fins de ligne en « \n » avant de lancer la comparaison.

⚠️Le diff au niveau caractère ralentit fortement sur de gros fichiers JavaScript minifiés ou du JSON sur une seule ligne.

La comparaison caractère par caractère présente une complexité temporelle au pire des cas en O((N+M)D), où D représente la distance d'édition. Pour les fichiers minifiés monolignes dépassant 50 000 caractères, passez la granularité sur « Lignes » ou reformatez le JSON au préalable avec un outil d'embellissement (beautifier) avant la comparaison.

⚠️Le défilement synchronisé entre les deux colonnes semble désaligné sur les longs paragraphes.

L'affichage côte à côte aligne le contenu à l'aide d'ancrages virtuels fondés sur les blocs de suppression et d'insertion de Myers. Si l'un des documents comporte d'importantes insertions asymétriques, assurez-vous que le verrouillage synchronisé est activé ; l'outil insère automatiquement des cales virtuelles sur le panneau opposé pour préserver l'alignement horizontal des lignes.

Foire aux questions (FAQ)

Comment l'algorithme de Myers calcule-t-il les ajouts et suppressions de lignes ?▼

L'algorithme de diff de Myers modélise la comparaison textuelle comme la recherche du plus court chemin dans un graphe d'édition, où les déplacements horizontaux correspondent à des suppressions et les déplacements verticaux à des insertions. Grâce à une recherche gloutonne le long des diagonales (qui représentent les éléments identiques), il extrait la plus longue sous-séquence commune (LCS) et génère le script d'édition minimal en O((N+M)D) opérations, où N et M représentent les longueurs des textes et D la distance d'édition.

Quelle est la différence entre un diff unifié et un diff côte à côte (split) ?▼

Le diff côte à côte (split) dispose le texte original et le texte modifié dans deux colonnes parallèles, affichant les ajouts et suppressions en vis-à-vis avec un défilement synchronisé. Le diff unifié regroupe les deux versions au sein d'une colonne séquentielle unique, affichant les lignes de contexte inchangées avec les suppressions précédées de « - » en rouge et les ajouts précédés de « + » en vert, conformément au standard utilisé par Git, GitHub et les commandes de patch en terminal.

Comment ignorer les différences d'espaces et les retours chariot lors de la comparaison ?▼

Activez l'option « Ignore Whitespace » dans la barre d'outils. Le préprocesseur convertit alors les retours chariot (CRLF en LF), supprime les espaces résiduels en bout de ligne et assimile les suites d'espaces ou de tabulations multiples à un séparateur unique, isolant ainsi les modifications de fond des simples retouches de mise en page.

Peut-on générer un fichier de patch Git standard à partir d'un comparateur de diff en ligne ?▼

Oui. Cet outil produit des fichiers de patch au format diff unifié strictement conformes aux spécifications RFC. Passez en vue « Unified Diff » ou cliquez sur « Exporter .patch » pour télécharger un fichier texte intégrant les en-têtes de fichiers (« --- a/original », « +++ b/modified ») et les blocs de hunks (« @@ -1,5 +1,6 @@ »), prêt à être appliqué directement avec la commande « git apply ».

Comment le pourcentage de similarité textuelle est-il calculé lors de l'analyse de diff ?▼

Le score de similarité repose sur le coefficient de Dice-Sørensen appliqué à la plus longue sous-séquence commune (LCS) de Myers : Similarité = (2 × |LCS|) / (|Éléments originaux| + |Éléments modifiés|) × 100 %. Deux documents strictement identiques obtiennent un score de 100,0 %, tandis que des contenus totalement disjoints obtiennent 0,0 %.

Outils et utilitaires connexes

Tous les outils →
Générateur de Balises Canoniques & URLDéveloppement

Générez des balises rel=canonical et en-têtes HTTP valides. Supprimez les paramètres de suivi, normalisez les URL et éliminez le contenu dupliqué en SEO.

Ouvrir l'outil→
Convertisseur cURL en Fetch (JS & Node)Développement

Convertissez instantanément vos commandes cURL en syntaxe Fetch API. Analysez en-têtes HTTP, tokens d'authentification, cookies et payloads JSON en code JavaScript async/await moderne.

Ouvrir l'outil→
Validateur Sitemap XML & Syntaxe URLDéveloppement

Validez instantanément vos sitemaps XML et fichiers d'index. Vérifiez le seuil des 50 000 URLs, la syntaxe W3C Datetime, les balises hreflang, schémas médias et erreurs Google Search Console.

Ouvrir l'outil→
Simulateur SERP Google & Aperçu SnippetDéveloppement

Prévisualisez vos extraits Google SERP sur ordinateur et mobile avec troncature précise au pixel près, badges rich snippets, sitelinks et score CTR en direct.

Ouvrir l'outil→
Générateur Dégradé Mesh CSS & Fond SVGDéveloppement

Générez des dégradés de maillage CSS multi-points, des arrière-plans animés et des maillages SVG. Ajustez les points de contrôle, le grain argentique et exportez le code CSS ou Tailwind.

Ouvrir l'outil→
Générateur d'URL UTM & CampagnesDéveloppement

Créez, validez et générez par lots vos liens de suivi de campagne Google Analytics GA4 avec notre générateur UTM gratuit. Nettoyez vos URL, extrayez les balises existantes et exportez des QR codes.

Ouvrir l'outil→