Comparador de Texto & Diff Checker

Comparador de Texto & Diff Checker

Motor Myers Diff em Tempo Real

Compare textos, códigos e arquivos com nosso verificador de diff ultrarrápido. Inspecione alterações lado a lado ou em linha, ignore espaços e exporte patches unificados.

Predefinições
Pipeline Computacional Myers LCS
Taxa de Similaridade Myers69.6%Distância de Edição Myers (D)8
Ingestão de DadosCRLF→LF • NormalizedNormalizaçãoD = 8 (O(ND))Motor Myers LCSPalavra por PalavraMicro-Diff em Linha+5 / -3 (2 hunks)
Granularidade
Buffer Original / Fonte: 11L • 21W • 193C|Buffer Modificado / Destino: 12L • 24W • 237C
LF
1/2
1{
2 "status": 200,
3 "service": "auth-gateway",
4 "version": "1.4.2",
5 "features": ["oauth2", "jwt", "rate-limit"],
6 "timeoutMs": 5000,
7 "cache": {
8 "enabled": true,
9 "ttl": 3600
10 }
11}
1{
2 "status": 200,
3 "service": "auth-gateway",
4
5 "version": "1.5.limit"],
6 "features": ["oauth2", "jwt", "rate-limit", "mfa-totp,
7 "timeoutMs": 3000,
8 "cache": {
9 "enabled": true,
10 "ttl": 7200,
11 "ttl": 3600
12 }
13}
+5-3|2 Blocos de Alteração
Palavra por Palavra|69.6% Taxa de Similaridade Myers
Similaridade Myers
69.6%
Pontuação de similaridade matemática Levenshtein-Myers
Alterações Detectadas
+5 / -3
2 Blocos contíguos de alterações detectadas
Blocos de Diff
Otimizado em Espaço
Zero Telemetria

Processamento no Cliente

Cálculo de alta performance executado inteiramente na memória do navegador.

Privacidade Sem Upload para Servidores

Todos os dados permanecem estritamente locais, sem comunicação com servidores externos.

Exportação Pronta para Produção

Formatos de saída limpos e otimizados, prontos para implantação imediata.
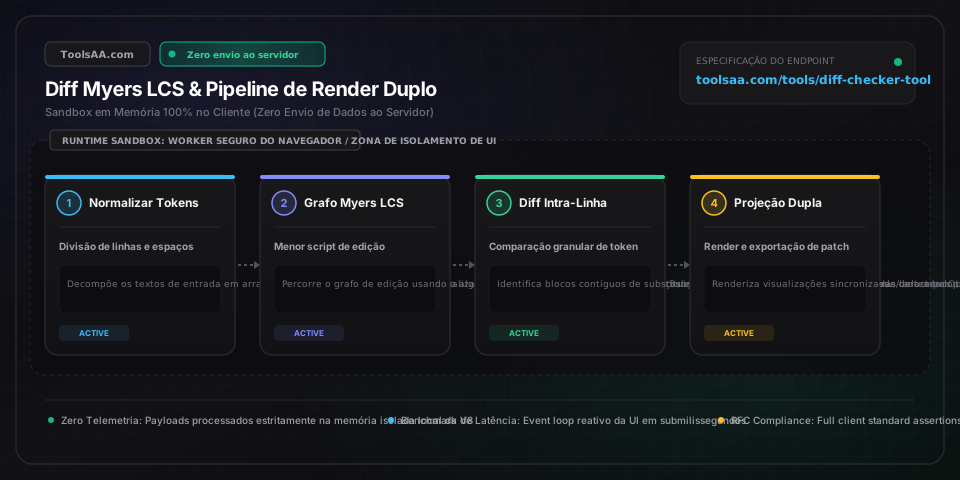
Referência técnica e guia de arquitetura

Comparador de Texto & Diff Checker — Guia de referência

Compare textos, códigos e arquivos com nosso comparador diff online. Inspecione alterações lado a lado ou inline por caractere, ignore espaços e exporte patches unificados.

Comparador de Texto & Diff Checker — Guia de referência — Arquitetura em memória do lado do cliente e fluxo de dados

Parâmetros-chave e controles

Granularidade da Comparaçãostring (linhas | palavras | caracteres)

Define a resolução dos limites de tokenização para o grafo de edição de Myers. O modo de linhas divide o texto por quebras de linha (\n) para diffs sintáticos de código; o modo de palavras utiliza limites de palavras Unicode (\b) para revisões de minutas contratuais; o modo de caracteres executa comparações atômicas de pontos de código UTF-16 para hashes criptográficos e tokens.

Padrão: palavras
Modo de Visualizaçãostring (lado a lado | unificado)

Controla a apresentação do layout visual. O modo 'split' renderiza duas colunas paralelas sincronizadas com ancoragem de rolagem na janela; o modo 'unified' compila uma visualização de patch em coluna única compatível com POSIX contendo delimitadores de bloco (@@ -l,s +l,s @@) conforme o padrão IEEE Std 1003.1.

Padrão: lado a lado (split)
Ignorar Espaços em Brancobooleano

Normaliza os caracteres de espaçamento antes de calcular o menor script de edição. Remove retornos de carro (converte \r\n para \n), consolida múltiplos espaços e tabulações em delimitadores únicos e descarta espaços no final das linhas para eliminar alterações puramente estéticas de formatação.

Padrão: true
Ignorar Diferença de Maiúsculas e Minúsculasbooleano

Aplica conversão uniforme de maiúsculas e minúsculas (case folding) por mapeamento Unicode completo antes da travessia diagonal de Myers, tratando letras maiúsculas e minúsculas como tokens idênticos enquanto preserva o texto original nos blocos renderizados.

Padrão: false
Índice de Similaridadenúmero (porcentagem de 0,0% a 100,0%)

Coeficiente normalizado de similaridade semântica calculado pela métrica Dice-Sørensen: (2 × |LCS|) / (|A| + |B|) × 100%. Índices >= 80% indicam pequenas revisões, 50–79% representam refatoração substancial e < 30% sinalizam divergência quase total entre os conteúdos.

Padrão: 100,0%

Dicas profissionais e melhores práticas

Use Granularidade de Palavra para Contratos e Textos

Ao comparar minutas contratuais, termos jurídicos (NDAs) ou documentações em Markdown, alterne a granularidade de Linha para Palavra. O algoritmo de Myers por linhas trata um parágrafo inteiro de 200 palavras como exclusão e reinserção completa se apenas uma vírgula ou data for alterada, enquanto a divisão por palavras destaca com exatidão o termo modificado nas margens em verde e vermelho.

Elimine Falsos Positivos com Normalização de Espaços

A colaboração entre diferentes plataformas frequentemente introduz divergências invisíveis de quebra de linha entre CRLF (Windows \r\n) e LF (Linux/macOS \n), além de variações entre espaços e tabulações. Ativar 'Ignorar Espaços em Branco' remove retornos de carro e unifica sequências vazias, isolando alterações lógicas reais de simples modificações de espaçamento.

Exporte Arquivos Patch Limpos para Git e Pipelines CI/CD

Mude para o modo 'unificado' antes de baixar arquivos .patch. O resultado gerado segue rigorosamente os padrões POSIX IEEE Std 1003.1 e as RFCs de diff unificado, incluindo cabeçalhos padrão ('--- a/original' e '+++ b/modified') e delimitadores de bloco ('@@ -k,l +m,n @@'), permitindo aplicação direta via terminal com 'git apply patch.diff' ou 'patch -p1'.

Navegue em Arquivos Longos Usando o Minimapa SVG

Ao auditar documentos com mais de 1.000 linhas, utilize o minimapa visual em SVG no painel lateral. Marcadores lineares coloridos calculam as coordenadas verticais proporcionais (y = índiceLinha / totalLinhas * alturaTela), permitindo navegar diretamente até as alterações pontuais com um único clique, sem necessidade de rolagem manual contínua.

Armadilhas comuns e solução de problemas

⚠️O documento inteiro é marcado como excluído e reinserido, apesar de o texto ser idêntico.

Isso acontece quando os arquivos possuem padrões de quebra de linha divergentes entre sistemas operacionais (Windows CRLF '\r\n' versus Linux/macOS LF '\n') ou marcas de ordem de bytes UTF-8 BOM distintas (0xEF, 0xBB, 0xBF). Ative a opção 'Ignorar Espaços em Branco' para remover retornos de carro na tokenização, ou padronize as quebras para '\n' antes de executar a comparação.

⚠️A comparação caractere por caractere fica lenta em arquivos JavaScript minificados ou JSON em linha única.

A comparação por caractere possui complexidade de tempo no pior caso de O((N+M)D), onde D representa a distância de edição. Para arquivos minificados em linha única com mais de 50.000 caracteres, mude a granularidade para 'Linhas' ou formate o código previamente com um formatador JSON/JS antes de comparar.

⚠️A rolagem sincronizada entre as duas colunas parece desalinhada em parágrafos extensos.

Os painéis no modo dividido alinham o conteúdo por meio de ancoragem virtual de linhas com base nos pares de inserção e exclusão calculados por Myers. Quando um dos documentos possui grandes inserções assimétricas, certifique-se de que o bloqueio sincronizado esteja ativo; a ferramenta insere automaticamente espaçadores virtuais no painel oposto para preservar o alinhamento paralelo.

Perguntas frequentes (FAQ)

Como o algoritmo de Myers calcula as adições e exclusões entre textos?▼

O algoritmo de Myers modela a comparação de textos como a busca pelo caminho mais curto em um grafo de edição, no qual movimentos horizontais representam exclusões e movimentos verticais representam inserções. Ao empregar uma busca gulosa (greedy search) ao longo de trajetórias diagonais que indicam tokens idênticos, ele descobre a Maior Subsequência Comum (LCS) e gera o menor script de edição possível em tempo O((N+M)D), onde N e M são os comprimentos dos documentos e D é a distância de edição.

Qual a diferença entre a visualização unificada (unified diff) e lado a lado (split diff)?▼

A visualização lado a lado (split) organiza os textos original e modificado em duas colunas paralelas, exibindo exclusões e inserções lado a lado com rolagem sincronizada. Já o formato unificado (unified) consolida ambas as versões em uma única coluna sequencial, exibindo linhas de contexto inalteradas com linhas removidas destacadas em vermelho (prefixadas com '-') e inseridas em verde (prefixadas com '+'), idêntico ao padrão utilizado pelo Git, GitHub e ferramentas de linha de comando.

Como ignorar diferenças de espaçamento e quebras de linha na comparação?▼

Ative a opção 'Ignorar Espaços em Branco' na barra de configurações. Isso instrui o pré-processador a remover retornos de carro (convertendo CRLF para LF), eliminar espaços no final de cada linha e tratar sequências contínuas de espaços ou tabulações como um delimitador único, destacando exclusivamente alterações reais de lógica ou conteúdo sem ruídos visuais.

É possível gerar um arquivo de patch compatível com o Git?▼

Sim. A ferramenta produz arquivos de patch no formato diff unificado em conformidade com as RFCs e padrões da indústria. Basta alternar para a visão unificada ou clicar em 'Exportar .patch' para baixar um arquivo de texto formatado com cabeçalhos de arquivo ('--- a/original', '+++ b/modified') e marcadores de bloco ('@@ -1,5 +1,6 @@'), prontos para aplicação direta no terminal com o comando 'git apply'.

Como a porcentagem de similaridade entre os textos é calculada?▼

O índice de similaridade é determinado por meio do coeficiente de Dice-Sørensen fundamentado na Maior Subsequência Comum (LCS) calculada por Myers: Similaridade = (2 × |LCS|) / (|Tokens Originais| + |Tokens Modificados|) × 100%. Textos idênticos resultam em 100,0%, enquanto documentos completamente distintos resultam em 0,0%.

Ferramentas e utilitários relacionados

Todas as ferramentas →