Comparador de Texto & Diff Online

Comparador de Texto & Diff Online

Motor Diff Myers en Tiempo Real

Compara texto, código y archivos con nuestro rápido motor de diff. Inspecciona cambios lado a lado o en línea a nivel de caracteres, omite espacios en blanco y exporta parches unificados.

Plantillas Predefinidas:
Canal Computacional Myers LCS
Ratio de Similitud Myers69.6%Distancia de Edición Myers8
Ingesta de TextoCRLF→LF • NormalizedNormalización y TokensD = 8 (O(ND))Motor Myers LCSPalabra por PalabraResaltado Intra-Línea+5 / -3 (2 hunks)
Nivel de Granularidad
Búfer Original / Origen: 11L • 21W • 193C|Búfer Modificado / Destino: 12L • 24W • 237C
LF
1/2
1{
2 "status": 200,
3 "service": "auth-gateway",
4 "version": "1.4.2",
5 "features": ["oauth2", "jwt", "rate-limit"],
6 "timeoutMs": 5000,
7 "cache": {
8 "enabled": true,
9 "ttl": 3600
10 }
11}
1{
2 "status": 200,
3 "service": "auth-gateway",
4
5 "version": "1.5.limit"],
6 "features": ["oauth2", "jwt", "rate-limit", "mfa-totp,
7 "timeoutMs": 3000,
8 "cache": {
9 "enabled": true,
10 "ttl": 7200,
11 "ttl": 3600
12 }
13}
+5-3|2 Bloques de Cambios
Palabra por Palabra|69.6% Ratio de Similitud Myers
Similitud Myers
69.6%
Puntuación de coincidencia exacta según el algoritmo Myers LCS
Cambios Detectados
+5 / -3
2 Grupos contiguos de modificaciones detectadas
Bloques de Diff
Espacio Optimizado
Cero Telemetría

Procesamiento en el Navegador

Cálculo de alto rendimiento ejecutado íntegramente en la memoria local del navegador.

Cero Envío a Servidores

Toda la información se mantiene estrictamente local, sin comunicación con servidores externos.

Exportación Lista para Producción

Formatos de salida limpios y optimizados, listos para despliegue o integración inmediata.
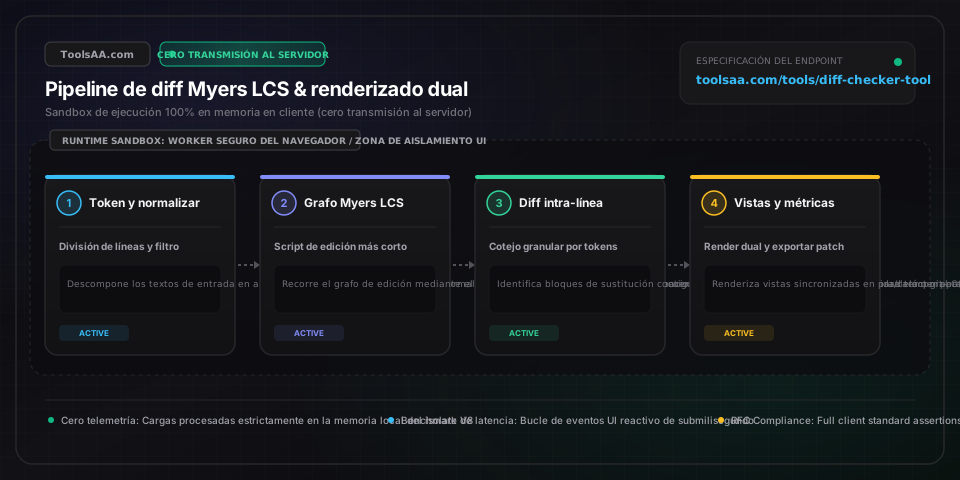
Referencia técnica y guía de arquitectura

Comparador de Texto & Código Diff — Guía de referencia

Compara texto, código y archivos con nuestro rápido comparador diff. Inspecciona cambios carácter a carácter en vista paralela o unificada, ignora espacios en blanco y exporta parches diff estándar.

Comparador de Texto & Código Diff — Guía de referencia — Arquitectura en memoria del lado del cliente y flujo de datos

Parámetros clave y controles

Granularidad de comparacióncadena (líneas | palabras | caracteres)

Define la resolución de los límites de tokenización en el grafo de edición de Myers. El modo por líneas segmenta por saltos de línea (\n) para diferencias sintácticas de código; el modo por palabras segmenta mediante límites léxicos Unicode (\b) para revisiones contractuales; el modo por caracteres ejecuta comparaciones atómicas de puntos de código UTF-16 para hashes criptográficos y tokens de seguridad.

Por defecto: palabras
Modo de visualizacióncadena (dividida | unificada)

Controla la disposición visual de la interfaz. La vista 'dividida' (split) genera dos columnas paralelas sincronizadas con anclaje de desplazamiento en el viewport; la vista 'unificada' (unified) compila un parche en columna única conforme al estándar POSIX con delimitadores de bloque (@@ -l,s +l,s @@) según la norma IEEE Std 1003.1.

Por defecto: dividida
Ignorar espacios en blancobooleano

Normaliza los tokens de espaciado antes de calcular la secuencia mínima de edición (SES). Elimina retornos de carro (convirtiendo \r\n a \n), colapsa secuencias de espacios y tabulaciones en un único delimitador y suprime espacios finales para aislar modificaciones lógicas de cambios cosméticos de formato.

Por defecto: true
Ignorar mayúsculas y minúsculasbooleano

Aplica un plegado de mayúsculas y minúsculas (case folding) mediante el mapeo de caracteres Unicode antes del recorrido diagonal de Myers, tratando glifos en mayúsculas y minúsculas como tokens idénticos pero conservando la tipografía original en los bloques renderizados.

Por defecto: false
Puntuación de similitudnúmero (porcentaje 0.0 - 100.0%)

Coeficiente de similitud semántica normalizado calculado mediante el índice de Dice-Sørensen: (2 × |LCS|) / (|A| + |B|) × 100%. Un resultado >= 80% indica revisiones menores, 50–79% refleja una refactorización sustancial y < 30% evidencia una divergencia casi total de contenido.

Por defecto: 100.0%

Consejos profesionales y mejores prácticas

Prioriza la granularidad por palabras para contratos y textos editoriales

Al comparar contratos mercantiles, acuerdos de confidencialidad (NDA) o documentación técnica en Markdown, cambia la granularidad de Línea a Palabra. El algoritmo diff de Myers por líneas marca un párrafo entero de 200 palabras como una eliminación y reinserción total si cambia una fecha o una coma; en cambio, la tokenización léxica por palabras aísla con exactitud el término modificado con resaltado en esmeralda y carmesí.

Elimina falsos positivos mediante la normalización de espacios

El trabajo colaborativo entre sistemas operativos (Windows vs. macOS/Linux) suele introducir discrepancias invisibles de saltos de línea CRLF (\r\n) frente a LF (\n) y discrepancias de indentación entre espacios y tabuladores. Activar 'Ignorar espacios en blanco' elimina retornos de carro y unifica espacios, aislando las modificaciones lógicas reales de cambios no funcionales en el espaciado.

Exporta parches limpios para automatizaciones en Git y CI/CD

Cambia el modo de visualización a 'unificada' antes de descargar archivos .patch. La salida resultante cumple rigurosamente con los estándares POSIX IEEE Std 1003.1 y el formato RFC unified diff con encabezados de archivo válidos ('--- a/original' y '+++ b/modified') y encabezados de bloque estándar ('@@ -k,l +m,n @@'), permitiendo su aplicación directa mediante comandos como 'git apply patch.diff' o 'patch -p1'.

Aprovecha el minimapa SVG para auditar documentos extensos

Al auditar archivos o volcados de datos de más de 1.000 líneas, consulta el minimapa SVG interactivo en el lateral derecho. Las marcas lineales de color calculan coordenadas verticales proporcionales (y = índiceLínea / totalLíneas * alturaLienzo), permitiendo navegar con un solo clic directamente a mutaciones aisladas sin necesidad de desplazarse manualmente por el DOM.

Problemas comunes y soluciones

⚠️El documento completo aparece resaltado como eliminado y reinsertado aunque el texto es idéntico.

Esto se produce por discrepancias entre los estándares de fin de línea de distintos sistemas operativos (CRLF de Windows '\r\n' frente a LF de Unix '\n') o por la presencia de marcas de orden de bytes UTF-8 BOM (0xEF, 0xBB, 0xBF). Activa 'Ignorar espacios en blanco' para descartar retornos de carro durante la tokenización o normaliza los saltos de línea a '\n' antes de ejecutar la comparación.

⚠️La comparación por caracteres se ralentiza en archivos JavaScript minificados o JSON en una sola línea.

La comparación carácter por carácter tiene una complejidad computacional en el peor de los casos de O((N+M)D), donde D representa la distancia de edición. Para archivos minificados de una sola línea que superen los 50.000 caracteres, cambia la granularidad a 'Líneas' o formatea el JSON previamente con un embellecedor de código antes de compararlo.

⚠️El desplazamiento sincronizado entre los dos paneles se desalinea en párrafos extensos.

Los paneles en vista dividida alinean el contenido mediante anclaje de líneas virtuales basado en pares de bloques de eliminación e inserción de Myers. Cuando un documento contiene inserciones asimétricas voluminosas, asegúrate de activar el bloqueo en paralelo; la herramienta inserta automáticamente guías virtuales de relleno en el panel opuesto para mantener la correspondencia horizontal exacta.

Preguntas frecuentes (FAQ)

¿Cómo calcula el algoritmo diff de Myers las adiciones y eliminaciones de líneas?▼

El algoritmo de Myers modela la comparación de textos como la búsqueda de la ruta más corta en un grafo de edición, donde los desplazamientos horizontales representan eliminaciones y los verticales representan inserciones. Mediante una búsqueda voraz (greedy) a lo largo de diagonales que representan tokens coincidentes, localiza la Subsecuencia Común más Larga (LCS) y genera la secuencia mínima de edición (SES) en un tiempo de O((N+M)D), donde N y M son las longitudes de los documentos y D es la distancia de edición.

¿Cuál es la diferencia entre un diff unificado y un diff dividido en dos columnas?▼

El diff dividido en dos columnas (side-by-side) coloca el texto original y el modificado en paneles paralelos con desplazamiento sincronizado, facilitando la inspección visual directa. El diff unificado (unified) combina ambas versiones en una única secuencia vertical, mostrando las líneas contextuales sin cambios junto a las eliminaciones marcadas con un prefijo '-' en rojo y las inserciones con un prefijo '+' en verde, reproduciendo el formato estándar utilizado por Git, GitHub y las herramientas de consola.

¿Cómo ignoro los cambios de espacios en blanco y retornos de carro al comparar?▼

Activa la casilla 'Ignorar espacios en blanco' en la barra de herramientas. Esta instrucción indica al preprocesador que elimine los retornos de carro (convirtiendo CRLF en LF), suprima los espacios sobrantes al final de cada línea y colapse secuencias repetidas de espacios o tabulaciones en un único separador, aislando las variaciones funcionales de código o contenido de meras discrepancias de formato.

¿Es posible generar un archivo de parche patch estándar para Git desde esta herramienta?▼

Sí. La herramienta genera archivos de parche unificados totalmente conformes a los estándares RFC y POSIX. Cambia a la vista 'Diff unificado' o haz clic en 'Exportar .patch' para descargar un archivo de texto con encabezados de ruta ('--- a/original', '+++ b/modified') y encabezados de bloque ('@@ -1,5 +1,6 @@') listo para aplicarse directamente en la terminal con 'git apply'.

¿Cómo se calcula el porcentaje de similitud textual en el análisis de diferencias?▼

El índice de similitud se calcula mediante el coeficiente de Dice-Sørensen a partir de la Subsecuencia Común más Larga (LCS) de Myers: Similitud = (2 × |LCS|) / (|Tokens Originales| + |Tokens Modificados|) × 100%. Una coincidencia idéntica produce un 100,0%, mientras que dos textos sin ninguna coincidencia arrojan un 0,0%.

Herramientas y utilidades relacionadas

Todas las herramientas →