Rich Snippets Generator & Schema-Markup

Rich Snippets Generator & Schema-Markup

100 % clientseitiger Datenschutz

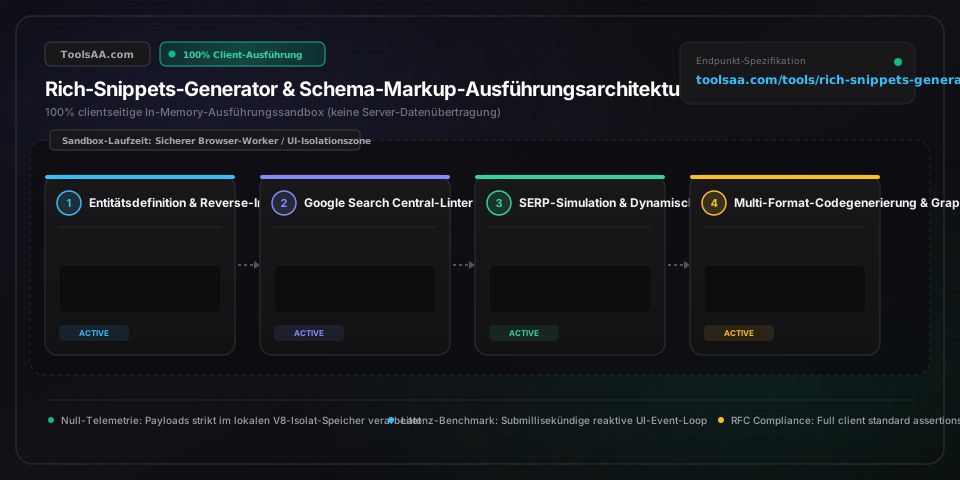
Google Rich Results & Schema-Markup in JSON-LD generieren, validieren und simulieren. Mit Echtzeit-SERP-Simulator, bidirektionalem Parser und Multi-Entity-Graphen.

PipelineQualitätsindex: 100/100
Input StateProductAST Assembler4 Nodes · 929BLinter EngineScore: 100%Exporterjson-ldSERP
Entity: ProductDirect Root Mode
AST Nodes: 4Output Size: 929 bytes
100 % Valides SchemaSchema.org / ProductVollständige Konformität mit Schema.org und den Google Search Central Richtlinien.
Bis zu +35 % CTR100 / 100Höhere organische Klickraten durch visuell hervorgehobene Rich-Suchergebnisse.
100 % Client-seitig4 Nodes · 929 BSichere lokale JSON-LD-Generierung im Browser ohne externe Serverübertragung.
Technische Referenz & Architektur-Leitfaden

Rich Snippets Generator & Schema-Markup — Referenzhandbuch

Google Rich Results & Schema-Markup in JSON-LD erstellen, validieren und in Echtzeit simulieren. Mit bidirektionalem Parser und Multi-Entity-Graph-Unterstützung.

Rich Snippets Generator & Schema-Markup — Referenzhandbuch — Client-seitige In-Memory-Architektur und Datenfluss

Wichtige Parameter & Einstellungen

@type (Schema.org-Entitätsklassifizierung)Schema.org-Klassen-IRI / Vokabular-Token

Definiert die primäre semantische Knotenklasse (z. B. Product, Article, LocalBusiness, FAQPage, SoftwareApplication) innerhalb der W3C JSON-LD 1.1-Ontologie. Steuert die Feature-Extraktions-Pipelines des Google Search Crawlers und determiniert die exakten Rich-Snippet-Rendering-Templates für mobile und Desktop-SERP-Viewports.

Standard: "Product"
@graph-Knoten-Array (@id-URI-Auflösung)RFC 3986 kanonische URI / Graph-Array

Führt entkoppelte Entitäten zu einem zusammenhängenden azyklischen Graphen zusammen. Durch deterministische RFC 3986 `#id`-Fragmentbezeichner lösen Suchmaschinen-Tokenizer bidirektionale Entitätsbeziehungen (z. B. Verknüpfung des Article-Autorknotens mit dem Organization-Publisher-Knoten) in linearer O(n)-Parsing-Komplexität ohne redundanten Payload-Overhead auf.

Standard: [{"@type": "Organization", "@id": "https://example.com/#organization"}]
aggregateRating (Kundenbewertungsverteilung)Schema.org Rating-Entität (IEEE 754 Float [1.00–5.00], Integer >= 1)

Quantifiziert verifizierte Nutzerbewertungsmetriken über `ratingValue` (strikte Dezimalskala von 1.00 bis 5.00) und `reviewCount` / `ratingCount`. Speist Googles Algorithmus zur Ausspielung goldener Sterne in organischen SERPs. Daten müssen mit dem sichtbaren DOM-Text innerhalb einer Toleranz von 0,01 übereinstimmen, um algorithmische Abstrafungen wegen manipulativer strukturierter Daten zu verhindern.

Standard: {"@type": "AggregateRating", "ratingValue": "4.85", "reviewCount": "142"}
offers (Kommerzielle Transaktion & Lagerbestand)Schema.org Offer-Entität (ISO 4217 Währung, ItemAvailability-URI)

Kapselt Transaktionskonditionen für Google Merchant Center und organische SERP-Preis-Badges. Erzwingt nicht-negative numerische Preisstrings nach RFC 8259-Spezifikation, dreistellige ISO 4217-Währungscodes (z. B. 'EUR', 'USD') und kanonische Schema.org-ItemAvailability-Enumerations-URIs.

Standard: {"@type": "Offer", "price": "89.99", "priceCurrency": "EUR", "availability": "https://schema.org/InStock"}
author (Entitätsidentität & E-E-A-T-Verankerung)Schema.org Person- / Organization-Objekt mit sameAs-URIs

Etabliert eine autoritative Urheberschaftszuordnung gemäß den Google Search Quality Rater Guidelines (Abschnitt 2.5: E-E-A-T). Durch die Einbettung verifizierter `sameAs`-Arrays mit Verweisen auf Wikidata, ORCID oder offizielle Social-Graph-Entitäten löst die Suchmaschine den realen Knowledge-Graph-Knoten des Autors mit kryptografischer Eindeutigkeit auf.

Standard: {"@type": "Person", "name": "Dr. Elena Rostova", "sameAs": ["https://orcid.org/0000-0002-1825-0097"]}
datePublished / dateModified (Zeitliche Chronologie)ISO 8601 / RFC 3339 Erweiterter UTC-Datums-Zeit-String

Injiziert maschinenlesbare Zeitstempel, die für Google Top Stories, News-Karussells und Frische-Ranking-Algorithmen zwingend erforderlich sind. Erfordert eine vollständige UTC-Offset-Formatierung (`YYYY-MM-DDThh:mm:ssZ` oder `±hh:mm`). Diskrepanzen zwischen dem JSON-LD-Feld `dateModified` und den HTTP-Headern `Last-Modified` hebeln die Frische-Priorisierung im Crawler-Scheduling aus.

Standard: "2026-03-31T08:00:00+00:00"
Profi-Tipps & Best Practices

DOM-Duplikation durch Disjointed-Graph-Interlinking eliminieren

Injizieren Sie keinesfalls isolierte `<script type="application/ld+json">`-Tags für WebSite, Organization, WebPage und Product. Crawler interpretieren unverbundene Blöcke als eigenständige Entitäten, sofern sie nicht explizit verknüpft sind. Konsolidieren Sie diese in einem zentralen `@graph`-Root-Array unter Verwendung kanonischer RFC 3986 `@id`-URI-Anker (`https://domain.de/#org`, `https://domain.de/#webpage`). Dies verhindert Entitätsfragmentierung im Google Knowledge Graph, senkt das JSON-Payload-Gewicht um bis zu 45 % und erzwingt O(1)-Pointer-Auflösung beim Crawlen.

Strikte Absicherung gegen Abstrafungen bei Self-Serving-Reviews

Googles algorithmische Qualitätsfilter entwerten und strafen `aggregateRating`-Markup ab, das direkt auf `LocalBusiness` oder `Organization` angewendet wird, wenn die Bewertungen auf der eigenen Domain des Unternehmens gehostet werden. Bewertungssterne werden ausschließlich für unabhängig verifizierte Produkte, Kurse, Software oder externe redaktionelle Rezensionen gerendert. Das Einbetten von eigennützigem Bewertungs-Schema auf der Startseite riskiert die vollständige Aussetzung von Rich Snippets für die gesamte Domain.

Seitenverhältnis-Triptychon für Google Discover & Karussells einhalten

Die Bereitstellung einer einzelnen Bild-URL im Schema für Article oder Recipe erfüllt nicht die Anforderungen für Google Discover und Large-Badge-Karussells. Google Search Central schreibt hochauflösende Bilder mit mindestens 1.200 px Breite in drei expliziten Seitenverhältnissen vor: 16:9 (`1920x1080`), 4:3 (`1600x1200`) und 1:1 (`1200x1200`). Fehlt dieses Multi-Ratio-Array, wird das Snippet-Rendering auf Standard-Thumbnails mit niedriger Klickrate (CTR) gedrosselt.

Zero-Trust-Parität zwischen gerendertem DOM und injiziertem JSON-LD

Googles Web Rendering Service (WRS) gleicht strukturierte Daten strikt mit dem berechneten CSS/DOM-Layout ab. Werden Preise, Bewertungsnoten oder Lagerbestände im JSON-LD deklariert, die von den im CSS sichtbaren On-Page-Werten abweichen (z. B. via `display: none` verborgen oder durch Client-Side-Hydration verzögert), verhängt die Google Search Console eine manuelle Maßnahme ('Spammy Structured Markup'), was zur vollständigen Deindexierung aller Rich Results führt.

Häufige Fehlerquellen & Fehlerbehebung

⚠️Der Google Rich Results Test besteht ohne Warnungen, aber goldene Bewertungssterne erscheinen nie in den organischen Google-Suchergebnissen.

Das Bestehen der technischen Schema-Validierung verifiziert lediglich die Syntax nach RFC 8259 und die Konformität mit Schema.org; es gewährt jedoch keine automatische SERP-Rendering-Freigabe. Google Search Quality-Algorithmen prüfen drei zusätzliche Barrieren: (1) Domain-Trust-Schwellenwert: Die Domain benötigt hinreichende Autorität und Crawling-Budget; (2) Suchintentions-Abstimmung: Rein informationelle Suchanfragen blenden kommerzielle Sterne-Snippets aus; (3) Anti-Self-Serving-Regel: Vergewissern Sie sich, dass kein `aggregateRating` auf `LocalBusiness`, `Organization` oder reinen Leistungsseiten platziert wurde. Prüfen Sie den Bericht 'Manuelle Maßnahmen' in der Google Search Console und stellen Sie sicher, dass `ratingValue` exakt mit dem sichtbaren Text im statischen DOM-Snapshot übereinstimmt.

⚠️Der JSON-LD-Parser gibt 'SyntaxError: Unexpected token in JSON at position X' aus oder schlägt wegen Trailing Commas und unmaskierten Anführungszeichen fehl.

RFC 8259 verbietet nachgestellte Kommas (Trailing Commas) in Objekt-/Array-Deklarationen sowie unmaskierte ASCII-Steuerzeichen oder unmaskierte doppelte Anführungszeichen in Strings strikt. Nutzen Sie in Client-Side-Build-Pipelines RFC-konforme Serialisierungs-Sanitizer: Verwenden Sie stets `JSON.stringify()` statt String-Konkatenation, maskieren Sie interne Anführungszeichen mit `\"` und ersetzen Sie Zeilenumbrüche durch `\n`. Führen Sie in Browser-Sandboxen ein `JSON.parse()` innerhalb eines `try...catch`-Blocks aus, um strukturelle Byte-Offsets vor der Skript-Injektion abzufangen.

⚠️Google Search Console meldet 'Ungültiger Wert im Feld priceCurrency' oder 'Fehlendes Feld price' bei Produkt-Optimierungen.

Search-Crawler verlangen strikte dreistellige Währungscodes nach ISO 4217 (z. B. 'EUR', 'USD', 'GBP') und weisen lokalisierte Währungssymbole ('€', '$', '£') im Feld `priceCurrency` ab. Zudem muss die Eigenschaft `price` als numerischer Gleitkomma-String mit einem Punkt '.' als Dezimaltrennzeichen formatiert sein (z. B. '29.99', niemals '29,99' und ohne Währungszeichen). Aktualisieren Sie Ihr Währungs-Serialisierungsmodul so, dass Währungssymbole vom numerischen Betrag isoliert und lokale Währungsbezeichnungen auf kanonische ISO 4217-Alpha-Codes gemappt werden.

Häufig gestellte Fragen (FAQ)

Wie testet man, ob JSON-LD Rich Snippets in der Google-Suche erscheinen?▼

Testen Sie JSON-LD-Markup mit Googles offiziellem Test für Rich-Suchergebnisse (search.google.com/test/rich-results) und prüfen Sie Live-URLs mit dem URL-Prüfungstool der Google Search Console. Fügen Sie Ihren kompilierten JSON-LD-Payload in den Code-Validator ein, um die Konformität mit den Richtlinien von Google Search Central zu überprüfen. Die Test-Suite parst AST-Knoten, validiert erforderliche sowie empfohlene Schema-Eigenschaften und liefert eine Live-SERP-Renderingsimulation. Technische Validität sichert die Crawler-Berechtigung; die tatsächliche organische SERP-Ausspielung bleibt jedoch von algorithmischer Suchintention und Domain-Qualitätsbewertung abhängig.

Was ist der Unterschied zwischen JSON-LD und Microdata für Rich Snippets?▼

JSON-LD entkoppelt strukturierte Metadaten vollständig vom HTML-Layout in einen eigenständigen `<script type="application/ld+json">`-Block, wohingegen Microdata Schema-Attribute (`itemprop`, `itemscope`) direkt fest mit dem DOM-Markup verwebt. JSON-LD ist das von Google offiziell empfohlene Format, da es asynchron und ohne Blockierung des DOM-Tree-Aufbaus parst, komplexe Graph-Modellierungen über `@graph`- und `@id`-Pointer in O(n)-Zeit unterstützt und Markup-Beschädigungen bei UI-Redesigns oder CSS-Refactorings verhindert.

Warum zeigt Google trotz validem Schema-Markup keine Rich-Snippet-Sterne an?▼

Eine valide Schema-Syntax ist lediglich eine technische Grundvoraussetzung. Googles algorithmische Qualitätsklassifikatoren unterdrücken Bewertungssterne, wenn der Domain das erforderliche Vertrauen (Trust) fehlt, Bewertungen eigennützig ('self-serving') sind oder die Schemadaten im Widerspruch zum sichtbaren DOM stehen. Gemäß den Richtlinien für strukturierte Daten von Google führen vier Kriterien zur Sternenunterdrückung: (1) Kennzeichnung von `LocalBusiness` oder `Organization` mit selbst publizierten Bewertungen; (2) Semantische Fehlauszeichnungen wie das Deklarieren von Dienstleistungsseiten als `Product`; (3) Notendiskrepanzen zwischen JSON-LD-Werten und den gerenderten HTML-Zahlen; (4) Algorithmische Vertrauensabstrafungen aufgrund domainweiter E-E-A-T-Defizite.

Kann man mehrere Schema-Typen in einem einzigen JSON-LD-Graphen kombinieren?▼

Ja, mehrere Schema-Typen können und sollten in einem zentralen `@graph`-Array unter `{"@context": "https://schema.org", "@graph": [...]}` zusammengefasst werden. Dieser W3C JSON-LD-Standard ermöglicht eine kohärente Modellierung von Multi-Entity-Knowledge-Graphen, bei der ein `Organization`-Knoten mit `@id: "https://example.com/#org"` direkt von der `publisher`-Eigenschaft eines `Article` oder der `manufacturer`-Eigenschaft eines `Product` referenziert wird. Die Knotenverknüpfung via URI-Referenzen eliminiert redundanten Code, beschleunigt das AST-Parsing der Suchmaschinen-Crawler und schafft eindeutigen semantischen Kontext.

Welche Eigenschaften sind für Google Product Rich Snippets zwingend erforderlich?▼

Google Search Central verlangt für jedes Product-Rich-Result zwingend `name`, `image` und mindestens ein kommerzielles Validierungsobjekt: entweder `offers` (mit `price`, `priceCurrency` und `availability`), `aggregateRating` (mit `ratingValue` und `reviewCount`) oder `review`. Für die Integration in kostenlose Google Merchant Center-Einträge verlangt Google zusätzlich eindeutige Produktkennzeichnungen wie `brand`, `sku` sowie globale Artikelnummern (`gtin13`, `gtin8` oder `mpn`), flankiert von strukturierten Matrizen zu Versand- und Rückgaberichtlinien.

Welche Schema-Markup-Typen erzielen die höchste Klickrate (CTR) in den SERPs?▼

Product-Schema mit aggregierten Sternebewertungen und Live-Preis-Badges erzielt den stärksten unmittelbaren kommerziellen CTR-Zuwachs (+25 % bis +42 %), dicht gefolgt von Recipe-Rich-Cards (+40 % bis +70 %) und FAQPage-Akkordeons (+30 % bis +60 % SERP-Pixelhöhe). Visuelle Goldsterne und Badge-Elemente lenken die Blickerfassung (Sakkaden) auf mobilen Bildschirmen gezielt auf das Ergebnis und steigern das Nutzerengagement gegenüber gewöhnlichen Textlinks drastisch, während Rich-Card-Karussells sprachbasierte Zero-Click-Suchanfragen dominieren.

Verwandte Tools & Hilfsprogramme

Alle Tools →
S3 Multipart-Upload & Part-RechnerEntwicklung

Berechnen Sie optimale AWS S3 Multipart-Upload-Part-Größen, Part-Anzahlen, RAM-Puffer, Transferzeiten und PUT-Kosten unter Einhaltung fester S3-Architekturgrenzen.

Tool öffnen→
Elasticsearch Shard & Cluster RechnerEntwicklung

Berechnen Sie Shard-Anzahl und Cluster-Dimensionierung für Elasticsearch. Ermitteln Sie Primär- und Replika-Speicher, Node-RAM, JVM-Heap-Grenzwerte und Disk-Watermark-Schwellenwerte.

Tool öffnen→
Connection-Pool-Rechner & DB-SizingEntwicklung

Enterprise-Rechner für Datenbank-Connection-Pools und Kapazitätsplanung. Berechnen Sie präzise Poolgrößen pro Kubernetes-Pod, verhindern Sie Thread-Thrashing, ermitteln Sie Queue-Wartezeiten und schützen Sie den Datenbankspeicher vor OOM-Crashes mithilfe von Little's Law, HikariCP-Sättigungsformeln und PgBouncer-Transaktions-Multiplexing.

Tool öffnen→
API Rate-Limit-Rechner & Token BucketEntwicklung

Interaktiver API-Rate-Limit-Rechner (Token Bucket & RPS) mit clientseitiger Echtzeit-Analyse und dynamischer Visualisierung.

Tool öffnen→
Widerstands-Farbcode-Rechner & DecoderEntwicklung

Farbcodierte Widerstände mit 3, 4, 5 und 6 Ringen präzise berechnen: Bidirektionale Dekodierung in Echtzeit, Toleranzbereich, Temperaturkoeffizienten-Drift, inverse E-Reihen-Synthese und SMD-Äquivalente nach IEC 60062.

Tool öffnen→
RabbitMQ Speicher & Durchsatz RechnerEntwicklung

Interaktiver RabbitMQ-Rechner für Speicher & Durchsatz mit clientseitiger Echtzeitanalyse und Visualisierung.

Tool öffnen→