Elasticsearch Shard & Cluster Rechner

Elasticsearch Shard & Cluster Rechner

Berechnen Sie Shard-Anzahl und Cluster-Dimensionierung für Elasticsearch. Ermitteln Sie Primär- und Replika-Speicher, Node-RAM, JVM-Heap-Grenzwerte und Disk-Watermark-Schwellenwerte.

Beispiel laden
Primärer Speicherbedarf9.92 TB
Gesamter Disk-Speicher24.80 TB
Aktive Shards398
Empfohlene Data Nodes7 Nodes
Master-Node-Quorum3 Dedicated
Heap-Shard-Status9%
Workload-Architektur

Time-series telemetry, container logs, and system metrics with ILM rollover and 1 replica.

250.0 GB / day
30 Days
Indexierungs-Overhead:+15%
Peak Burst:+15%
Disk-Watermark-Puffer:20%
Hardware- & Node-Spezifikationen
64 GB RAM
JVM-Heap-Verhältnis:31 GB Heap / 33 GB OS Cache

Compressed OOPs Enabled (< 31 GB): Halten Sie den JVM-Heap unter 31–32 GB, um Compressed OOPs aktiv zu halten und Speicher-Overhead zu vermeiden.

4.0 TB (4,000 GB)
20 shards / GB
10 (Conservative)20 (Official Default)25 (Aggressive)
Reverse-Kapazitätsrechner

Inverse Kapazitätsberechnung zur Ermittlung der erforderlichen Node- und Shard-Menge.

Max Safe Daily Ingestion278.3 GB / dayBottleneck: Disk Space
Max Shards Allowed3,7201,860 Primaries
Max Retention (Current Load)33 Days@ 250 GB/d
Cluster DimensionCalculated Metric
Primärer Speicherbedarf9.919 TB (9,918.8 GB)
Gesamtspeicher inkl. Replikas19.838 TB
Gesamtspeicher inkl. Sicherheitsmarge24.797 TB
Empfohlene Shard-Anzahl199 Primaries (398 Active)
Empfohlene Data Nodes7 Nodes
Master-Node-Quorum3 Dedicated Master Nodes
Coordinating Ingest NodesShared with Data
Cluster-Topologie (SVG)7 Data + 3 Master
DEDICATED MASTER QUORUM (Split-Brain Immune)master-01master-02master-03data-01SHARDSPR~57 shards9% densityHEAP 31GDISK 4.0Tdata-02SHARDSPR~57 shards9% densityHEAP 31GDISK 4.0Tdata-03SHARDSPR~57 shards9% densityHEAP 31GDISK 4.0Tdata-04SHARDSPR~57 shards9% densityHEAP 31GDISK 4.0Tdata-05SHARDSPR~57 shards9% densityHEAP 31GDISK 4.0Tdata-06SHARDSPR~57 shards9% densityHEAP 31GDISK 4.0Tdata-07SHARDSPR~57 shards9% densityHEAP 31GDISK 4.0T
CLUSTER HEALTH: OPTIMAL
Nodes: 7Shards: 398Disk: 24.80 TB
Technische Referenz & Architektur-Leitfaden

Elasticsearch Shard & Cluster Rechner — Referenzhandbuch

Berechnen Sie Elasticsearch-Shard-Zahlen und Cluster-Dimensionierungen. Ermitteln Sie Primär- und Replikat-Speicherbedarf, Node-RAM, JVM-Heap-Grenzwerte sowie Disk-Watermark-Sicherheitsgrenzen.

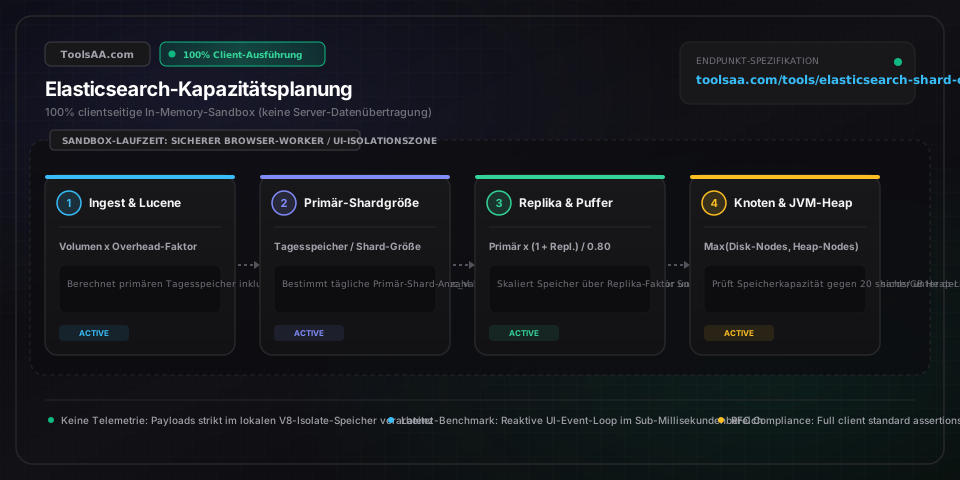
Elasticsearch Shard & Cluster Rechner — Referenzhandbuch — Client-seitige In-Memory-Architektur und Datenfluss

Wichtige Parameter & Einstellungen

Tägliches Ingestion-VolumenGigabyte pro Tag (GB/Tag)

Unkomprimiertes Rohdatenvolumen, das pro 24-Stunden-Zyklus vor der internen Lucene-Index-Expansion in Elasticsearch indexiert wird.

Standard: 100 GB/Tag
Zielgröße des Primär-ShardsGigabyte pro Shard (GB)

Goldstandard: 10 GB bis 30 GB für reine Such-Workloads; 30 GB bis 50 GB für Time-Series-Logs und Metrik-Analysen. Mehr als 50 GB birgt Risiken für langwierige Shard-Recoveries und Rebalance-Timeouts.

Standard: 50 GB
Replikat-Anzahl (number_of_replicas)Ganzzahlige Replikatkopien

Anzahl redundanter Kopien pro Primär-Shard. Ein Wert von 1 gewährleistet Hochverfügbarkeit gegen den Ausfall einzelner Nodes und verdoppelt den Lesedurchsatz; 2 Replikate schützen vor gleichzeitigem Ausfall zweier Nodes.

Standard: 1
JVM-Heap-AllokationGigabyte RAM (GB)

Die bewährte 50%-Regel weist die Hälfte des physischen Node-RAMs dem JVM-Heap zu und reserviert 50 % für den OS-Dateisystemcache (Lucene mmapfs). Darf 31 GB keinesfalls überschreiten, um Compressed OOPs (Compressed Ordinary Object Pointers) beizubehalten.

Standard: 31 GB
Shard-zu-Heap-VerhältnisShards pro GB JVM-Heap

Offizielle architektonische Obergrenze von Elastic: maximal 20 Shards pro 1 GB JVM-Heap (z. B. bis zu 600 Shards bei 30 GB Heap). Konservativer Produktionsrichtwert: 10 bis 15 Shards/GB, um Heap-Erschöpfung durch Segment-Metadaten zu vermeiden.

Standard: 20 Shards/GB
Disk-Watermark-SicherheitspufferProzentualer Headroom (%)

Nicht zugewiesener Speicherpuffer, der die Festplattenbelegung zuverlässig unter dem Low Watermark von 85 % (Stopp neuer Shard-Zuweisungen) und dem High Watermark von 90 % (aktive Shard-Umlagerung) hält.

Standard: 20%

Profi-Tipps & Best Practices

Die 31-GB-Klippe der Compressed OOPs

Konfigurieren Sie die Heap-Zuweisung via ES_JAVA_OPTS niemals auf 32 GB oder höher. Ab circa 31,5 GB schaltet die JVM von 32-Bit komprimierten Objekt-Pointern (Compressed OOPs) auf unkomprimierte 64-Bit-Zeiger um. Dies verbraucht schlagartig rund 40 % mehr Speicher für exakt dieselben Objektreferenzen – ein 32-GB-Heap bietet somit effektiv deutlich weniger nutzbaren Arbeitsspeicher als ein 31-GB-Heap.

Rollover-API vs. tägliches Index-Oversharding

Vermeiden Sie starre, datumsbasierte Indexmuster wie logstash-JJJJ.MM.TT mit fixen Shard-Zahlen. Schwach ausgelastete Tage erzeugen winzige 100-MB-Shards, Lastspitzen hingegen riskante 80-GB-Monster-Shards. Nutzen Sie Index Lifecycle Management (ILM) mit der Rollover-API (definiert über 'max_primary_shard_size: 50gb' oder 'max_age: 30d'), um konsistente Shard-Größen zu garantieren und Oversharding zu eliminieren.

Die 50%-Regel für den Lucene-Segmentcache

Weisen Sie dem Elasticsearch-JVM-Heap niemals mehr als 50 % des gesamten physischen System-RAMs zu. Lucene ist elementar auf den Page-Cache des Linux-Betriebssystems angewiesen, um Indexsegmentdateien, invertierte Indizes und doc_values im Speicher vorzuhalten. Ein ausgehungerter OS-Cache erzwingt massive Disk-I/O-Zugriffe, lässt Abfragelatenzen explodieren und treibt Garbage-Collection-Pausezeiten in die Höhe.

Quorum-Formel für Dedicated Master Nodes

Betreiben Sie bei Clustern ab 6 Nodes oder geschäftskritischen Workloads exakt 3 dedizierte Master-Eligible-Nodes (konfiguriert via node.roles: [master]). Dies erfüllt die Quorum-Formel (N / 2) + 1 = 2 Stimmen zur Vermeidung von Split-Brain-Partitionen, ohne kostenintensive Storage- oder Compute-Ressourcen für Master-Aufgaben zu vergeuden.

Häufige Fehlerquellen & Fehlerbehebung

⚠️Cluster wechselt auf Status Rot oder Gelb mit UNASSIGNED Shards

Prüfen Sie den Clusterzustand via GET _cluster/allocation/explain. Die zwei häufigsten Ursachen: (1) Die Festplattenbelegung eines Data Nodes hat den Low Watermark von 85 % überschritten, sodass Elasticsearch keine Replikat-Shards zuweisen kann; (2) number_of_replicas ist gleich hoch oder höher als die Gesamtzahl der Data Nodes eingestellt. Reduzieren Sie die Replikat-Anzahl oder erweitern Sie den Speicherplatz.

⚠️Cluster im Read-Only-Modus gesperrt bei 95 % Flood Stage

Erreicht ein beliebiger Data Node den Flood-Stage-Watermark von 95 %, setzt Elasticsearch automatisch cluster.blocks.read_only_allow_delete: true auf allen Indizes. Löschen Sie veraltete Indizes oder vergrößern Sie die Laufwerke, und führen Sie anschließend PUT */_settings mit {'index.blocks.read_only_allow_delete': null} aus, um Schreiboperationen wieder zu aktivieren.

⚠️CircuitBreakingException [parent] Data Too Large auf der JVM

Dieser Fehler tritt auf, wenn das Speicher-Tracking der Parent-Circuits 95 % des Heaps übersteigt. Auslöser sind hohe Segmentzahlen durch Oversharding, ungefilterte Fielddata-Strukturen auf Textfeldern oder exzessiv große Aggregation-Buckets. Führen Sie _forcemerge?max_num_segments=1 auf schreibgeschützten Indizes durch und verringern Sie die Gesamtzahl aktiver Shards.

Häufig gestellte Fragen (FAQ)

Wie berechnet man die Shard-Größe in Elasticsearch?▼

Die Primär-Shard-Größe entspricht (Tägliches Ingestion-Volumen in GB * (1 + Indexierungs-Overhead-Faktor)) geteilt durch die Anzahl der Primär-Shards. Ermitteln Sie in Produktivsystemen die tatsächliche Belegung per GET _cat/shards?v&h=index,shard,prirep,store, um den realen Disk-Footprint einschließlich doc_values und Segment-Metadaten exakt zu messen.

Was ist die empfohlene maximale Shard-Größe für Elasticsearch?▼

Die offizielle Richtlinie empfiehlt maximal 50 GB pro Shard für Time-Series-Logs, Metriken und Security-Events sowie 20 GB bis 30 GB für latenzkritische Suchkataloge. Shards über 65 GB leiden unter drastischem Lucene-Segment-Merge-Overhead, verlängerten Cluster-Rebalancing-Phasen und extrem verlangsamten Snapshot-Restores.

Wie viele Shards sollte man pro GB JVM-Heap betreiben?▼

Halten Sie eine strikte Obergrenze von maximal 20 Shards pro 1 GB konfiguriertem JVM-Heap ein. Ein Node mit dem Standardlimit von 30 GB Heap kann somit bis zu 600 Shards (Summe aus Primär- und Replikat-Shards) sicher verwalten. Ein Betrieb über 20 Shards/GB führt zu clusterweiter Instabilität und Out-of-Memory-Abstürzen durch Segment-Metadaten-Overhead.

Was ist der Unterschied zwischen Primär-Shards und Replikat-Shards?▼

Primär-Shards sind die originären Partitionen indexierter Dokumente, auf denen Schreiboperationen primär verarbeitet werden. Replikat-Shards sind synchrone 1:1-Duplikate der Primär-Shards, die Hardware-Ausfallsicherheit (Hochverfügbarkeit) bieten und den Lese- und Suchdurchsatz über mehrere Nodes hinweg skalieren. Replikate werden niemals auf demselben physischen Node wie ihr zugehöriger Primär-Shard abgelegt.

Warum steht mein Elasticsearch-Cluster auf Status Rot wegen unassigned Shards?▼

Der Status Rot bedeutet, dass mindestens ein Primär-Shard keinem Node zugewiesen werden kann, was sofortige Datenunverfügbarkeit zur Folge hat. Häufige Ursachen sind das Überschreiten des 95%-Flood-Stage-Watermarks, der Ausfall eines Hosts mit unreplizierten Primär-Shards oder beschädigte Lucene-Segmentdateien auf dem Datenträger. Führen Sie GET _cluster/allocation/explain aus, um den genauen Blockierungsgrund zu ermitteln.

Verwandte Tools & Hilfsprogramme

Alle Tools →
Connection-Pool-Rechner & DB-SizingEntwicklung

Enterprise-Rechner für Datenbank-Connection-Pools und Kapazitätsplanung. Berechnen Sie präzise Poolgrößen pro Kubernetes-Pod, verhindern Sie Thread-Thrashing, ermitteln Sie Queue-Wartezeiten und schützen Sie den Datenbankspeicher vor OOM-Crashes mithilfe von Little's Law, HikariCP-Sättigungsformeln und PgBouncer-Transaktions-Multiplexing.

Tool öffnen→
API Rate-Limit-Rechner & Token BucketEntwicklung

Interaktiver API-Rate-Limit-Rechner (Token Bucket & RPS) mit clientseitiger Echtzeit-Analyse und dynamischer Visualisierung.

Tool öffnen→
Widerstands-Farbcode-Rechner & DecoderEntwicklung

Farbcodierte Widerstände mit 3, 4, 5 und 6 Ringen präzise berechnen: Bidirektionale Dekodierung in Echtzeit, Toleranzbereich, Temperaturkoeffizienten-Drift, inverse E-Reihen-Synthese und SMD-Äquivalente nach IEC 60062.

Tool öffnen→
RabbitMQ Speicher & Durchsatz RechnerEntwicklung

Interaktiver RabbitMQ-Rechner für Speicher & Durchsatz mit clientseitiger Echtzeitanalyse und Visualisierung.

Tool öffnen→
PostgreSQL-Speicherrechner & PGTuneEntwicklung

PostgreSQL-Speicher berechnen und optimierte PGTune-Parameter für die postgresql.conf generieren. Optimieren Sie shared_buffers, work_mem, effective_cache_size und max_connections.

Tool öffnen→
RAID-Rechner & ZFS-KapazitätEntwicklung

Berechnen Sie die nutzbare Speicherkapazität in dezimalen TB und binären TiB für RAID 0, 1, 5, 6, 10, 50, 60 sowie ZFS RAIDZ1/Z2/Z3 inklusive Paritäts-Overhead, URE-Rebuild-Risiko, Rebuild-Dauer und Drive-Bay-Visualisierung.

Tool öffnen→