Calculadora Shards & Clúster (ES)

Calculadora Shards & Clúster (ES)

Calcula la cantidad de shards y el dimensionamiento del clúster en Elasticsearch. Estima el almacenamiento primario y de réplicas, la RAM por nodo, los límites de heap de la JVM y los umbrales de seguridad de watermark en disco.

Cargar ejemplo
Almacenamiento primario9.92 TB
Disco total24.80 TB
Shards activos398
Nodos de datos recomendados7 Nodes
Quórum de masters3 Dedicated
Salud de heap y shards9%
Arquitectura de carga de trabajo

Time-series telemetry, container logs, and system metrics with ILM rollover and 1 replica.

250.0 GB / day
30 Days
Sobrecarga de indexación:+15%
Peak Burst:+15%
Margen de watermark:20%
Especificaciones de hardware del nodo
64 GB RAM
Ratio de heap JVM:31 GB Heap / 33 GB OS Cache

Compressed OOPs Enabled (< 31 GB): Sugerencia sobre Compressed OOPs

4.0 TB (4,000 GB)
20 shards / GB
10 (Conservative)20 (Official Default)25 (Aggressive)
Cálculo inverso de capacidad

Cálculo inverso de capacidad

Max Safe Daily Ingestion278.3 GB / dayBottleneck: Disk Space
Max Shards Allowed3,7201,860 Primaries
Max Retention (Current Load)33 Days@ 250 GB/d
Cluster DimensionCalculated Metric
Almacenamiento primario9.919 TB (9,918.8 GB)
Almacenamiento replicado19.838 TB
Disco total con margen de seguridad24.797 TB
Shards recomendados199 Primaries (398 Active)
Nodos de datos recomendados7 Nodes
Quórum de masters3 Dedicated Master Nodes
Coordinating Ingest NodesShared with Data
Topología del clúster (SVG)7 Data + 3 Master
DEDICATED MASTER QUORUM (Split-Brain Immune)master-01master-02master-03data-01SHARDSPR~57 shards9% densityHEAP 31GDISK 4.0Tdata-02SHARDSPR~57 shards9% densityHEAP 31GDISK 4.0Tdata-03SHARDSPR~57 shards9% densityHEAP 31GDISK 4.0Tdata-04SHARDSPR~57 shards9% densityHEAP 31GDISK 4.0Tdata-05SHARDSPR~57 shards9% densityHEAP 31GDISK 4.0Tdata-06SHARDSPR~57 shards9% densityHEAP 31GDISK 4.0Tdata-07SHARDSPR~57 shards9% densityHEAP 31GDISK 4.0T
CLUSTER HEALTH: OPTIMAL
Nodes: 7Shards: 398Disk: 24.80 TB
Referencia técnica y guía de arquitectura

Guía Shards & Clúster Elasticsearch — Guía de referencia

Calcula la cantidad de shards y el dimensionamiento de clústeres en Elasticsearch. Estima almacenamiento primario y réplicas, RAM por nodo, límites de heap JVM y umbrales de seguridad (watermarks) de disco.

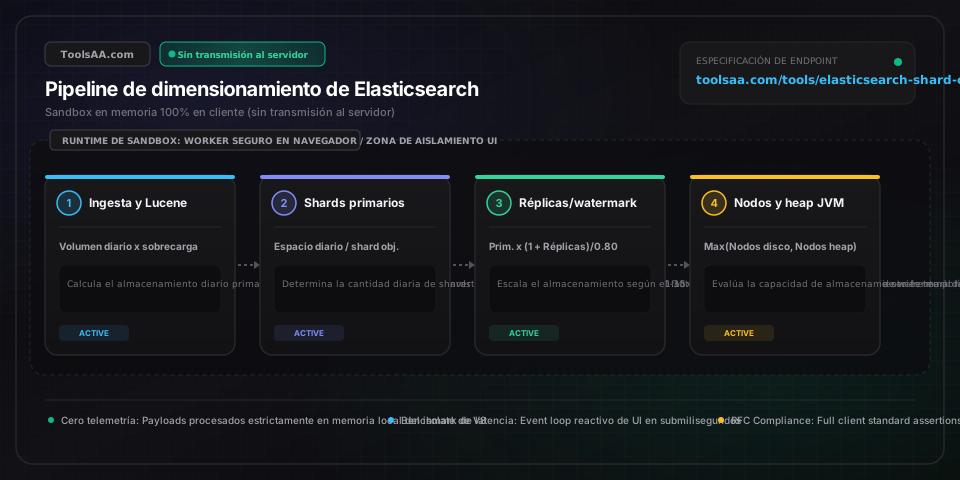
Guía Shards & Clúster Elasticsearch — Guía de referencia — Arquitectura en memoria del lado del cliente y flujo de datos

Parámetros clave y controles

Volumen de ingesta diariaGigabytes por día (GB/día)

Volumen de documentos sin procesar ni comprimir indexados en Elasticsearch por ciclo de 24 horas antes de la expansión interna de Lucene.

Por defecto: 100 GB/día
Tamaño objetivo del shard primarioGigabytes por shard (GB)

Estándar de referencia: de 10 GB a 30 GB para cargas de trabajo de búsqueda; de 30 GB a 50 GB para análisis de logs y métricas de series temporales. Superar los 50 GB incrementa el riesgo de tiempos de espera críticos en recuperación y rebalanceo de shards.

Por defecto: 50 GB
Cantidad de réplicas (number_of_replicas)Copias de réplica (entero)

Número de copias redundantes por cada shard primario. Un valor de 1 proporciona alta disponibilidad ante la caída de un nodo y duplica la capacidad de lectura; 2 réplicas protegen frente a fallos simultáneos de dos nodos.

Por defecto: 1
Asignación de heap JVMGigabytes de RAM (GB)

La regla estándar del 50 % asigna la mitad de la RAM física del nodo al heap de la JVM y reserva el 50 % restante para la caché del sistema de archivos del SO (mmapfs de Lucene). Jamás debe superar los 31 GB para preservar los punteros a objetos ordinarios comprimidos (Compressed OOPs).

Por defecto: 31 GB
Relación shards por heapShards por GB de heap JVM

El límite arquitectónico oficial de Elastic es de 20 shards por cada 1 GB de heap JVM (p. ej., un heap de 30 GB soporta hasta 600 shards). El umbral conservador recomendado para producción es de 10 a 15 shards/GB para prevenir el agotamiento de memoria por metadatos de segmentos.

Por defecto: 20 shards/GB
Margen de seguridad de watermark en discoMargen de reserva en porcentaje (%)

Margen de almacenamiento en disco sin asignar para asegurar que la ocupación del nodo permanezca holgadamente por debajo de la marca baja del 85 % (detiene la asignación de nuevos shards) y de la marca alta del 90 % (activa la reubicación activa de shards).

Por defecto: 20%

Consejos profesionales y mejores prácticas

El abismo del umbral de 31 GB en Compressed OOPs

Nunca configures la asignación de heap en ES_JAVA_OPTS en 32 GB o más. A partir de aproximadamente 31,5 GB, la JVM cambia de punteros a objetos comprimidos de 32 bits (Compressed OOPs) a punteros sin comprimir de 64 bits. Esto consume de inmediato cerca de un 40 % más de memoria para las mismas referencias a objetos, por lo que un heap de 32 GB ofrece sensiblemente menos memoria útil real que uno de 31 GB.

Rollover API frente al oversharding diario

Evita patrones de índice rígidos basados en fechas como logstash-YYYY.MM.DD con cantidades estáticas de shards. Los días con bajo tráfico generan shards minúsculos de 100 MB, mientras que los picos crean shards monstruosos de 80 GB. Emplea Index Lifecycle Management (ILM) con la Rollover API configurada con 'max_primary_shard_size: 50gb' o 'max_age: 30d' para garantizar tamaños de shard homogéneos y erradicar la sobrefragmentación (oversharding).

Regla del 50 % para la caché de segmentos de Lucene

Jamás asignes más del 50 % de la RAM total del sistema al heap de la JVM de Elasticsearch. Lucene depende críticamente de la caché de páginas del kernel de Linux para mantener en memoria los archivos de segmentos, los índices invertidos y los doc_values. Privar de memoria a la caché del sistema operativo dispara las operaciones de E/S de lectura en disco, elevando drásticamente las latencias de búsqueda y las pausas del recolector de basura (Garbage Collection).

Fórmula de quórum para nodos maestros dedicados

En clústeres de 6 o más nodos o con cargas de trabajo de misión crítica, despliega exactamente 3 nodos maestros dedicados elegibles (configurados con node.roles: [master]). Esto satisface la fórmula de quórum (N / 2) + 1 = 2 votos para prevenir particiones de cerebro dividido (split-brain) sin malgastar almacenamiento de alto rendimiento ni recursos de cómputo en tareas maestras.

Problemas comunes y soluciones

⚠️El clúster pasa a estado Red o Yellow con shards UNASSIGNED

Ejecuta GET _cluster/allocation/explain. Las dos causas más habituales son: (1) El uso de disco en un nodo de datos superó la marca de agua baja (low watermark) del 85 %, lo que impide a Elasticsearch ubicar shards de réplica; (2) number_of_replicas está configurado en un valor igual o superior a la cantidad total de nodos de datos. Reduce el recuento de réplicas o amplía la capacidad de almacenamiento.

⚠️Clúster bloqueado en modo solo lectura por Flood Stage al 95 %

Cuando cualquier nodo de datos alcanza la marca de inundación (flood stage watermark) del 95 %, Elasticsearch aplica automáticamente cluster.blocks.read_only_allow_delete: true en todos los índices. Elimina índices obsoletos o amplía los discos, y después ejecuta PUT */_settings con {'index.blocks.read_only_allow_delete': null} para restaurar las operaciones de escritura.

⚠️Excepción CircuitBreakingException [parent] Data Too Large en JVM

Este error ocurre cuando el rastreo de memoria de los circuitos padre excede el 95 % del heap. Se produce por un recuento elevado de segmentos debido al oversharding, acumulación de fielddata en campos de texto sin depurar o buckets de agregación masivos. Consolida índices pequeños ejecutando _forcemerge?max_num_segments=1 en índices de solo lectura y reduce la cantidad total de shards activos.

Preguntas frecuentes (FAQ)

¿Cómo se calcula el tamaño de un shard en Elasticsearch?▼

El tamaño del shard primario equivale a (Volumen diario de ingesta en GB * (1 + Multiplicador de sobrecarga de indexación)) dividido entre el número de shards primarios. En entornos de producción, audita el uso real en disco mediante GET _cat/shards?v&h=index,shard,prirep,store para observar la huella física exacta en almacenamiento, incluyendo doc_values y metadatos de segmentos.

¿Cuál es el tamaño máximo recomendado para un shard en Elasticsearch?▼

La recomendación oficial máxima es de 50 GB por shard para registros de series temporales, métricas y eventos de seguridad (SIEM), y de 20 GB a 30 GB para catálogos de búsqueda de baja latencia. Los shards que superan los 65 GB sufren una sobrecarga crítica en las fusiones de segmentos de Lucene, rebalanceos prolongados del clúster y restauraciones de snapshots excesivamente lentas.

¿Cuántos shards se deben alojar por cada GB de heap?▼

Mantén un límite estricto de 20 shards por cada 1 GB de heap asignado a la JVM. Un nodo configurado con el techo estándar de 30 GB de heap puede soportar de manera segura hasta 600 shards en total (sumando shards primarios y réplicas). Operar por encima de 20 shards/GB compromete la estabilidad del clúster y provoca caídas por falta de memoria (OOM) debido al consumo de metadatos de segmentos.

¿Cuál es la diferencia entre shards primarios y shards de réplica?▼

Los shards primarios son las particiones originales que contienen los documentos indexados y donde se procesan primero las operaciones de escritura. Los shards de réplica son duplicados sincrónicos exactos de los primarios que proporcionan tolerancia a fallos de hardware (alta disponibilidad) y permiten escalar el rendimiento de las consultas de lectura entre múltiples nodos. Una réplica nunca se aloja en el mismo nodo físico que su shard primario homólogo.

¿Por qué mi clúster de Elasticsearch está en estado rojo por shards sin asignar?▼

El estado rojo (red) indica que uno o más shards primarios no se han podido asignar a ningún nodo, lo que genera indisponibilidad inmediata de datos. Ocurre con frecuencia si el disco superó la marca de agua de inundación (flood stage) del 95 %, si cayó un host con shards primarios sin réplica o si existen archivos de segmentos de Lucene corruptos en el disco. Ejecuta GET _cluster/allocation/explain para identificar el motivo exacto del bloqueo.

Herramientas y utilidades relacionadas

Todas las herramientas →
Calculadora de Pool de Conexiones & BDDesarrollo

Calculadora y banco de trabajo para la planificación de capacidad y pools de conexiones a bases de datos en producción. Calcula con precisión el tamaño óptimo de pool por pod de Kubernetes, previene la sobrecarga de hilos (thread thrashing), estima los tiempos de espera en cola y protege la memoria de la base de datos contra caídas por falta de memoria (OOM) mediante la ley de Little, las fórmulas de saturación de núcleos de HikariCP y los ratios de multiplexación de transacciones de PgBouncer.

Abrir herramienta→
Calculadora Rate Limit API & TokensDesarrollo

Calculadora interactiva de Rate Limit para API (Token Bucket y RPS) con análisis y visualización en tiempo real en el cliente.

Abrir herramienta→
Código de Colores de ResistenciasDesarrollo

Calcula el código de colores de resistencias de 3, 4, 5 y 6 bandas con decodificación bidireccional instantánea, márgenes de tolerancia, deriva por coeficiente de temperatura (TCR), síntesis inversa de valores en series E y equivalencias SMD según la norma IEC 60062.

Abrir herramienta→
Calculadora RabbitMQ & RendimientoDesarrollo

Calculadora interactiva de memoria y rendimiento para colas RabbitMQ con análisis y visualización en tiempo real en el cliente.

Abrir herramienta→
Calculadora Memoria PostgreSQL & PGTuneDesarrollo

Calcula la memoria para PostgreSQL y genera parámetros de postgresql.conf con PGTune. Optimiza shared_buffers, work_mem, effective_cache_size y max_connections.

Abrir herramienta→
Calculadora de Capacidad RAID & ZFSDesarrollo

Calcula la capacidad de almacenamiento útil en TB decimales y TiB binarios para configuraciones RAID 0, 1, 5, 6, 10, 50, 60 y ZFS RAIDZ1/Z2/Z3, con sobrecarga de paridad, riesgo de fallo por URE en reconstrucción, tiempo estimado y visualizador de bahías.

Abrir herramienta→