Calcul Shards & Cluster Elasticsearch

Calcul Shards & Cluster Elasticsearch

Calculez le nombre de shards et le dimensionnement de cluster Elasticsearch. Estimez le stockage primaire et répliqué, la RAM par nœud, les limites de heap JVM et les seuils de sécurité disk watermark.

Charger un exemple
Stockage primaire9.92 TB
Espace disque total24.80 TB
Shards actifs398
Nœuds de données recommandés7 Nodes
Quorum des nœuds maîtres3 Dedicated
Santé heap / shards9%
Architecture de charge de travail

Time-series telemetry, container logs, and system metrics with ILM rollover and 1 replica.

250.0 GB / day
30 Days
Surcoût d'indexation:+15%
Peak Burst:+15%
Marge de sécurité watermark:20%
Spécifications matérielles des nœuds
64 GB RAM
Ratio de heap JVM:31 GB Heap / 33 GB OS Cache

Compressed OOPs Enabled (< 31 GB): Maintenez le heap JVM sous 31 Go pour activer les Compressed OOPs (pointeurs 32 bits).

4.0 TB (4,000 GB)
20 shards / GB
10 (Conservative)20 (Official Default)25 (Aggressive)
Calculateur inverse de capacité

Résolution inverse de capacité : calcule le volume de données admissible selon vos ressources matérielles.

Max Safe Daily Ingestion278.3 GB / dayBottleneck: Disk Space
Max Shards Allowed3,7201,860 Primaries
Max Retention (Current Load)33 Days@ 250 GB/d
Cluster DimensionCalculated Metric
Stockage primaire9.919 TB (9,918.8 GB)
Stockage total répliqué19.838 TB
Disque total avec marge de sécurité24.797 TB
Shards recommandés199 Primaries (398 Active)
Nœuds de données recommandés7 Nodes
Quorum des nœuds maîtres3 Dedicated Master Nodes
Coordinating Ingest NodesShared with Data
Topologie du cluster (SVG)7 Data + 3 Master
DEDICATED MASTER QUORUM (Split-Brain Immune)master-01master-02master-03data-01SHARDSPR~57 shards9% densityHEAP 31GDISK 4.0Tdata-02SHARDSPR~57 shards9% densityHEAP 31GDISK 4.0Tdata-03SHARDSPR~57 shards9% densityHEAP 31GDISK 4.0Tdata-04SHARDSPR~57 shards9% densityHEAP 31GDISK 4.0Tdata-05SHARDSPR~57 shards9% densityHEAP 31GDISK 4.0Tdata-06SHARDSPR~57 shards9% densityHEAP 31GDISK 4.0Tdata-07SHARDSPR~57 shards9% densityHEAP 31GDISK 4.0T
CLUSTER HEALTH: OPTIMAL
Nodes: 7Shards: 398Disk: 24.80 TB
Référence technique et guide d'architecture

Calcul Shards & Cluster Elasticsearch — Guide de référence

Calculez le nombre de shards et le dimensionnement de votre cluster Elasticsearch. Évaluez le stockage primaire et réplica, la RAM par nœud, les limites du tas JVM et les seuils de sécurité disque.

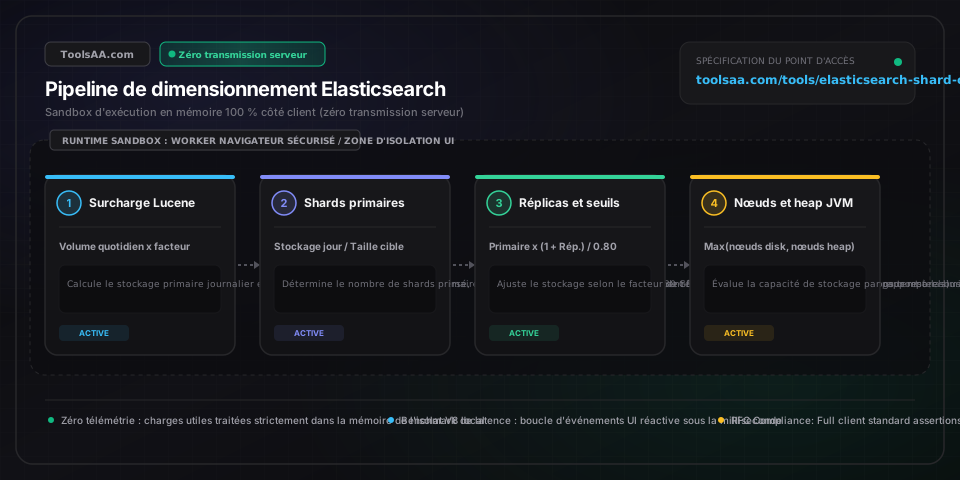
Calcul Shards & Cluster Elasticsearch — Guide de référence — Architecture en mémoire côté client et flux de données

Paramètres clés et contrôles

Volume d'ingestion quotidienGigaoctets par jour (Go/jour)

Volume brut de documents non compressés indexés dans Elasticsearch par cycle de 24 heures avant l'expansion Lucene.

Par défaut : 100 Go/jour
Taille cible du shard primaireGigaoctets par shard (Go)

Recommandation de référence : 10 Go à 30 Go pour les charges de recherche textuelle ; 30 Go à 50 Go pour les logs et métriques temporelles (time-series). Dépasser 50 Go expose à de longs délais de récupération (recovery) et d'expiration lors du rééquilibrage.

Par défaut : 50 Go
Nombre de réplicas (number_of_replicas)Nombre entier de réplicas

Nombre de copies redondantes par shard primaire. Une valeur de 1 assure la haute disponibilité contre la panne d'un nœud unique et double la capacité de lecture ; 2 réplicas protègent contre la défaillance simultanée de deux nœuds.

Par défaut : 1
Allocation du tas JVM (Heap)Gigaoctets de RAM (Go)

La règle standard des 50 % alloue la moitié de la RAM physique du nœud au tas JVM et réserve 50 % pour le cache du système de fichiers de l'OS (mmapfs Lucene). Ne doit impérativement jamais dépasser 31 Go pour préserver les pointeurs d'objets compressés (Compressed OOPs).

Par défaut : 31 Go
Ratio shards par Go de heapShards par Go de tas JVM

Le plafond architectural officiel d'Elastic est de 20 shards par Go de tas JVM (ex. un heap de 30 Go supporte jusqu'à 600 shards). En production, la recommandation prudente se situe entre 10 et 15 shards/Go pour éviter l'épuisement de la mémoire par les métadonnées de segments.

Par défaut : 20 shards/Go
Marge de sécurité disque (Watermark)Marge disponible en pourcentage (%)

Marge d'espace disque non alloué garantissant que l'occupation reste sous le seuil d'alerte bas de 85 % (arrêt d'allocation de nouveaux shards) et le seuil haut de 90 % (déclenchement de la relocalisation active des shards).

Par défaut : 20 %

Conseils de pro et bonnes pratiques

Le seuil critique des 31 Go et les Compressed OOPs

Ne configurez jamais l'allocation du tas (heap) via ES_JAVA_OPTS à 32 Go ou plus. À partir d'environ 31,5 Go, la JVM bascule des pointeurs d'objets compressés en 32 bits (Compressed OOPs) vers des pointeurs non compressés en 64 bits. Cela consomme immédiatement environ 40 % de mémoire supplémentaire pour référencer exactement les mêmes objets : un tas de 32 Go offre donc nettement moins de mémoire réellement exploitable qu'un tas de 31 Go.

API Rollover contre sur-sharding des index journaliers

Évitez les motifs d'index rigides basés sur la date comme logstash-YYYY.MM.DD avec un nombre fixe de shards. Les journées calmes génèrent des micro-shards de 100 Mo, tandis que les pics de trafic produisent des shards monstres de 80 Go. Utilisez l'Index Lifecycle Management (ILM) combiné à l'API Rollover avec 'max_primary_shard_size: 50gb' ou 'max_age: 30d' pour garantir une taille de shard homogène et éradiquer le sur-sharding (oversharding).

La règle des 50 % pour le cache de segments Lucene

N'allouez jamais plus de 50 % de la RAM système totale au tas JVM d'Elasticsearch. Le moteur Lucene s'appuie massivement sur le cache de pages du noyau Linux (Page Cache) pour conserver en mémoire les fichiers de segments d'index, les index inversés et les doc_values. Priver le système d'exploitation de ce cache provoque d'intenses opérations d'E/S disque (I/O), faisant exploser les temps de latence des requêtes et les pauses du ramasse-miettes (Garbage Collector).

Formule de quorum pour les nœuds Master dédiés

Pour les clusters comprenant 6 nœuds ou plus, ou hébergeant des charges de travail stratégiques, déployez exactement 3 nœuds éligibles au rôle de maître (configurés avec node.roles: [master]). Cette architecture satisfait la formule de quorum (N / 2) + 1 = 2 votes requise pour prévenir les partitions de type split-brain, sans gaspiller de ressources de calcul ou de stockage onéreuses sur les tâches de gestion du cluster.

Pièges courants et dépannage

⚠️Le cluster passe à l'état Red ou Yellow avec des shards UNASSIGNED

Exécutez GET _cluster/allocation/explain pour analyser le blocage. Les deux causes les plus fréquentes sont : (1) L'utilisation disque d'un nœud de données a franchi le seuil bas (low watermark) de 85 %, empêchant Elasticsearch d'allouer les shards réplicas ; (2) number_of_replicas est supérieur ou égal au nombre total de nœuds de données. Réduisez le nombre de réplicas ou augmentez l'espace disque disponible.

⚠️Cluster verrouillé en lecture seule au seuil critique de 95 % (Flood Stage)

Dès qu'un nœud de données atteint le seuil d'inondation de 95 % (flood stage watermark), Elasticsearch active automatiquement le blocage cluster.blocks.read_only_allow_delete: true sur l'ensemble des index. Supprimez des index obsolètes ou étendez les disques, puis exécutez la requête PUT */_settings avec {'index.blocks.read_only_allow_delete': null} pour rétablir les opérations d'écriture.

⚠️CircuitBreakingException [parent] Data Too Large sur la JVM

Cette exception survient lorsque le suivi mémoire des disjoncteurs parents dépasse 95 % du tas JVM. Elle est généralement causée par un nombre excessif de segments dû au sur-sharding, par des fielddata non purgées sur des champs textuels ou par de volumineuses agrégations. Consolidez les petits index en exécutant _forcemerge?max_num_segments=1 sur les index en lecture seule et réduisez le nombre global de shards actifs.

Foire aux questions (FAQ)

Comment calculer la taille d'un shard dans Elasticsearch ?▼

La taille d'un shard primaire est égale au (volume d'ingestion quotidien en Go * (1 + multiplicateur de surcoût d'indexation)) divisé par le nombre de shards primaires. En production, surveillez l'espace disque réel avec la commande GET _cat/shards?v&h=index,shard,prirep,store afin d'observer l'empreinte disque effective, incluant les doc_values et les métadonnées de segments.

Quelle est la taille maximale recommandée pour un shard Elasticsearch ?▼

La limite maximale officiellement recommandée est de 50 Go par shard pour les logs temporels, les métriques et les événements de sécurité, et de 20 Go à 30 Go pour les index de recherche nécessitant une faible latence. Les shards dépassant 65 Go subissent une dégradation sévère liée aux fusions de segments Lucene (merges), prolongent le rééquilibrage du cluster et ralentissent considérablement la restauration des snapshots.

Combien de shards peut-on allouer par Go de heap JVM ?▼

Maintenez une limite stricte de 20 shards au maximum par gigaoctet de tas JVM configuré. Un nœud doté du plafond standard de 30 Go de heap peut supporter en toute sécurité jusqu'à 600 shards au total (shards primaires et réplicas inclus). Dépasser 20 shards/Go expose le cluster à une instabilité globale et à des pannes par épuisement de mémoire (Out Of Memory) causées par la surcharge des métadonnées de segments.

Quelle est la différence entre shards primaires et shards réplicas ?▼

Les shards primaires sont les partitions d'origine hébergeant les documents indexés et traitant en premier les opérations d'écriture. Les shards réplicas sont des copies conformes synchronisées des shards primaires ; ils garantissent la tolérance aux pannes matérielles (haute disponibilité) et augmentent le débit des recherches en lecture sur plusieurs nœuds. Un réplica n'est jamais placé sur le même nœud physique que son shard primaire correspondant.

Pourquoi mon cluster Elasticsearch est-il à l'état rouge à cause de shards non assignés ?▼

L'état rouge (Red) indique qu'au moins un shard primaire ne peut être alloué sur aucun nœud, provoquant l'inaccessibilité immédiate d'une partie des données. Cette situation survient couramment lorsqu'un disque dépasse le seuil critique de 95 % (flood stage), qu'un hôte contenant des shards primaires sans réplica tombe en panne ou que des fichiers de segments Lucene sont corrompus sur le disque. Exécutez GET _cluster/allocation/explain pour identifier précisément la cause du blocage.

Outils et utilitaires connexes

Tous les outils →
Calculateur Pool de Connexions & BDDDéveloppement

Calculateur de pool de connexions et banc de dimensionnement de base de données de niveau production. Calculez précisément la taille optimale du pool par pod Kubernetes, prévenez le thread thrashing, estimez le temps d'attente en file et protégez la mémoire de la base contre les crashs OOM grâce à la loi de Little, aux formules de saturation HikariCP et aux ratios de multiplexage de PgBouncer.

Ouvrir l'outil→
Calculateur Rate Limit API (Token & RPS)Développement

High-performance processing executed entirely in browser memory.

Ouvrir l'outil→
Code Couleur Résistance & DécodeurDéveloppement

Calculez le code couleur des résistances à 3, 4, 5 et 6 anneaux avec décodage bidirectionnel instantané, enveloppes de tolérance, dérive du coefficient de température (TCR), synthèse inverse en séries E et équivalents CMS (SMD) selon la norme CEI 60062.

Ouvrir l'outil→
Dimensionnement RabbitMQ (RAM & Débit)Développement

Calculateur interactif de mémoire et débit RabbitMQ avec modélisation et analyse en temps réel côté client.

Ouvrir l'outil→
Calculateur Mémoire PostgreSQL & PGTuneDéveloppement

Calculez l'allocation mémoire PostgreSQL et générez les paramètres PGTune de postgresql.conf. Optimisez shared_buffers, work_mem, effective_cache_size et max_connections.

Ouvrir l'outil→
Calculateur de capacité RAID & ZFSDéveloppement

Calculez la capacité de stockage utile en To décimaux et Tio binaires pour grappes RAID 0, 1, 5, 6, 10, 50, 60 et ZFS RAIDZ1/Z2/Z3 avec surcoût de parité, risque d'erreur URE lors de la reconstruction, durée estimée et visualiseur de baies.

Ouvrir l'outil→