Calculateur de Capacité RAID & ZFS

Calculateur de capacité RAID & ZFS

Calculez la capacité de stockage utile en To décimaux et Tio binaires pour grappes RAID 0, 1, 5, 6, 10, 50, 60 et ZFS RAIDZ1/Z2/Z3 avec surcoût de parité, risque d'erreur URE lors de la reconstruction, durée estimée et visualiseur de baies.

Charger un exemple
Configuration de la grappe
Tolérance aux pannes:2 Drives per vdev
4 Disque
0 Disque de secours
Disques de données: 2 | Disques de parité: 2 | Disques Hot Spare: 04 Tolérance maximale aux pannes
Capacité utile (TiB)28.19 TiB
Efficacité du stockage48.4%
Capacité sûre 80 % (TiB)22.56 TiB
Risque d'erreur URE à la reconstruction0.0%
Durée de reconstruction22.2 Heures
Coût par Tio utile$38.31

Visualiseur de baies

ZFS RAIDZ2 (Dual Parity vdev) • 4 Baie En ligne

Données (2)Parité (2)
STORAGE CHASSIS ENCLOSURE // ZFS
#01
Disque #1 • 16 TBdata

En ligne • 7,200 RPM Enterprise HDD (~200 MB/s) • URE: 10⁻¹⁵ (1 sector per ~125 TB) - NAS Pro / CMR

Coût du disque:$270.00
Coût total: $1,080.00Coût par Tio utile: $38.31Coût par To utile: $34.84
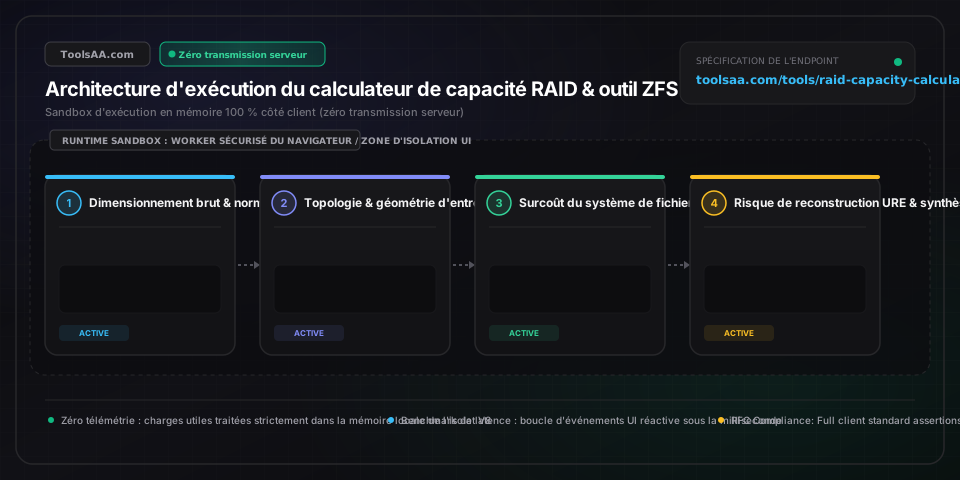
Référence technique et guide d'architecture

Calculateur Capacité RAID & Guide ZFS — Guide de référence

Calculez la capacité de stockage utile en To décimaux et Tio binaires pour les grappes RAID 0, 1, 5, 6, 10, 50, 60 et ZFS RAIDZ1/Z2/Z3, avec surcoût de parité, risque de panne URE lors de la reconstruction, durée de reconstruction et visualiseur de baies de disques.

Calculateur Capacité RAID & Guide ZFS — Guide de référence — Architecture en mémoire côté client et flux de données

Paramètres clés et contrôles

Ratio de conversion Téraoctets décimaux (To) vs Tébioctets binaires (Tio) (CEI 80000-13)Constante de conversion de base (Float64)

Régit l'écart mathématique de base entre l'étiquetage décimal des fabricants de disques (1 To = 10^12 octets) et l'adressage binaire des systèmes POSIX (1 Tio = 2^40 = 1 099 511 627 776 octets), conformément aux normes de précision CEI 80000-13 et IEEE 754-2019. Exécuté localement en JavaScript côté client avec une complexité O(1), ce facteur induit une réduction apparente immuable de 9,0949 % avant l'application des structures du système de fichiers ou du partitionnement GPT EFI.

Par défaut : 0.90949470177
Taux d'erreur binaire URE (Unrecoverable Read Error / BER)Constante exponentielle de Poisson

Probabilité statistique de rencontrer un secteur physique illisible lors d'une reconstruction séquentielle de grappe, modélisée par P(échec) = 1 - exp(-Bits_Totaux_Lus * BER). Les disques durs SATA grand public affichent un BER de 10^-14 (1 erreur de secteur pour 12,5 To lus), les disques SAS Nearline d'entreprise atteignent 10^-15 et les disques critiques d'entreprise SAS/NVMe U.2/U.3 atteignent 10^-16, dictant le seuil mathématique à partir duquel les topologies à double parité (RAID 6 / RAIDZ2) deviennent indispensables.

Par défaut : 1e-14 (SATA grand public)
Pénalité d'écriture du stockage (Multiplicateur RMW Read-Modify-Write)Coefficient multiplicateur d'E/S

Quantifie le nombre de transactions d'E/S physiques (plateau/NAND) requises pour valider une unique écriture aléatoire par bande selon la sémantique POSIX. Le RAID 0 génère 1 opération d'E/S, le RAID 1/10 en génère 2 (écritures miroir parallèles), le RAID 5 en nécessite 4 (2 lectures + 2 écritures pour les données et la parité) et le RAID 6 en impose 6 (3 lectures + 3 écritures sur les syndromes P+Q calculés sur le corps de Galois GF(2^8)), définissant ainsi le dimensionnement des tampons de coalescence d'écriture en mémoire.

Par défaut : 4 (RAID 5) / 6 (RAID 6)
Espace tampon OpenZFS Slop Space & Géométrie de secteur vdev ashiftIndicateur de mémoire noyau / Géométrie vdev

Réserve au niveau du noyau de 1/32e (3,125 %, minimum 128 Mio) de la capacité brute du pool zpool via vdev_slop_shift=5, garantissant l'exécution des opérations administratives critiques (zfs destroy, zfs rollback) sans déclencher de panique de saturation POSIX ENOSPC. Impose ashift=12 (alignement sur des blocs de 4 096 octets) afin de prévenir une amplification d'écriture de plus de 300 % sur les secteurs physiques Advanced Format 512e et 4Kn.

Par défaut : Réserve de 3,125 % (ashift=12)
Bac à sable navigateur zéro télémétrie & Isolation cryptographiqueContrat d'isolation côté client

Garantit que l'intégralité des calculs de grappe, des vecteurs de survie de Poisson et des géométries de parité s'exécutent exclusivement au sein du bac à sable WebAssembly/V8 du client, sans aucune télémétrie réseau ni transmission vers un serveur. Les topologies de stockage, les numéros de série des disques et les volumétries de banques de données demeurent isolés dans la mémoire volatile locale, conformément aux architectures Zero Trust et à la confidentialité cryptographique.

Par défaut : Bac à sable client isolé (0 octet d'E/S réseau)

Conseils de pro et bonnes pratiques

La chute brutale de performances à 80 % en Copy-on-Write

Ne dépassez jamais 80 % d'allocation sur les pools de stockage Copy-on-Write (ZFS / Btrfs). Au-delà de ce seuil, l'allocateur d'espace de ZFS abandonne l'algorithme premier ajustement (first-fit) en O(1) de sa table d'espace (space map) pour une recherche exhaustive du meilleur ajustement (best-fit) à travers les métadalles (metaslabs). Cela engendre une fragmentation catastrophique, anéantit la localité des écritures séquentielles et effondre les IOPS d'écriture aléatoire jusqu'à 70 %.

Le piège des IOPS aléatoires des vdevs larges en RAIDZ

Un vdev ZFS RAIDZ unique ne délivre les performances en IOPS d'écriture aléatoire que d'UN SEUL disque constitutif, qu'il regroupe 4 ou 24 disques. Configurer un châssis de 24 baies en un seul vdev RAIDZ2 de 24 disques paralyse les banques de données de machines virtuelles et le débit des journaux de transactions de bases de données. Pour faire évoluer les IOPS de manière linéaire, agrégez en striping plusieurs vdevs plus étroits (par ex. quatre vdevs RAIDZ2 de 6 disques) ou déployez des miroirs de vdevs (équivalent RAID 10).

Inadéquation de taille de secteur et amplification d'écriture ashift=12

Formatez systématiquement les disques durs et SSD modernes à secteurs avancés 4Kn et 512e avec le paramètre ashift=12 (alignement sur des secteurs de 4 096 octets) lors de la création d'un pool ZFS (`zpool create -o ashift=12`). Conserver la valeur par défaut héritée ashift=9 (secteurs de 512 octets) force le fractionnement des secteurs natifs de 4 Ko sur plusieurs écritures physiques, déclenchant une pénalité d'amplification d'écriture inévitable supérieure à 300 % qui dégrade les débits d'E/S et accélère l'usure de la mémoire Flash NAND.

Disparité de survie entre double parité et disque de secours Hot Spare

Faire évoluer un pool de stockage d'une configuration RAID 5 + disque de secours dédié (Hot Spare) vers une grappe active en RAID 6 à nombre de disques identique procure une résilience exponentiellement supérieure. Un disque de secours reste totalement inactif en régime normal et n'offre aucune redondance durant la phase critique de reconstruction sous forte charge. À l'inverse, le RAID 6 maintient en permanence une double parité Reed-Solomon active, survivant à la défaillance d'un second disque ou à une erreur URE tout au long de la reconstruction.

Pièges courants et dépannage

⚠️La capacité utile du système de fichiers sous l'OS est de 4 % à 9 % inférieure au volume brut calculé

La réserve de blocs root et les métadonnées de partitionnement consomment des blocs bruts. Sous Linux, ext4 réserve automatiquement 5 % des blocs du volume au superutilisateur root pour éviter tout blocage critique du système ; vous pouvez récupérer cet espace sur les points de montage non-système avec la commande 'tune2fs -m 1 /dev/sdX' afin de réduire cette réserve à 1 %. Prenez également en compte les tables de partitions GPT EFI, les extensions de métadonnées LVM (4 à 8 Mio) ainsi que les 3,125 % de slop space ZFS ('spa_slop_shift=5') réservés aux opérations de snapshots et de suppression de fichiers en Copy-on-Write.

⚠️Une erreur de lecture irrécupérable (URE) interrompt la reconstruction et passe le pool hors ligne

Une défaillance de lecture secondaire immédiate lors de la reconstruction d'un RAID 5 à simple parité survient lorsqu'un secteur illisible est rencontré sur l'un des disques survivants de 8 To ou plus. Interrompez immédiatement toutes les écritures et générez une copie bit à bit de chaque disque survivant vers un support de secours avec 'ddrescue -b 4096 /dev/sdX /media/recuperation.img' avant d'exécuter fsck ou de réinitialiser les métadonnées. Pour prévenir cette vulnérabilité sur vos futures grappes, imposez la double parité (RAID 6 ou RAIDZ2) pour tout ensemble de disques >= 4 To afin de tolérer les erreurs de lecture de secteurs secondaires.

⚠️Engorgement sévère des disques et dégradation des débits durant le resilvering d'un pool ZFS

Les conflits de reconstruction (resilvering) proviennent souvent de goulots d'étranglement liés au cache des disques à enregistrement magnétique shinglé (SMR) ou d'une pénurie de métadonnées dans un cache ARC (Adaptive Replacement Cache) sous-dimensionné. Vérifiez avec 'smartctl -i /dev/sdX' que vos disques utilisent l'enregistrement magnétique conventionnel (CMR) ; remplacez immédiatement tout disque SMR géré par l'hôte ou par le disque (Host-Managed / Drive-Managed). Pour stabiliser les charges de production, limitez la priorité d'E/S du resilvering via 'zfs set zfs:zfs_resilver_min_time_ms=2000' et augmentez la mémoire allouée à l'ARC hôte pour empêcher l'éviction prématurée du cache de métadonnées.

Foire aux questions (FAQ)

Comment calculer la capacité utile d'un RAID selon les différents niveaux de grappe ?▼

La capacité RAID utile dépend de la topologie de la grappe et du surcoût imposé par les disques de parité : le RAID 0 offre N * Capacité_Disque (0 % de perte de parité) ; le RAID 1 offre 1 * Capacité_Disque (50 % de perte miroir sur 2 disques) ; le RAID 5 offre (N - 1) * Capacité_Disque ; le RAID 6 offre (N - 2) * Capacité_Disque ; et le RAID 10 offre (N / 2) * Capacité_Disque. Pour les pools ZFS RAIDZ, déduisez une réserve supplémentaire de 3,125 % (1/32e) pour le slop space et convertissez les téraoctets décimaux en tébioctets binaires à l'aide du facteur 0,9095 (1 Tio = 10^12 / 2^40 To).

Pourquoi la capacité formatée d'un RAID est-elle inférieure à celle annoncée par le fabricant ?▼

Les fabricants de disques durs commercialisent leurs disques selon le système décimal où 1 téraoctet (To) = 10^12 octets, tandis que les systèmes d'exploitation adressent le stockage en tébioctets binaires (Tio) où 1 Tio = 2^40 = 1 099 511 627 776 octets. Cet écart mathématique engendre d'emblée une réduction apparente de 9,0949 % (par exemple, un disque de 18 To n'offre qu'environ ~16,37 Tio d'espace brut). Les métadonnées de table de partitions (GPT EFI), les structures du système de fichiers (tables d'inodes, journaux) et la réservation de slop space de ZFS réduisent encore davantage la capacité utile finale.

Pourquoi le RAID 5 est-il dangereux avec des disques durs haute capacité de 16 To ou 18 To ?▼

Le RAID 5 ne tolère la panne que d'un seul disque et exige la lecture intégrale de tous les disques survivants pour recalculer la parité lors d'une reconstruction. Or, les disques SATA grand public standard présentent un taux d'erreur de lecture irrécupérable (URE) de 10^-14 (1 bit erroné pour 12,5 To lus). Reconstruire une grappe de 4 disques de 16 To requiert la lecture continue de 48 To de données, ce qui engendre une probabilité statistique d'échec supérieure à 98 % selon le modèle de Poisson P = 1 - exp(-Bits * BER), provoquant la destruction totale de la grappe au premier secteur illisible rencontré.

Quelle est la différence entre le RAID 10 et le RAID 6 pour le stockage de bases de données ?▼

Le RAID 10 applique un striping sur des paires en miroir avec un facteur de pénalité d'écriture de 2, alors que le RAID 6 calcule une double parité P+Q Reed-Solomon avec un facteur de pénalité d'écriture de 6. Pour les bases de données transactionnelles à haut débit (MySQL, PostgreSQL, Oracle) soumises à de lourdes écritures aléatoires, le RAID 10 fournit 300 % d'IOPS d'écriture aléatoire en plus et reconstruit un disque dégradé par simple copie miroir sans exiger de recalculs de parité intensifs. Le RAID 6 est en revanche optimisé pour les débits élevés en lecture séquentielle, les dépôts de sauvegarde et l'archivage de masse économique.

En quoi ZFS RAIDZ2 se distingue-t-il d'un RAID 6 matériel traditionnel ?▼

ZFS RAIDZ2 remplace les tailles de bandes fixes et les contrôleurs matériels à batterie de secours (BBU) par des largeurs de bande dynamiques et des sommes de contrôle cryptographiques 128 bits Fletcher4/SHA-256, éradiquant définitivement le problème critique du « write hole » propre aux RAID 5/6. Lors de la reconstruction (resilvering), ZFS ne lit et ne recalcule que les métadonnées réelles et les blocs de données actifs au lieu de balayer l'ensemble des secteurs vides non alloués, tout en détectant et corrigeant automatiquement la corruption silencieuse des données (bit rot) lors des opérations régulières de scrub.

Qu'est-ce que la règle des 80 % sous ZFS et quel est le rôle du slop space ?▼

La règle des 80 % de ZFS préconise de ne jamais dépasser 80 % d'utilisation sur un pool de stockage afin d'éviter le passage de l'allocateur first-fit en O(1) à une recherche best-fit à forte latence, responsable d'une fragmentation sévère et d'un effondrement des IOPS. En parallèle, OpenZFS impose par défaut une réserve d'espace tampon (slop space) de 3,125 % (1/32e de la capacité brute du pool, avec un minimum de 128 Mio) contrôlée par 'spa_slop_shift=5', assurant que les opérations d'administration telles que la suppression de snapshots, la destruction de jeux de données et l'écriture de métadonnées s'exécutent avec succès même lorsqu'un pool atteint 100 % du quota utilisateur.

Combien de temps prend la reconstruction d'un RAID sur des disques durs de 16 To ou 20 To ?▼

La durée de reconstruction dépend de la capacité brute des disques, de la bande passante d'écriture séquentielle soutenue, du débit du fond de panier du contrôleur et de la charge d'E/S applicative concurrente. En l'absence totale de charge en arrière-plan, un disque d'entreprise de 18 To à 7 200 tr/min maintenant 200 Mo/s met environ 25 à 30 heures à se reconstruire. Sous une charge transactionnelle de production de 50 % ou en présence de disques SMR (Shingled Magnetic Recording), ce délai passe de 5 à 9 jours, ce qui élargit considérablement la fenêtre de vulnérabilité aux pannes matérielles secondaires.

Outils et utilitaires connexes

Tous les outils →