Testeur Regex & Débogueur

Testeur Regex & DébogueurVersion

Testez, déboguez et optimisez vos expressions régulières en temps réel. Analysez les correspondances de motifs, les groupes de capture, l'arbre syntaxique et les substitutions.

Variante du moteur
Fins de ligne
Préréglages rapides
Atelier de test et débogage Regex
//gm
Palette d'insertion rapide
Reach out to [email protected]#1 or [email protected]#2 for inquiries. Invalid addresses like john..doe@bad#3_domain or @missing-user.org should be ignored. Admin contact: [email protected]#4.
Détails des correspondancesTotal des correspondances: 4
Correspondance #1: "[email protected]"Position :: [13:32] (19 caractères)
<user>: "support"<domain>: "toolsaa.com"
Correspondance #2: "[email protected]"Position :: [36:66] (30 caractères)
<user>: "sales.dept"<domain>: "enterprise-cloud.io"
Correspondance #3: "john..doe@bad"Position :: [105:118] (13 caractères)
<user>: "john..doe"<domain>: "bad"
Correspondance #4: "[email protected]"Position :: [181:212] (31 caractères)
<user>: "sec-ops"<domain>: "datacenter.internal.net"
Correspondances
4
Groupes de capture
2 groupes
Statut de vulnérabilité ReDoS
Sécurisé

Traitement 100 % côté client

Calcul haute performance exécuté intégralement dans la mémoire de votre navigateur.

Zéro transmission serveur

Toutes les données restent strictement locales, sans aucune communication externe.

Prêt pour la production

Formats de sortie optimisés et directement intégrables dans vos projets.
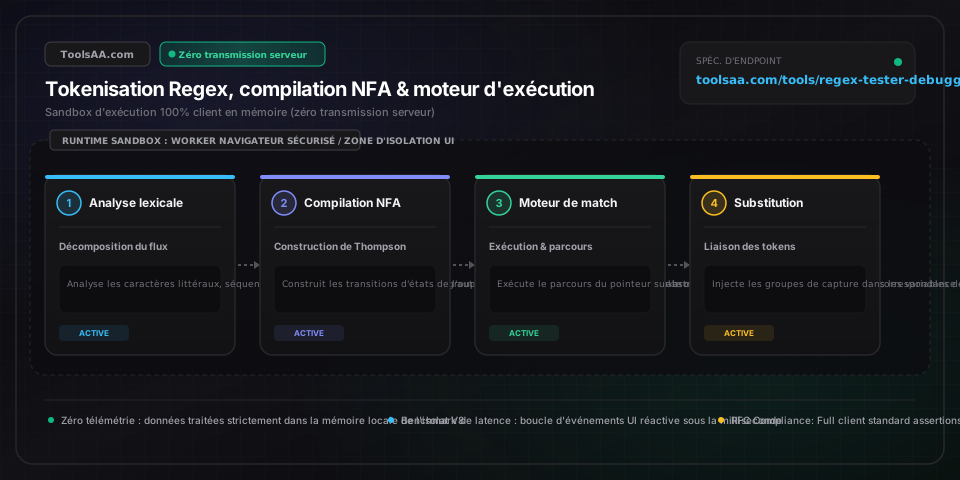
Référence technique et guide d'architecture

Testeur Regex & Expressions Régulières — Guide de référence

Testez, déboguez et optimisez vos expressions régulières en temps réel. Analysez correspondances, groupes de capture, explications syntaxiques et remplacements.

Testeur Regex & Expressions Régulières — Guide de référence — Architecture en mémoire côté client et flux de données

Paramètres clés et contrôles

Motif d'expression régulière (Pattern)Syntaxe littérale RegExp

Expression régulière littérale standard contenant classes de caractères, ancres, quantificateurs et groupes de capture conformes aux spécifications ECMAScript RegExp.

Par défaut : /(?<user>[a-zA-Z0-9._%+-]+)@(?<domain>[a-zA-Z0-9.-]+\.[a-zA-Z]{2,})/gm
Drapeaux d'exécution (Flags)Masque de drapeaux (Bitmask)

Modificateurs de compilation altérant le comportement à l'exécution : g (recherche globale), i (insensible à la casse), m (ancres multilignes ^ et $), s (mode dotAll où le point inclut les sauts de ligne), u (support Unicode des points de code), y (recherche adhérente sticky sur lastIndex).

Par défaut : gm
Corpus textuel cible de testTexte brut d'évaluation

Document d'entrée multiligne sur lequel l'expression régulière est exécutée pour identifier les correspondances, évaluer les groupes de capture et tester les performances.

Par défaut : sample text corpus
Gabarit de substitutionChaîne de remplacement

Modèle de chaîne pour le remplacement prenant en charge les rétro-références positionnelles ($1, $2), les identifiants de groupes nommés ($<nom>), le match complet ($&) et les segments adjacents ($`, $').

Par défaut : $<user> at $<domain>

Conseils de pro et bonnes pratiques

Éviter le retour sur trace catastrophique (ReDoS) par disjonction stricte

Les quantificateurs imbriqués non bornés tels que (a+)+ ou (.*a)+ forcent les moteurs NFA à explorer O(2^n) états lors d'une non-concordance. Éliminez les chevauchements de classes au sein des répétitions et privilégiez les groupes atomiques, les quantificateurs possessifs ou les classes négatives strictes comme [^a]*a.

Attention à la persistance de lastIndex avec les drapeaux global (g) et sticky (y)

Lorsqu'une instance RegExp utilise le drapeau /g ou /y, le moteur JavaScript conserve un pointeur interne lastIndex qui s'incrémente après chaque correspondance. L'exécution répétée de regex.test() sur une même chaîne alternera entre true et false, sauf réinitialisation explicite de regex.lastIndex = 0.

Activer le drapeau Unicode (u ou v) pour les caractères astraux et les émojis

Sans le drapeau /u, le moteur regex traite les paires de substitution UTF-16 de 4 octets comme deux unités de code distinctes de 2 octets. Le point (.) échouera à faire correspondre un émoji comme 🚀 (\uD83D\uDE80) en tant que caractère unique, et les plages [\u{1F600}-\u{1F64F}] lèveront une erreur de syntaxe.

Distinguer le drapeau multiligne (m) du drapeau dotAll (s)

Le drapeau /m redéfinit uniquement les ancres ^ et $ pour cibler le début et la fin de chaque ligne d'une chaîne multiligne, et non l'ensemble du document. Il ne permet PAS au point (.) d'inclure les sauts de ligne (\n ou \r) ; pour traverser les sauts de ligne, vous devez activer explicitement le drapeau /s (dotAll).

Pièges courants et dépannage

⚠️Capture gloutonne accidentelle englobant plusieurs balises XML ou HTML

Les quantificateurs par défaut (*, +, {n,}) sont gloutons et consomment le maximum de texte. Pour vous arrêter au délimiteur le plus proche, ajoutez un point d'interrogation pour activer le mode paresseux (par exemple changez <div.*> en <div.*?>) ou utilisez une classe de caractères négative comme <[^>]*>.

⚠️Barres obliques non échappées ou métacaractères provoquant une erreur de syntaxe

Les caractères dotés d'un rôle syntaxique (\, ^, $, ., |, ?, *, +, (, ), [, ], {, }) doivent être précédés d'une barre oblique inverse pour une correspondance littérale. Lors de la construction dynamique d'un motif avec new RegExp(), veillez à doubler les barres d'échappement (\\) dans le code source.

⚠️Confusion entre assertion négative avant (?!motif) et classe négative [^caractères]

Une classe de caractères négative [^abc] consomme exactement un caractère qui n'est ni 'a', ni 'b', ni 'c'. Une assertion négative avant (lookahead négatif) (?!abc) est une assertion de largeur nulle vérifiant que la suite ne commence pas par 'abc', sans consommer le moindre caractère.

Foire aux questions (FAQ)

Comment tester une regex sans risque de vulnérabilité ReDoS ?▼

Le retour sur trace catastrophique survient lorsqu'un moteur NFA rencontre des quantificateurs imbriqués avec des sous-motifs qui se chevauchent (tels que (a+)+$ ou (x|y+)*) sur une chaîne non concordante, provoquant une explosion combinatoire en O(2^n). Pour l'éviter, veillez à ce que les groupes répétés soient mutuellement exclusifs, remplacez les jokers gloutons .* par des classes négatives précises comme [^\n,]+, et mesurez la latence d'exécution sur des cas d'échec.

Quelle est la différence entre quantificateurs gloutons, paresseux et possessifs ?▼

Les quantificateurs gloutons (*, +, {min,max}) capturent le plus de texte possible et reviennent en arrière caractère par caractère si le reste du motif échoue. Les quantificateurs paresseux (*?, +?, {min,max}?) capturent le minimum de caractères et s'étendent progressivement. Les quantificateurs possessifs (*+, ++, {min,max}+), supportés par PCRE et Java, consomment avidement tout le texte éligible sans jamais effectuer de retour sur trace, échouant immédiatement en cas de discordance.

Pourquoi regex.test() renvoie-t-il true puis false sur la même chaîne ?▼

Lorsqu'une expression régulière JavaScript est compilée avec le drapeau /g (global) ou /y (sticky), l'objet RegExp devient avec état en mettant à jour son pointeur interne lastIndex avec la position suivant la dernière correspondance. Lors de l'appel suivant, la recherche débute à lastIndex ; parvenu à la fin de la chaîne, lastIndex est réinitialisé à 0 et la méthode retourne false. Réinitialisez toujours regex.lastIndex = 0 avant d'exécuter un test.

Comment faire correspondre un motif à travers plusieurs lignes avec sauts de ligne ?▼

Pour traverser les retours à la ligne, activez le drapeau dotAll (/s), qui configure le métacaractère point (.) pour cibler également les sauts de ligne (\n, \r) en ECMAScript 2018+, Python et dans les moteurs récents. Dans les environnements ne gérant pas /s, utilisez l'ensemble complémentaire [\s\S] ou [\d\D], qui englobe tout caractère blanc ou non blanc et franchit ainsi sans encombre les sauts de ligne.

Quelle est la différence entre groupes capturants et non capturants ?▼

Les groupes capturants définis par (motif) conservent en mémoire la sous-chaîne correspondante, lui assignent un indice de rétro-référence ($1, $2, ...) et la rendent accessible dans les résultats de correspondance. Les groupes non capturants définis par (?:motif) permettent d'appliquer des quantificateurs ou des alternances sans allouer de mémoire supplémentaire ni surcharger les tableaux de capture, ce qui optimise les performances de traitement.

Outils et utilitaires connexes

Tous les outils →