Regex Tester & Regex-Debugger

Regex Tester & Regex-DebuggerEngine-Version

Reguläre Ausdrücke in Echtzeit testen, debuggen und optimieren. Treffer, Erfassungsgruppen, Token-Erklärungen und Ersetzungsmuster direkt im Browser prüfen.

Regex-Engine-Variante
Zeilenenden (LF / CRLF)
Schnell-Presets
Regex-Entwicklungsumgebung
//gm
Schnellauswahl & Syntax-Palette
Reach out to [email protected]#1 or [email protected]#2 for inquiries. Invalid addresses like john..doe@bad#3_domain or @missing-user.org should be ignored. Admin contact: [email protected]#4.
Trefferdetails & GruppenGesamttreffer: 4
Treffer #1: "[email protected]"Position: [13:32] (19 Zeichen)
<user>: "support"<domain>: "toolsaa.com"
Treffer #2: "[email protected]"Position: [36:66] (30 Zeichen)
<user>: "sales.dept"<domain>: "enterprise-cloud.io"
Treffer #3: "john..doe@bad"Position: [105:118] (13 Zeichen)
<user>: "john..doe"<domain>: "bad"
Treffer #4: "[email protected]"Position: [181:212] (31 Zeichen)
<user>: "sec-ops"<domain>: "datacenter.internal.net"
Gefundene Treffer
4
Erfassungsgruppen
2 Gruppen
ReDoS-Sicherheitsstatus
Geschützt

Clientseitige Ausführung

Hochleistungsfähige Regex-Auswertung vollständig im lokalen Arbeitsspeicher des Browsers.

Vollständige Privatsphäre ohne Server-Upload

Sämtliche Muster und Testdaten verbleiben strikt auf Ihrem Endgerät ohne externe Datenübertragung.

Produktionsreife Integration

Präzise Code-Snippets und bereinigte Ausdrücke für den sofortigen Produktionseinsatz.
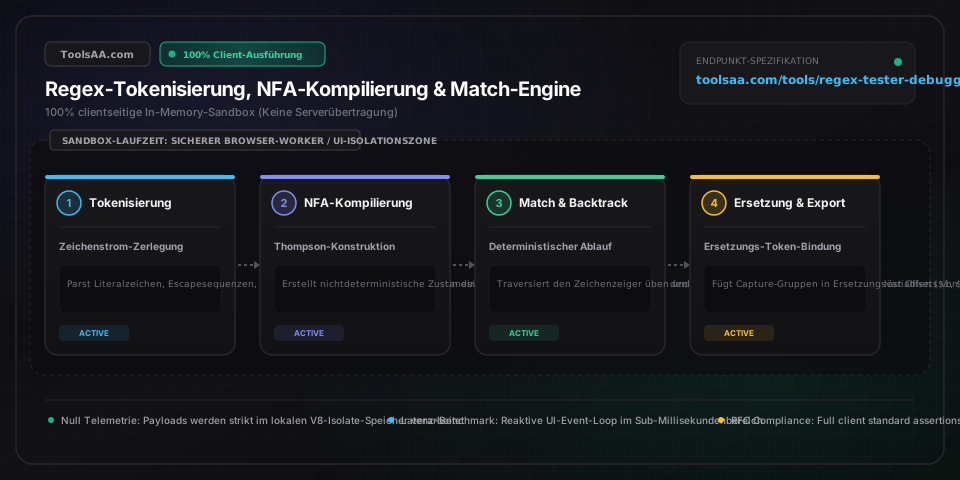
Technische Referenz & Architektur-Leitfaden

Regex Tester & Debugger — Referenzhandbuch

Reguläre Ausdrücke in Echtzeit testen, debuggen und optimieren. Visualisieren Sie Treffer, Erfassungsgruppen, Token-Erklärungen und Ersetzungsmuster.

Regex Tester & Debugger — Referenzhandbuch — Client-seitige In-Memory-Architektur und Datenfluss

Wichtige Parameter & Einstellungen

Regulärer Ausdruck (Pattern)RegExp-Syntax-String

Standardmäßiges Regex-Literal mit Zeichenklassen, Ankern, Quantifizierern und Erfassungsgruppen gemäß der ECMAScript-RegExp-Spezifikation.

Standard: /(?<user>[a-zA-Z0-9._%+-]+)@(?<domain>[a-zA-Z0-9.-]+\.[a-zA-Z]{2,})/gm
Regex-Ausführungs-FlagsFlag-Modifikatoren-String

Kompilierungsmodifikatoren zur Steuerung des Laufzeitverhaltens: g (globale Suche), i (Groß-/Kleinschreibung ignorieren), m (Mehrzeilen-Modus für ^ und $), s (DotAll-Modus: Punkt erfasst Zeilenumbrüche), u (Unicode-Code-Point-Unterstützung), y (Sticky-Matching ab lastIndex).

Standard: gm
Testkorpus (Zieltext)Testdaten-Rohtext

Mehrzeiliges Eingabedokument, auf das der reguläre Ausdruck angewendet wird, um Übereinstimmungen zu finden, Gruppen auszuwerten und die Ausführungszeit zu analysieren.

Standard: sample text corpus
Ersetzungsvorlage (Substitutionsmuster)Ersetzungs-String

Muster für die Zeichenkettenersetzung mit Unterstützung für positionelle Rückwärtsreferenzen ($1, $2), benannte Erfassungsgruppen ($<name>), den Gesamttreffer ($&) sowie Präfix- und Suffix-Abschnitte ($`, $').

Standard: $<user> an $<domain>

Profi-Tipps & Best Practices

Katastrophales Backtracking (ReDoS) durch disjunkte Token verhindern

Verschachtelte unbegrenzte Quantifizierer wie (a+)+ oder (.*a)+ zwingen NFA-Engines (nichtdeterministische endliche Automaten) bei fehlschlagenden Eingaben in eine O(2^n)-Zustandsexplosion. Beseitigen Sie überlappende Zeichenklassen innerhalb von Wiederholungen und nutzen Sie atomare Gruppierungen, possessive Quantifizierer oder strikt negierte Zeichensätze wie [^a]*a.

Zustandsbehaftete lastIndex-Eigenschaft bei Flags g und y beachten

Ist bei einer RegExp-Instanz das Flag /g oder /y gesetzt, speichert die JavaScript-Engine den internen Zeiger lastIndex, der nach jedem Treffer weiterrückt. Wiederholte Aufrufe von regex.test() auf denselben String alternieren zwischen true und false, sofern lastIndex nicht explizit vor der Ausführung mit regex.lastIndex = 0 zurückgesetzt wird.

Unicode-Flag (u oder v) für Multibyte-Astral-Ebenen und Emojis erzwingen

Ohne das Flag /u behandelt Standard-JavaScript 4-Byte-UTF-16-Surrogat-Paare als zwei separate 2-Byte-Code-Units. Ein Punkt (.) matcht ein Emoji wie 🚀 (\uD83D\uDE80) nicht als einzelnes Zeichen, solange /u oder /v inaktiv ist, und Zeichenbereichsklassen wie [\u{1F600}-\u{1F64F}] werfen Syntaxfehler.

Multiline-Flag (m) und DotAll-Flag (s) bei Zeilenumbrüchen differenzieren

Das Flag /m definiert lediglich die Anker ^ und $ so um, dass sie auf den Anfang und das Ende jeder Zeile innerhalb eines mehrzeiligen Strings matchen statt nur auf das Gesamtdokument. Es erlaubt dem Punkt (.) keineswegs, Zeilenvorschübe (\n) oder Wagenrückläufe (\r) zu erfassen; für zeilenübergreifende Punkt-Treffer muss explizit das Flag /s (dotAll) aktiviert werden.

Häufige Fehlerquellen & Fehlerbehebung

⚠️Ungewollt gierige Quantifizierer verschlingen mehrere HTML- oder XML-Tags

Standard-Quantifizierer (*, +, {n,}) agieren standardmäßig gierig (greedy) und konsumieren maximalen Text. Fügen Sie ein Fragezeichen an, um einen trägen (lazy) Quantifizierer zu erzwingen (z. B. <div.*?> statt <div.*>), oder verwenden Sie eine negierte Zeichenklasse (z. B. <[^>]*>).

⚠️Nicht-maskierte Schrägstriche oder reservierte Metazeichen verursachen Syntaxfehler

Zeichen mit syntaktischer Sonderfunktion (\, ^, $, ., |, ?, *, +, (, ), [, ], {, }) müssen mit einem vorangestellten Backslash maskiert werden, wenn sie literale Zeichen matchen sollen. Beim dynamischen Instanziieren via new RegExp() im Quellcode ist zudem eine doppelte Maskierung (\\) erforderlich.

⚠️Negativer Lookahead (?!Muster) wird mit negierter Zeichenklasse [^Zeichen] verwechselt

Eine negierte Zeichenklasse [^abc] konsumiert exakt ein Zeichen, das weder 'a', 'b' noch 'c' ist. Eine negative Lookahead-Assertion (?!abc) ist hingegen eine Assertion ohne Zeichenbreite (Zero-Width), die prüft, ob die nachfolgende Zeichenfolge nicht 'abc' lautet, ohne dabei Zeichen im Eingabetext zu verbrauchen.

Häufig gestellte Fragen (FAQ)

Wie testet man reguläre Ausdrücke auf ReDoS-Schwachstellen durch katastrophales Backtracking?▼

Katastrophales Backtracking tritt auf, wenn eine NFA-Regex-Engine auf verschachtelte Quantifizierer mit überlappenden Teilmustern (wie (a+)+$ oder (x|y+)*) bei nicht übereinstimmenden Strings trifft, was zu exponentieller Komplexität von O(2^n) führt. Zur Absicherung müssen wiederholte Gruppen disjunkt sein. Ersetzen Sie gierige Platzhalter wie .* durch strikt negierte Klassen wie [^\n,]+ und analysieren Sie die Ausführungszeit gezielt mit fehlschlagenden Grenzwert-Eingaben.

Was ist der Unterschied zwischen gierigen, trägen und possessiven Quantifizierern?▼

Gierige Quantifizierer (*, +, {min,max}) konsumieren so viele Zeichen wie möglich und führen schrittweises Backtracking durch, falls das Gesamtmuster fehlschlägt. Träge bzw. faule Quantifizierer (*?, +?, {min,max}?) konsumieren so wenig wie möglich und expandieren Zeichen für Zeichen nur bei Bedarf. Possessive Quantifizierer (*+, ++, {min,max}+), unter anderem in Java und PCRE unterstützt, konsumieren gierig, führen niemals Backtracking durch und schlagen sofort fehl, wenn nachfolgende Token nicht matchen.

Warum liefert regex.test() bei identischen Zeichenketten abwechselnd true und false?▼

Wird ein regulärer Ausdruck in JavaScript mit dem globalen Flag (/g) oder sticky Flag (/y) kompiliert, speichert das RegExp-Objekt einen Zustand: Die Eigenschaft lastIndex wird auf die Zeichenposition direkt hinter dem letzten Treffer gesetzt. Ein erneuter Aufruf sucht ab lastIndex statt ab Position 0; erreicht die Suche das String-Ende, wird lastIndex auf 0 zurückgesetzt und false geliefert. Setzen Sie regex.lastIndex = 0 vor wiederholten Prüfungen manuell zurück.

Wie matcht man mit regulären Ausdrücken über mehrere Zeilen inklusive Zeilenumbrüche?▼

Um Zeilenumbrüche einzuschließen, aktivieren Sie das DotAll-Flag (/s). Dadurch erfasst der Punkt (.) auch Zeilenvorschübe (\n) und Wagenrückläufe (\r) in ECMAScript 2018+, Python und modernen Engines. In Laufzeitumgebungen ohne /s-Unterstützung verwendet man komplementäre Zeichensätze wie [\s\S] oder [\d\D], die jedes beliebige Zeichen inklusive Zeilenumbrüchen abdecken.

Worin besteht der Unterschied zwischen erfassenden und nicht-erfassenden Gruppen?▼

Erfassende Gruppen (Capturing Groups) in der Form (Muster) speichern die gefundene Teilzeichenkette im Speicher, weisen ihr einen numerischen Rückreferenz-Index zu ($1, $2, ...) und stellen sie im Ergebnis-Array bereit. Nicht-erfassende Gruppen (Non-Capturing Groups) mit (?:Muster) gruppieren Teilausdrücke oder Alternativen ohne Speicherzuweisung, wodurch sie den Verarbeitungsaufwand und Speicherverbrauch reduzieren.

Verwandte Tools & Hilfsprogramme

Alle Tools →