Robots.txt Tester

Robots.txt Tester & Syntax-Validator

Testen und validieren Sie robots.txt-Dateien nach RFC 9309. Prüfen Sie User-Agent-Crawl-Rechte, debuggen Sie Disallow-Pfade und analysieren Sie Sitemaps direkt im Browser.

Beispieldaten laden
Crawl-Entscheidungs-EngineRFC 9309 konforme Pfad- und Spezifitätsauflösung in Echtzeit
1. Eingabe & URL-NormalisierungHTTP 2002. Percent-Encoding Pfad-Dekodierung29 Bytes3. User-Agent-Gruppenzuordnung (1)Zeile 14. Spezifitätsauflösung & Entscheid2 Lbl candidatesCRAWL ERLAUBT (ALLOWED)
Robots.txt Quelltext-Editor
12 Zeilen•272 B•1 UA-Gruppen
Gültige RFC-Syntax
CRAWL ERLAUBT (ALLOWED)

Dem Crawler ist der Zugriff und die Indexierung dieser URI gestattet.

Googlebot
Ausschlaggebende DirektiveRfc spec section
ZeileZeile 8
DirektiventypAllow: /catalog/
Musterlänge (Spezifität)9 Bytes
Ziel-User-Agent stimmt exakt mit Gruppen-Header überein.Keine spezifische Gruppe vorhanden; Fallback auf Wildcard-Gruppe (User-agent: *).
EntscheidungsbegründungAllow hat bei identischer Musterlänge normgemäß Vorrang vor Disallow.
RFC-Auswertungsprotokoll & Entscheidungsverlauf
[1]Normalized URI Path: /catalog/shoes?sort=price_asc
[2]Target User-Agent: Googlebot
[3]HTTP Response Simulation: 200
[4]No exact bot match; fallback to wildcard group (User-agent: *) at line 1
[5]Line 6: [Disallow: /*?*sort=] MATCH (Length: 9, Regex: ^/.*\?.*sort=)
[6]Line 8: [Allow: /catalog/] MATCH (Length: 9, Regex: ^/catalog/)
[7]Line 8: Equal length tie resolved: Allow takes precedence.
[8]Final Verdict: ALLOWED by winning rule on line 8
Normalisierter Zielpfad:/catalog/shoes?sort=price_asc
Compliance-Modus (Regime)Googlebot Production Standard
Zeilen gesamt12
UA-Gruppen1
Sitemaps2
Dateigröße272 B
RFC-Status100 % RFC-konform
Crawl-UrteilCRAWL ERLAUBT (ALLOWED)
Technische Referenz & Architektur-Leitfaden

Robots.txt Tester & Syntax-Prüfer — Referenzhandbuch

Robots.txt-Syntax nach RFC 9309 testen und validieren. User-Agent-Crawl-Berechtigungen prüfen, Disallow-Pfade analysieren und Sitemaps direkt im Browser verifizieren.

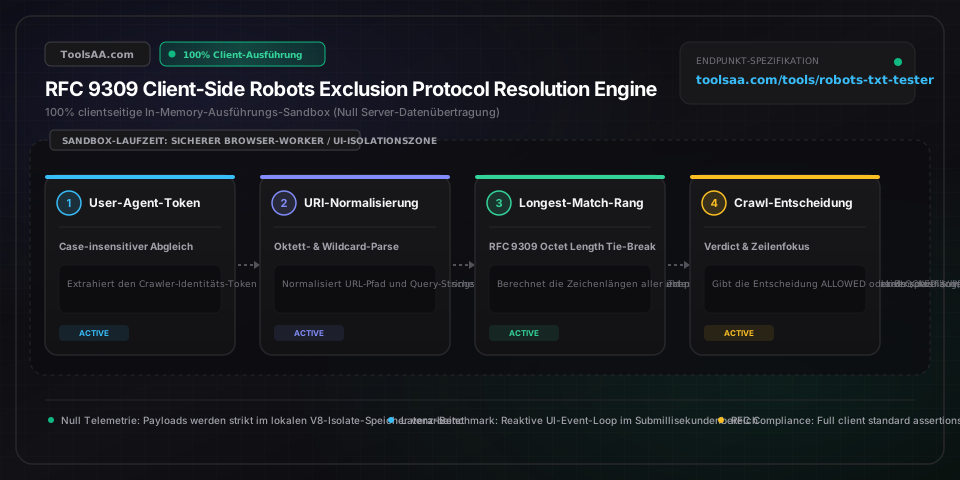
Robots.txt Tester & Syntax-Prüfer — Referenzhandbuch — Client-seitige In-Memory-Architektur und Datenfluss

Wichtige Parameter & Einstellungen

User-agent-DirektiveCrawler-Identifikationsmuster

Bestimmt das spezifische Crawler-Token oder Wildcard-Muster für nachfolgende Regelblöcke. Groß-/Kleinschreibung wird ignoriert; RFC 9309 legt fest, dass exakt übereinstimmende Crawler-Token strikten Vorrang vor partiellen Präfix-Matches und universellen Wildcard-Gruppen (*) haben.

Standard: *
Disallow-PfadmusterURI-Pfad-Präfixmuster

Definiert URI-Pfadpräfixe, auf die der angegebene Crawler nicht zugreifen darf. Ein leerer Disallow-Wert (Disallow:) signalisiert, dass das Crawling für alle Pfade der Website zulässig ist.

Standard: /private/
Allow-Direktiven-SpezifitätURI-Pfad-Ausnahmemuster

Definiert URI-Pfadpräfixe, auf die Crawler zugreifen dürfen – typischerweise genutzt, um Ausnahmen innerhalb übergeordneter Disallow-Pfade freizugeben. Bei identischer Pfadlänge hat Allow nach RFC 9309 stets Vorrang vor Disallow.

Standard: /private/public-asset.js
Wildcard-Sternchen-Muster (*)Mustervergleichs-Token

Entspricht einer beliebigen Folge von null oder mehr gültigen URI-Zeichen innerhalb von Pfad-Strings; wird häufig zum Blockieren dynamischer URL-Parameter (z. B. /*?*sort=) oder spezifischer Dateiendungen (z. B. /*.pdf$) eingesetzt.

Standard: /*?*sort=
URI-Ende-Anker ($)Grenzanker-Token

Verankert das Vergleichsmuster explizit am exakten Ende des URL-Pfads oder Query-Strings, um ein versehentliches Präfix-Matching tiefer verschachtelter Unterpfade zu verhindern.

Standard: /exact-page$
Crawl-delay-DirektiveRate-Limiting-Direktive (Nicht standardisiert)

Gibt das Warteintervall in Sekunden zwischen aufeinanderfolgenden Crawler-Anfragen an. Wird von Bingbot, Yandex und Baidu berücksichtigt, von Googlebot jedoch strikt ignoriert (Googlebot nutzt stattdessen die Crawling-Einstellungen in der Google Search Console).

Standard: 10
Sitemap-DeklarationMetadaten-Lokalisierungsdirektive

Deklariert die absolute HTTPS-URL der XML-Sitemap oder Sitemap-Indexdatei der Website. Kann an beliebiger Stelle in der robots.txt platziert werden; Best Practice ist die Positionierung am Ende der Datei.

Standard: https://example.com/sitemap.xml
500-KiB-DateigrößengrenzeProtokoll-Grenzlimit

Offizielle Spezifikationsgrenze nach RFC 9309 Abschnitt 2.1 für robots.txt-Dateien. Führende Suchmaschinen (einschließlich Google und Bing) brechen das Parsing bei 500 Kibibyte (512.000 Oktetts) ab und ignorieren alle nachfolgenden Direktiven.

Standard: 500 KiB

Profi-Tipps & Best Practices

RFC 9309: Spezifitätsregel des längsten Treffers schlägt Zeilenreihenfolge

Anders als Firewalls oder Access-Control-Listen (ACLs), die Regeln von oben nach unten abarbeiten, schreibt das offizielle Robots Exclusion Protocol (RFC 9309) vor, dass die Direktive mit den meisten übereinstimmenden Zeichen stets gewinnt. Deklarieren Sie Allow: /folder/sub/ (12 Zeichen) nach Disallow: /folder/sub/restricted/ (25 Zeichen), greift für passende Unterpfade immer die längere Disallow-Regel – völlig unabhängig von ihrer Position in der Datei.

Die kritische WordPress-Falle mit admin-ajax.php beim JavaScript-Rendering

Das Blockieren von /wp-admin/ ohne explizite Freigabe via Allow: /wp-admin/admin-ajax.php hindert den Googlebot Web Rendering Service (WRS) daran, asynchrone AJAX-Requests im Frontend auszuführen. In der Folge rendert Googlebot fehlerhafte Layouts, stuft Seiten bei Mobile-Friendly-Tests herab und entwertet interaktive Komponenten.

Disallow in robots.txt verhindert KEINE Google-Indexierung der URL

Eine Disallow-Direktive weist Suchmaschinen an, den Inhalt einer Seite nicht abzurufen (Crawl), verhindert jedoch nicht, dass die reine URL im Google-Suchindex landet, wenn externe Backlinks darauf verweisen. Google indexiert die URL dann als nackten Link mit dem Snippet 'Für diese Seite sind keine Informationen verfügbar'. Um eine Indexierung zuverlässig zu verhindern, muss das Crawling erlaubt sein und die Seite mit <meta name="robots" content="noindex"> oder dem HTTP-Header X-Robots-Tag: noindex ausgeliefert werden.

Vollständige Einstellung der Noindex-Direktive in der robots.txt

Google hat die Unterstützung der inoffiziellen Noindex-Direktive in robots.txt am 1. September 2019 offiziell eingestellt. In der robots.txt verbleibende noindex-Regeln werden als Syntaxfehler gewertet oder ignoriert. Websites, die weiterhin auf diesen veralteten Workaround setzen, riskieren die ungewollte organische Indexierung interner Staging- und Administrationsbereiche.

Entkopplung der Websuche-Indexierung vom Training generativer KI

Um zu verhindern, dass eigene Inhalte für das Training von KI-Modellen abgegriffen werden, ohne dabei organische Google-Suchrankings zu gefährden, sperren Sie Google-Extended statt Googlebot. Google-Extended ist das separate Crawler-Token für Gemini, Vertex AI und AI Overviews, während Googlebot weiterhin die reguläre Websuche-Indexierung übernimmt.

UTF-8 Byte Order Mark (BOM) führt zu stillem Parser-Ausfall

Wird robots.txt als UTF-8 mit Byte Order Mark (BOM: \uFEFF) gespeichert, können strikte Parser das erste User-agent-Token in Zeile 1 nicht mehr auflösen, da das unsichtbare BOM den Zeichen vorangestellt ist. Dies entwertet die gesamte erste Crawler-Gruppe und Suchmaschinen behandeln die Direktiven wie verwaiste Kommentare.

Häufige Fehlerquellen & Fehlerbehebung

⚠️URL zeigt in Google Search Console die Warnung 'Indexiert, obwohl durch robots.txt blockiert'

Diese Warnung tritt auf, wenn eine URL in der robots.txt per Disallow gesperrt ist, Google die URL jedoch über interne Verlinkungen oder externe Backlinks entdeckt hat. Da Googlebot den HTML-Quelltext nicht abrufen darf, kann er darin platzierte noindex-Anweisungen nicht erfassen. Heben Sie die Disallow-Regel in der robots.txt auf, damit Googlebot die Seite crawlen kann, binden Sie ein <meta name="robots" content="noindex"> oder den Header X-Robots-Tag: noindex ein und warten Sie auf den nächsten Crawl zur De-Indexierung.

⚠️Explizite Allow-Regel wird ignoriert und URL bleibt gesperrt (Disallowed)

Gemäß RFC 9309 Abschnitt 2.2.2 entscheidet die Zeichenlängen-Spezifität und nicht die Reihenfolge in der Datei über die Priorität. Enthält Ihre Disallow-Regel mehr übereinstimmende Zeichen als die Allow-Regel (z. B. Disallow: /products/archived/ mit 20 Zeichen gegenüber Allow: /products/ mit 10 Zeichen), greift immer Disallow. Stellen Sie sicher, dass Ihre Allow-Direktive mindestens genauso viele oder mehr spezifische Zeichen abdeckt, etwa durch Pfadvertiefung oder Endanker ($).

⚠️Googlebot ignoriert Crawl-delay und überlastet CPU und Arbeitsspeicher des Webservers

Googlebot unterstützt die Crawl-delay-Direktive in der robots.txt prinzipiell nicht. Um die Abruffrequenz des Googlebots zu drosseln, passen Sie die Crawling-Geschwindigkeit in den Einstellungen der Google Search Console an oder konfigurieren Sie Ihren Webserver bzw. Reverse-Proxy (Nginx, Cloudflare) so, dass bei Überlastung die HTTP-Statuscodes 429 (Too Many Requests) oder 503 (Service Unavailable) mit dem Header Retry-After: 120 zurückgegeben werden.

⚠️Verzeichnis-Disallow sperrt versehentlich Dateien mit gleichem Namenspräfix

Die Direktive Disallow: /press ohne abschließenden Schrägstrich (Trailing Slash) matcht jede URL, die mit /press beginnt – darunter /press-releases/, /press.html oder /pressure-washing/. Um die Sperre exklusiv auf das Verzeichnis und dessen Unterordner zu beschränken, muss zwingend ein abschließender Slash gesetzt werden: Disallow: /press/.

⚠️KI-Scraper (CCBot, GPTBot) crawlen trotz Disallow unter User-agent: * weiter

Sobald ein Scraper ein eigenständiges Crawler-Token sendet (wie GPTBot oder CCBot), überschreibt ein für diesen Token deklarierter Block nach RFC 9309 die universelle Wildcard-Gruppe User-agent: *. Falls in Ihrer robots.txt ein separater, offener Block für diesen Bot existiert oder der Bot über unangekündigte Rotating Proxies operiert, greifen Wildcard-Regeln ins Leere. Definieren Sie explizite Blöcke für User-agent: GPTBot, User-agent: ClaudeBot und User-agent: CCBot mit Disallow: /.

Häufig gestellte Fragen (FAQ)

Wie löst die Spezifitätsregel nach RFC 9309 Konflikte zwischen Allow und Disallow auf?▼

Nach IETF RFC 9309 Abschnitt 2.2.2 berechnet der Parser bei kollidierenden Allow- und Disallow-Direktiven innerhalb derselben User-Agent-Gruppe die Länge der übereinstimmenden Pfadmuster in Oktetts. Das Muster mit der längsten Zeichenübereinstimmung gewinnt. Bei der URL /shop/sale/shoes überschreibt beispielsweise Disallow: /shop/sale/ (11 Zeichen) die Regel Allow: /shop/ (6 Zeichen). Weisen beide Pfadmuster exakt dieselbe Zeichenlänge auf, hat laut RFC 9309 die Allow-Direktive Vorrang.

Verhindert das Blockieren einer URL in der robots.txt deren Erscheinen in den Google-Suchergebnissen?▼

Nein. Ein Disallow in der robots.txt verbietet Webcrawlern lediglich das Herunterladen und Parsen des Seiteninhalts. Verweisen externe Websites oder interne Seiten auf die gesperrte URL, kann Google diese anhand der Ankertexte weiterhin im Index führen und als Snippet ohne Seitenbeschreibung anzeigen. Um eine Seite vollständig aus dem Google-Suchindex zu entfernen, muss das Crawling in der robots.txt erlaubt sein und die Seite mit einem noindex-Meta-Tag (<meta name="robots" content="noindex">) oder dem HTTP-Header X-Robots-Tag: noindex versehen werden.

Wie lassen sich KI-Scraper wie GPTBot und ClaudeBot blockieren, ohne das organische SEO zu gefährden?▼

Um KI-Scraper für das Modelltraining auszuschließen, ohne die Sichtbarkeit in der Websuche zu beeinträchtigen, fügen Sie dedizierte User-Agent-Blöcke für KI-Bots mit Disallow: / ein, während User-agent: Googlebot und User-agent: Bingbot weiterhin Zugriff erhalten. Gängige KI-Crawler-Token sind GPTBot, ChatGPT-User, ClaudeBot, AnthropicAI, CCBot, Google-Extended, PerplexityBot, Bytespider und Diffbot. Das gezielte Blockieren von Google-Extended unterbindet das KI-Training für Gemini und Vertex AI, lässt das reguläre Google-Websuch-Crawling jedoch intakt.

Worin liegt der Unterschied zwischen robots.txt Disallow und dem noindex-Meta-Tag?▼

Ein Disallow in der robots.txt ist eine Crawling-Steuerungsanweisung: Sie hindert Bots daran, die Seitendatei beim Server abzurufen, schont Server-Bandbreite sowie Crawl-Budget, schließt die URL jedoch nicht garantiert aus dem Suchindex aus. Das Tag <meta name="robots" content="noindex"> ist hingegen eine Indexierungsanweisung: Es weist Suchmaschinen an, die Seite aus den Suchergebnissen zu entfernen. Damit Google ein noindex-Tag verarbeiten kann, darf die Seite in der robots.txt nicht blockiert sein.

Warum ignoriert die Google-Suche die Crawl-delay-Direktive in der robots.txt?▼

Googlebot unterstützt Crawl-delay nicht, da Googles verteilte Crawling-Infrastruktur mit dynamischen, automatisierten Lastüberwachungsalgorithmen arbeitet. Diese passen die Abfragerate in Echtzeit an die Antwortlatenzen und Fehlerraten des Webservers an. Führt der Googlebot zu hoher Serverlast, steuern Sie die Frequenz über die Crawling-Einstellungen in der Google Search Console oder lassen Sie den Server bei Spitzenlast HTTP-Statuscodes wie 429 oder 503 mit entsprechendem Retry-After-Header ausliefern.

Welche maximale Dateigröße gilt für robots.txt, bevor Suchmaschinen das Parsing abbrechen?▼

Der offizielle IETF-Standard RFC 9309 definiert ein Größenlimit von maximal 500 Kibibyte (KiB), was exakt 512.000 Oktetts entspricht. Große Suchmaschinen wie Google und Bing schneiden robots.txt-Dateien ab, die 500 KiB überschreiten, verarbeiten ausschließlich die ersten 500 KiB und verwerfen alle weiteren Zeilen. Benötigt der Server zudem länger als 30 Sekunden für die Bereitstellung der robots.txt, werten Suchmaschinen dies als temporären 5xx-Serverfehler und stoppen das Crawling der gesamten Domain.

Verwandte Tools & Hilfsprogramme

Alle Tools →