O rastreador possui autorização para acessar e indexar esta URL.
Teste e valide a sintaxe do robots.txt conforme a RFC 9309. Verifique permissões de rastreamento por user-agent, depure caminhos de disallow e inspecione sitemaps no navegador com validação instantânea.
O rastreador possui autorização para acessar e indexar esta URL.
Teste e valide a sintaxe do robots.txt segundo a RFC 9309. Verifique permissões de user-agent, depure caminhos disallow e inspecione sitemaps no navegador.
Designa o token de rastreador (crawler) ou curingas visados pelos blocos de regras seguintes. Não diferencia maiúsculas de minúsculas; a RFC 9309 estipula que tokens exatos têm precedência estrita sobre prefixos parciais e curingas universais (*).
Especifica os prefixos de caminho de URI que o rastreador designado não pode acessar. Um valor Disallow vazio (Disallow:) indica que todos os caminhos do site estão liberados para rastreamento.
Especifica prefixos de caminho de URI que os rastreadores têm permissão para acessar, usados para abrir exceções dentro de um caminho Disallow amplo. Na RFC 9309, se Allow e Disallow tiverem o mesmo comprimento, Allow tem precedência.
Corresponde a qualquer sequência de zero ou mais caracteres válidos de URI em strings de caminho, usado com frequência para bloquear parâmetros de consulta dinâmicos (ex.: /*?*sort=) ou extensões de arquivo (ex.: /*.pdf$).
Fixa o padrão de correspondência ao final exato do caminho da URL ou query string, evitando o bloqueio acidental de subdiretórios ou caminhos aninhados mais longos por prefixo.
Define um intervalo de espera em segundos entre requisições consecutivas do rastreador. Respeitada por Bingbot, Yandex e Baidu, mas rigorosamente ignorada pelo Googlebot, que utiliza as configurações do Google Search Console.
Declara a URL HTTPS absoluta do sitemap XML ou arquivo de índice de sitemaps. Pode constar em qualquer parte do robots.txt, embora a recomendação seja incluí-la ao final do documento.
Limite oficial definido na Seção 2.1 da RFC 9309 para arquivos robots.txt. Os principais motores de busca (como Google e Bing) interrompem a análise em 500 kibibytes (512.000 octetos), ignorando o conteúdo restante.
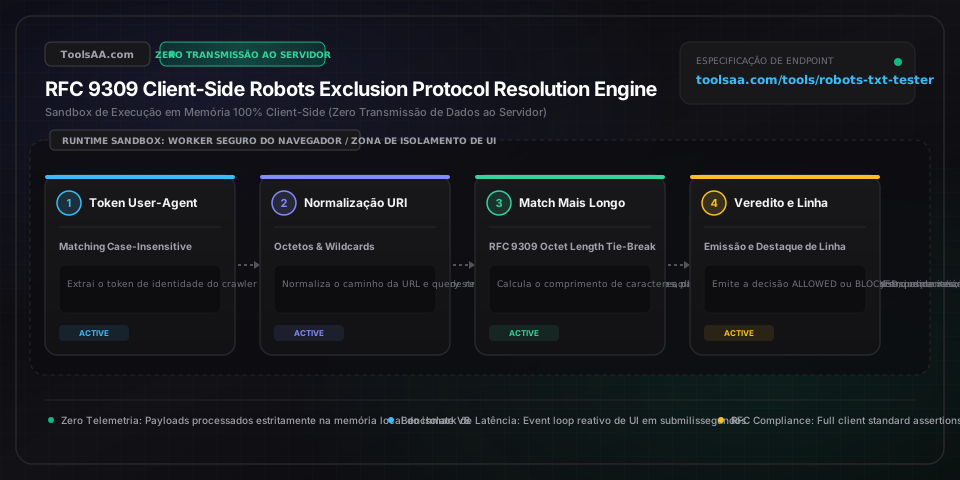
Ao contrário de firewalls ou listas de controle de acesso (ACL) que leem regras de cima para baixo, o padrão oficial Robots Exclusion Protocol (RFC 9309) determina que a diretiva com o maior número de caracteres correspondentes sempre prevalece. Se você declarar Allow: /folder/sub/ (12 caracteres) após Disallow: /folder/sub/restricted/ (25 caracteres), a regra Disallow mais longa vencerá para as URLs filhas correspondentes, independentemente da ordem em que aparecem no arquivo.
Bloquear /wp-admin/ sem declarar explicitamente Allow: /wp-admin/admin-ajax.php impede o Googlebot Web Rendering Service (WRS) de executar requisições assíncronas AJAX no frontend. Isso faz com que o Googlebot renderize layouts quebrados, seja reprovado nos testes de usabilidade móvel e desvalorize elementos interativos.
A diretiva Disallow informa aos motores de busca que eles não devem rastrear nem fazer download do conteúdo de uma página, mas NÃO impede que a URL apareça nos resultados do Google se houver links externos ou internos apontando para ela. O Google indexará a URL exibindo o aviso 'Nenhuma informação está disponível para esta página'. Para evitar a indexação com total eficácia, permita o rastreamento e adicione a tag <meta name="robots" content="noindex"> ou o cabeçalho HTTP X-Robots-Tag: noindex.
O Google encerrou oficialmente o suporte à diretiva não oficial Noindex dentro do robots.txt em 1º de setembro de 2019. Quaisquer regras noindex no arquivo são tratadas como sintaxe inválida ou completamente ignoradas. Sites que ainda usam essa prática correm o risco de ter URLs administrativas ou de ambientes de homologação (staging) indexadas organicamente.
Para evitar que seu conteúdo proprietário seja coletado por modelos de inteligência artificial sem prejudicar seu posicionamento orgânico no Google, bloqueie o Google-Extended em vez do Googlebot. O Google-Extended é o token exclusivo utilizado para treinar o Gemini, Vertex AI e os resumos de IA (AI Overviews), enquanto o Googlebot é dedicado à indexação web na busca tradicional.
Salvar o robots.txt em UTF-8 com Byte Order Mark (BOM: \uFEFF) impede que analisadores rigorosos identifiquem a primeira linha com User-agent, já que o marcador BOM precede o texto. Isso invalida o primeiro grupo de user-agent e faz com que os motores de busca tratem as regras iniciais como comentários órfãos.
Esse aviso surge quando uma página tem o rastreamento bloqueado por Disallow no robots.txt, mas o Google descobriu a URL por meio de links internos ou externos. Como o Googlebot não pode carregar o conteúdo da página, ele não visualiza a tag noindex. Para resolver, remova a regra Disallow no robots.txt para liberar o rastreamento, adicione a tag <meta name="robots" content="noindex"> ou o cabeçalho HTTP X-Robots-Tag: noindex e aguarde o Googlebot rastrear e desindexar a URL.
Segundo a Seção 2.2.2 da RFC 9309, a prioridade das diretivas é determinada pelo comprimento de caracteres correspondentes, e não pela ordem no arquivo. Se sua regra Disallow tiver mais caracteres coincidentes que a regra Allow (por exemplo, Disallow: /products/archived/ com 20 caracteres versus Allow: /products/ com 10 caracteres), a regra Disallow prevalece. Certifique-se de que a diretiva Allow tenha comprimento igual ou superior de caracteres, utilizando âncoras ($) ou caminhos mais específicos.
O Googlebot nunca ofereceu suporte nem interpreta a diretiva Crawl-delay no robots.txt. Para moderar a frequência de rastreamento do Googlebot, ajuste a taxa de rastreamento no Google Search Console ou configure o servidor web ou proxy reverso (Nginx, Cloudflare) para retornar status HTTP 429 (Too Many Requests) ou HTTP 503 (Service Unavailable) com o cabeçalho Retry-After: 120.
Declarar Disallow: /press sem barra no final abrange todas as URLs iniciadas por /press, incluindo /press-releases/, /press.html e /pressure-washing/. Para limitar o bloqueio exclusivamente ao diretório e seu conteúdo interno, inclua sempre a barra no fim: Disallow: /press/.
Quando um scraper declara um token de rastreador próprio (como GPTBot ou CCBot), a RFC 9309 exige que o bloco dedicado a esse token substitua integralmente o bloco universal User-agent: *. Se o seu robots.txt tiver um bloco para o GPTBot com permissões ou se o bot alternar endereços de proxy sem identificação, as regras genéricas são contornadas. Crie blocos específicos para User-agent: GPTBot, User-agent: ClaudeBot e User-agent: CCBot contendo Disallow: /.
Conforme a Seção 2.2.2 da IETF RFC 9309, se uma URL corresponder simultaneamente a diretivas Allow e Disallow no mesmo grupo de user-agent, o analisador calcula o comprimento de cada padrão em octetos (bytes). A diretiva com a maior sequência de caracteres correspondentes prevalece. Por exemplo, para a URL /shop/sale/shoes, Disallow: /shop/sale/ (11 caracteres) sobrepõe-se a Allow: /shop/ (6 caracteres). Se ambos os padrões tiverem exatamente o mesmo comprimento, a RFC 9309 estabelece que a diretiva Allow tem prioridade.
Não. Bloquear uma URL no robots.txt impede apenas que os robôs de busca baixem e analisem o conteúdo da página. Se houver backlinks externos ou links internos apontando para ela, o Google ainda poderá indexar a URL com base nos textos âncora, exibindo-a sem snippet descritivo. Para remover a URL completamente dos resultados, permita o rastreamento no robots.txt e adicione uma tag meta robots noindex ou o cabeçalho HTTP X-Robots-Tag: noindex.
Para bloquear rastreadores voltados ao treinamento de inteligência artificial mantendo a visibilidade na busca orgânica, configure grupos específicos de user-agent para os bots de IA com Disallow: /, enquanto mantém permissões ativas para User-agent: Googlebot e User-agent: Bingbot. Entre os principais tokens de IA estão GPTBot, ChatGPT-User, ClaudeBot, AnthropicAI, CCBot, Google-Extended, PerplexityBot, Bytespider e Diffbot. Bloquear o Google-Extended desativa o uso de dados para IA sem afetar a indexação padrão na Busca do Google.
O Disallow no robots.txt é uma diretiva de controle de rastreamento: ele impede que os bots façam requisições ao arquivo da página, poupando largura de banda e orçamento de rastreamento (crawl budget), mas não garante a desindexação. Já a tag meta name="robots" content="noindex" é uma diretiva de controle de indexação: ela ordena aos buscadores que retirem a página das páginas de resultados. Para que a instrução noindex seja obedecida, os motores de busca precisam ter permissão para rastrear a página no robots.txt.
O Googlebot não oferece suporte à diretiva Crawl-delay porque a infraestrutura de rastreamento do Google adota algoritmos automatizados de análise de carga em tempo real, recalculando o ritmo de requisições com base na latência e taxa de erros do servidor de hospedagem. Se o Googlebot estiver gerando sobrecarga, ajuste a taxa de rastreamento diretamente no Google Search Console ou configure o servidor para responder com códigos HTTP 429 ou 503 acompanhados do cabeçalho Retry-After.
A especificação RFC 9309 estipula o limite máximo de 500 kibibytes (KiB), correspondente a 512.000 octetos (bytes). Mecanismos de busca como Google e Bing interrompem a leitura de arquivos que ultrapassam 500 KiB e interpretam apenas os dados anteriores a essa marca, desconsiderando as regras restantes. Além disso, se o download do robots.txt demorar mais de 30 segundos para responder, os buscadores tratam o evento como erro 5xx temporário e podem paralisar todo o rastreamento do domínio.
Converta Markdown para HTML limpo e pronto para produção em tempo real. Com tabelas GFM, realce de sintaxe, proteção XSS, cópia Rich Text e exportação.
Interprete expressões cron em linguagem natural legível. Inspecione próximas execuções em múltiplos fusos horários, valide sintaxe crontab e projete agendamentos futuros.
Converta esquemas SDL e consultas GraphQL em tipos, interfaces, enums e resolvers TypeScript. Codegen instantâneo no navegador, sem configurações ou envio ao servidor.
Converta HTML para Markdown com tabelas GFM, blocos de código e suporte a capturas web. Remova estilos inline e exporte arquivos .md limpos.
Compare textos, códigos e arquivos com nosso verificador de diff ultrarrápido. Inspecione alterações lado a lado ou em linha, ignore espaços e exporte patches unificados.
Gere tags rel=canonical e cabeçalhos HTTP válidos. Remova parâmetros de rastreamento, normalize URLs e resolva problemas de conteúdo duplicado no SEO.