El rastreador tiene autorización para acceder e indexar este URI.
Pruebe y valide la sintaxis de robots.txt conforme a RFC 9309. Verifique permisos de rastreo por User-Agent, depure rutas Disallow e inspeccione sitemaps en el navegador.
El rastreador tiene autorización para acceder e indexar este URI.
Prueba y valida la sintaxis de robots.txt conforme a la RFC 9309. Comprueba permisos de rastreo por user-agent, depura rutas disallow e inspecciona sitemaps al instante en el navegador.
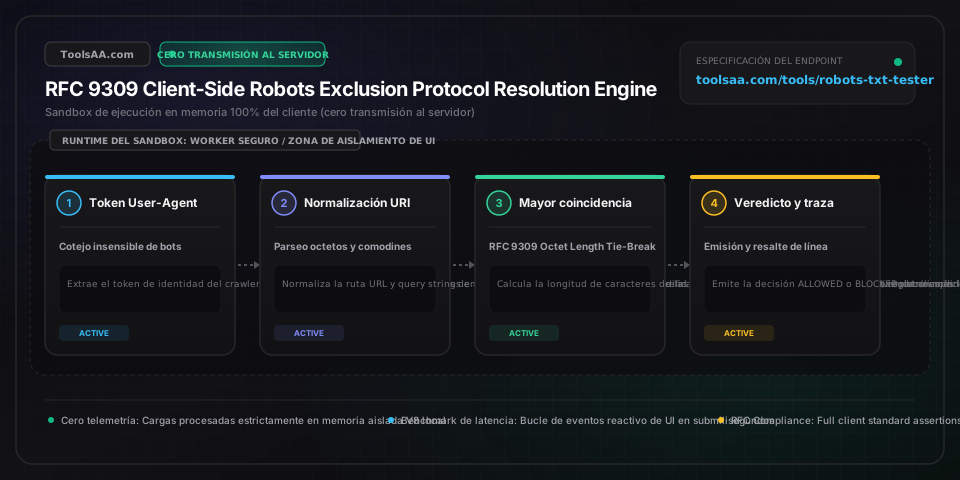
Designa el token de rastreador específico o los comodines a los que se dirigen los bloques de reglas posteriores. No distingue entre mayúsculas y minúsculas; la RFC 9309 estipula que las coincidencias exactas de tokens tienen prioridad estricta sobre coincidencias de prefijo parcial y grupos comodín universales (*).
Especifica los prefijos de ruta URI a los que el rastreador designado no debe acceder. Un valor Disallow vacío (Disallow:) indica que todas las rutas del sitio web tienen permiso de rastreo.
Especifica los prefijos de ruta URI a los que los rastreadores pueden acceder; se utiliza habitualmente para definir excepciones dentro de una ruta Disallow más amplia. Según la RFC 9309, cuando Allow y Disallow coinciden en longitud de ruta, Allow tiene prioridad.
Coincide con cualquier secuencia de cero o más caracteres URI válidos dentro de cadenas de ruta. Se utiliza con frecuencia para bloquear parámetros de consulta dinámicos (p. ej., /*?*sort=) o extensiones de archivo específicas (p. ej., /*.pdf$).
Fija explícitamente el patrón de coincidencia al final exacto de la ruta URL o cadena de consulta, evitando que coincida accidentalmente como prefijo de rutas anidadas más largas.
Especifica un intervalo de pausa en segundos entre solicitudes consecutivas del rastreador. Es respetada por Bingbot, Yandex y Baidu, pero Googlebot la ignora estrictamente, ya que gestiona su cadencia de rastreo mediante Google Search Console.
Declara la URL HTTPS absoluta del archivo sitemap XML o del índice de sitemaps del sitio. Puede situarse en cualquier parte del archivo robots.txt, dentro o fuera de los grupos de user-agent, aunque las buenas prácticas recomiendan incluirla al final del documento.
Límite oficial de especificación según la sección 2.1 de la RFC 9309 para archivos robots.txt. Los principales motores de búsqueda (incluidos Google y Bing) truncan el procesamiento a los 500 kibibytes (512.000 octetos), tratando el contenido restante como inexistente.
A diferencia de los cortafuegos o listas de control de acceso (ACL) que evalúan directivas de arriba a abajo, el protocolo oficial Robots Exclusion Protocol (RFC 9309) exige que la directiva con el mayor número de caracteres coincidentes prevalezca siempre. Si declaras Allow: /folder/sub/ (12 caracteres) después de Disallow: /folder/sub/restricted/ (25 caracteres), la regla Disallow más larga se impone para las rutas secundarias coincidentes, independientemente de su posición física en el archivo.
Bloquear /wp-admin/ sin declarar explícitamente Allow: /wp-admin/admin-ajax.php impide que el servicio de renderizado web de Googlebot (WRS) ejecute solicitudes frontend AJAX asíncronas. Esto provoca que Googlebot renderice diseños rotos, suspenda las pruebas de optimización para móviles y desvalorice erróneamente componentes interactivos.
Una directiva Disallow indica a los motores de búsqueda que no rastreen ni descarguen el contenido de una página, pero NO impide que la URL aparezca en los resultados de búsqueda de Google si existen enlaces externos que apuntan a ella. Google indexará la URL como un enlace básico con el fragmento 'No hay información disponible sobre esta página'. Para impedir la indexación de forma fiable, permite el rastreo e implementa <meta name="robots" content="noindex"> o la cabecera HTTP X-Robots-Tag: noindex.
Google dejó de admitir oficialmente la directiva no oficial Noindex dentro de robots.txt el 1 de septiembre de 2019. Cualquier regla noindex que permanezca en robots.txt se trata como sintaxis no válida o se ignora por completo. Los sitios que aún dependen de este truco heredado corren el riesgo de que sus URLs administrativas o entornos de prueba se indexen orgánicamente por accidente.
Para evitar que tus contenidos propietarios sean ingeridos por modelos de IA sin perder posicionamiento orgánico en Google, bloquea Google-Extended en lugar de Googlebot. Google-Extended es el token de rastreador exclusivo utilizado para entrenar Gemini, Vertex AI y AI Overviews, mientras que Googlebot se encarga de la indexación web del motor de búsqueda principal.
Guardar robots.txt en UTF-8 con marca de orden de bytes (BOM: \uFEFF) hace que los analizadores estrictos no reconozcan el token User-agent inicial de la línea 1, ya que el BOM precede a los caracteres. Esto invalida de facto el primer grupo de user-agent y provoca que los motores de búsqueda traten las directivas iniciales como comentarios huérfanos.
Esta advertencia surge cuando una página está bloqueada por Disallow en robots.txt, pero Google ha descubierto la URL a través de enlaces internos o externos. Al no poder descargar el contenido de la página, Google no puede leer las etiquetas noindex de la página. Para solucionarlo, elimina la regla Disallow en robots.txt para permitir el rastreo, añade una etiqueta <meta name="robots" content="noindex"> o la cabecera X-Robots-Tag: noindex en la respuesta HTML, y espera a que Googlebot la rastree y desindexe.
Conforme a la sección 2.2.2 de la RFC 9309, la evaluación de directivas se rige por la especificidad según la longitud en caracteres, no por el orden en el archivo. Si tu regla Disallow contiene más caracteres coincidentes que tu regla Allow (p. ej., Disallow: /products/archived/ con 20 caracteres frente a Allow: /products/ con 10 caracteres), la regla Disallow tiene prioridad. Asegúrate de que tu directiva Allow coincida con un número igual o superior de caracteres, empleando anclas de fin de línea ($) o segmentos de ruta más específicos.
Googlebot nunca ha admitido ni procesado la directiva Crawl-delay en robots.txt. Para moderar las solicitudes de rastreo de Googlebot, ajusta la frecuencia de rastreo en Google Search Console o configura tu servidor web o proxy inverso (Nginx, Cloudflare) para devolver códigos de estado HTTP 429 (Too Many Requests) o HTTP 503 (Service Unavailable) con una cabecera explícita Retry-After: 120.
Declarar Disallow: /press sin una barra diagonal final coincide con cualquier URL que comience por /press, incluidas /press-releases/, /press.html y /pressure-washing/. Para restringir el bloqueo exclusivamente al directorio y a sus subrecursos, añade siempre la barra diagonal final: Disallow: /press/.
Cuando un scraper declara su propio token de rastreador distintivo (p. ej., GPTBot o CCBot), la RFC 9309 establece que un grupo explícito que coincida con dicho token anula el grupo universal User-agent: *. Si tu robots.txt contiene un bloque separado para GPTBot con directivas permisivas, o si el bot opera mediante proxies rotativos no declarados, las reglas comodín se omiten. Crea bloques específicos para User-agent: GPTBot, User-agent: ClaudeBot y User-agent: CCBot con Disallow: /.
Según la sección 2.2.2 de la norma IETF RFC 9309, cuando una URL coincide simultáneamente con una directiva Allow y una directiva Disallow dentro del mismo grupo de user-agent, el analizador calcula la longitud de cada patrón coincidente en octetos. Gana la directiva cuya longitud de caracteres coincidentes sea mayor. Por ejemplo, para la URL /shop/sale/shoes, Disallow: /shop/sale/ (11 caracteres) se impone a Allow: /shop/ (6 caracteres). Si ambos patrones tienen exactamente la misma longitud de caracteres, la RFC 9309 dictamina que la directiva Allow tiene prioridad.
No. Bloquear una URL en robots.txt solo impide que los rastreadores de los motores de búsqueda descarguen y analicen el contenido de dicha página. Si otros sitios web o enlaces internos apuntan a la URL bloqueada, Google puede indexarla basándose en el texto de anclaje externo, mostrándola en las SERP sin fragmento de descripción (snippet). Para retirar una página de los resultados de Google por completo, permítela en robots.txt y aplica una etiqueta meta robots noindex o la cabecera de respuesta HTTP X-Robots-Tag: noindex.
Para bloquear los scrapers de entrenamiento de modelos fundacionales de IA preservando al mismo tiempo la visibilidad en búsqueda orgánica, añade grupos de user-agent explícitos para dichos bots de IA con Disallow: /, manteniendo User-agent: Googlebot y User-agent: Bingbot autorizados. Entre los tokens de bots de IA más habituales figuran GPTBot, ChatGPT-User, ClaudeBot, AnthropicAI, CCBot, Google-Extended, PerplexityBot, Bytespider y Diffbot. Bloquear específicamente Google-Extended desactiva el uso para entrenamiento de IA sin afectar al rastreo o indexación estándar de Google Search.
Disallow en robots.txt es una directiva de prevención de rastreo: impide que los bots soliciten el archivo de la página, conservando ancho de banda del servidor y presupuesto de rastreo (crawl budget), pero no garantiza su exclusión de los índices de búsqueda. Por el contrario, la etiqueta <meta name="robots" content="noindex"> es una directiva de prevención de indexación: ordena a los motores de búsqueda retirar la página de los listados de resultados. Para que una etiqueta noindex pueda ser procesada, los motores de búsqueda deben tener permiso para rastrear la página en robots.txt.
Googlebot no admite la directiva Crawl-delay porque la infraestructura de rastreo distribuido de Google utiliza algoritmos dinámicos y automatizados de detección de carga que ajustan la tasa de peticiones en tiempo real según la latencia de respuesta y la tasa de errores del servidor de origen. Si Googlebot genera una carga excesiva en tu servidor, gestiona la frecuencia de rastreo mediante los ajustes de tasa de rastreo en Google Search Console o devuelve códigos de estado HTTP 429 o 503 con una cabecera Retry-After.
El estándar oficial RFC 9309 fija un límite máximo de tamaño de archivo de 500 kibibytes (KiB), equivalente a 512.000 octetos. Los principales motores de búsqueda, incluidos Google y Bing, truncan los archivos robots.txt que superan los 500 KiB y procesan únicamente el contenido inicial, descartando todas las directivas posteriores. Además, si la descarga de un archivo robots.txt tarda más de 30 segundos, los buscadores lo consideran un error temporal de servidor 5xx y pueden suspender el rastreo por completo.
Convierte Markdown en código HTML limpio y listo para producción en tiempo real. Incluye tablas GFM, resaltado de sintaxis, saneamiento XSS, copia de texto enriquecido y exportación completa.
Analice expresiones cron en descripciones legibles. Inspeccione marcas de tiempo en múltiples zonas horarias, valide sintaxis crontab y proyecte próximas ejecuciones.
Convierte esquemas SDL y consultas GraphQL en tipos, interfaces, enums y resolvers de TypeScript. Generación de código instantánea en el navegador sin configuración ni envío a servidores.
Convierte HTML a Markdown con tablas GitHub Flavored Markdown (GFM), bloques de código y recorte web. Elimina estilos inline y exporta archivos .md limpios.
Compara texto, código y archivos con nuestro rápido motor de diff. Inspecciona cambios lado a lado o en línea a nivel de caracteres, omite espacios en blanco y exporta parches unificados.
Genere etiquetas rel=canonical y cabeceras HTTP válidas. Elimine parámetros de seguimiento, normalice URLs y resuelva problemas de contenido duplicado en SEO.