Testeur Robots.txt

Testeur & Validateur Robots.txt

Testez et validez la syntaxe robots.txt selon la norme RFC 9309. Vérifiez les autorisations de crawl par User-Agent, déboguez les chemins Disallow et inspectez les sitemaps.

Charger un exemple standard
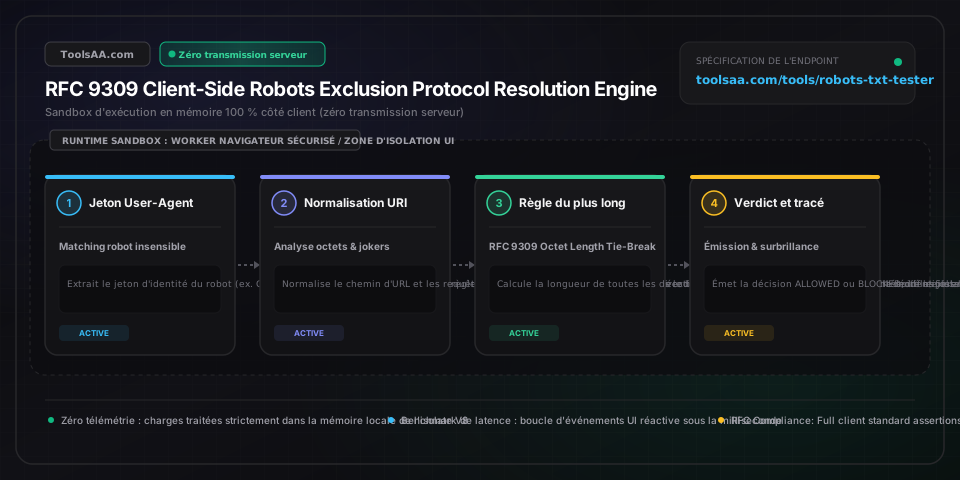
Moteur d'évaluation de crawlMoteur de résolution déterministe par préfixe le plus long selon la norme RFC 9309
Étape 1 : Analyse de l'URI et du User-AgentHTTP 200Étape 2 : Normalisation du chemin RFC29 octetsÉtape 3 : Identification du groupe User-Agent (1)Ligne 1Étape 4 : Résolution du motif le plus long2 Lbl candidatesCRAWL AUTORISÉ (ALLOWED)
Éditeur de code robots.txt
12 lignes•272 B•1 groupes
Syntaxe RFC 9309 valide
CRAWL AUTORISÉ (ALLOWED)

Le robot est autorisé à accéder et à indexer cette URI.

Googlebot
Directive gagnante appliquéeRfc spec section
LigneLigne 8
Type de directiveAllow: /catalog/
Longueur (Spécificité)9 octets
Le User-Agent cible correspond précisément à l'en-tête du groupe.Aucun groupe spécifique trouvé ; évaluation sur le groupe générique (User-agent: *).
Logique de résolutionRègle résolue : Allow prévaut sur Disallow à longueur de motif identique selon la RFC 9309.
Journal de traçabilité de résolution
[1]Normalized URI Path: /catalog/shoes?sort=price_asc
[2]Target User-Agent: Googlebot
[3]HTTP Response Simulation: 200
[4]No exact bot match; fallback to wildcard group (User-agent: *) at line 1
[5]Line 6: [Disallow: /*?*sort=] MATCH (Length: 9, Regex: ^/.*\?.*sort=)
[6]Line 8: [Allow: /catalog/] MATCH (Length: 9, Regex: ^/catalog/)
[7]Line 8: Equal length tie resolved: Allow takes precedence.
[8]Final Verdict: ALLOWED by winning rule on line 8
Chemin cible normalisé :/catalog/shoes?sort=price_asc
Régime de conformité et moteurGooglebot Production Standard
Lignes totales12
Groupes User-Agent1
Sitemaps déclarés2
Taille du fichier272 B
Statut RFCConforme RFC 9309
Verdict de crawlCRAWL AUTORISÉ (ALLOWED)
Référence technique et guide d'architecture

Testeur Robots.txt & Validateur RFC — Guide de référence

Testez et validez la syntaxe de votre robots.txt selon la norme RFC 9309. Contrôlez les autorisations de crawl par User-agent, déboguez les règles Disallow et inspectez vos sitemaps directement dans votre navigateur.

Testeur Robots.txt & Validateur RFC — Guide de référence — Architecture en mémoire côté client et flux de données

Paramètres clés et contrôles

Directive User-agentMotif d'identification de robot

Désigne le jeton du robot d'exploration ou le caractère générique ciblé par le bloc de règles suivant. Insensible à la casse ; la norme RFC 9309 stipule qu'une correspondance exacte du nom de robot prime strictement sur les correspondances de préfixes partiels et le groupe générique universel (*).

Par défaut : *
Motif de chemin DisallowPréfixe de chemin d'URI

Spécifie les préfixes de chemins d'URI interdits d'accès au robot désigné. Une valeur Disallow vide (Disallow:) indique que tous les chemins du site sont autorisés à l'exploration.

Par défaut : /private/
Spécificité de la directive AllowMotif d'exception de chemin d'URI

Spécifie les préfixes de chemins d'URI accessibles aux robots, généralement utilisés pour définir des exceptions au sein d'une règle Disallow plus large. Selon la RFC 9309, si Allow et Disallow correspondent à une longueur de chaîne identique, Allow prévaut.

Par défaut : /private/public-asset.js
Caractère générique astérisque (*)Jeton de correspondance de motif

Correspond à toute séquence de zéro ou plusieurs caractères valides d'URI dans un chemin. Couramment employé pour bloquer des paramètres d'URL dynamiques (ex. : /*?*sort=) ou des extensions de fichiers ciblées (ex. : /*.pdf$).

Par défaut : /*?*sort=
Ancre de fin d'URI ($)Jeton d'ancrage de fin de chaîne

Verrouille explicitement la correspondance à la fin exacte du chemin d'URL ou de la chaîne de requête, empêchant tout filtrage involontaire de chemins enfants plus longs.

Par défaut : /exact-page$
Directive Crawl-delayDirective de limitation de débit (non standard)

Indique l'intervalle de pause en secondes entre deux requêtes consécutives d'un robot. Respectée par Bingbot, Yandex et Baidu, mais strictement ignorée par Googlebot, qui s'appuie sur les paramètres de fréquence d'exploration de Google Search Console.

Par défaut : 10
Déclaration de SitemapDirective de localisation de métadonnées

Déclare l'URL absolue HTTPS du fichier sitemap XML ou de l'index de sitemaps. Peut figurer n'importe où dans le robots.txt (à l'intérieur ou hors des blocs user-agent), mais les bonnes pratiques recommandent de la placer en fin de fichier.

Par défaut : https://example.com/sitemap.xml
Limite de taille de fichier de 500 KioLimite structurelle du protocole

Limite officielle de la section 2.1 de la RFC 9309 pour les fichiers robots.txt. Les principaux moteurs de recherche (dont Google et Bing) tronquent l'analyse à 500 kibioctets (512 000 octets), ignorant totalement le contenu au-delà de ce seuil.

Par défaut : 500 KiB

Conseils de pro et bonnes pratiques

La règle RFC 9309 de la correspondance la plus longue prime sur l'ordre des lignes

Contrairement aux pare-feu ou aux listes de contrôle d'accès qui évaluent les règles de haut en bas, le protocole officiel d'exclusion des robots (RFC 9309) impose que la directive comportant le plus grand nombre de caractères correspondants l'emporte systématiquement. Si vous déclarez Allow: /folder/sub/ (12 caractères) après Disallow: /folder/sub/restricted/ (25 caractères), la règle Disallow, plus longue, prévaudra pour les chemins enfants correspondants, quel que soit leur ordre d'apparition dans le fichier.

Le piège critique du rendu JavaScript de WordPress avec admin-ajax.php

Bloquer /wp-admin/ sans déclarer explicitement Allow: /wp-admin/admin-ajax.php empêche le service de rendu web de Googlebot (WRS) d'exécuter les requêtes AJAX asynchrones côté front-end. Googlebot génère alors un rendu visuel tronqué, échoue aux tests d'ergonomie mobile et déprécie à tort la valeur de vos composants interactifs.

Une directive Disallow dans robots.txt n'empêche PAS l'indexation de l'URL par Google

Une directive Disallow indique aux moteurs de ne pas explorer ni télécharger le contenu d'une page, mais elle n'empêche absolument pas l'URL d'apparaître dans les résultats de recherche Google si des liens externes ou internes pointent vers elle. Google indexera l'URL sous la forme d'un lien nu sans extrait avec la mention « Aucune information n'est disponible pour cette page ». Pour empêcher formellement toute indexation, vous devez autoriser le crawl et appliquer une balise <meta name="robots" content="noindex"> ou l'en-tête HTTP X-Robots-Tag: noindex.

Dépréciation définitive de la directive Noindex dans robots.txt

Google a officiellement cessé de prendre en charge la directive non standard Noindex dans le robots.txt le 1er septembre 2019. Toute règle noindex résiduelle est traitée comme une syntaxe invalide ou purement ignorée. Les sites qui s'appuient encore sur cette pratique historique s'exposent à l'indexation organique accidentelle d'environnements de préproduction ou d'interfaces d'administration sensibles.

Dissocier l'indexation SEO de l'entraînement des modèles d'IA générative

Pour interdire l'ingestion de vos contenus propriétaires par les modèles d'IA sans dégrader votre visibilité sur le moteur de recherche Google, bloquez le jeton Google-Extended plutôt que Googlebot. Google-Extended est le robot dédié à l'entraînement de Gemini, Vertex AI et des aperçus IA (AI Overviews), tandis que Googlebot gère l'indexation web standard du moteur.

Invalidation silencieuse du parseur due au BOM UTF-8 (Byte Order Mark)

Enregistrer un fichier robots.txt en UTF-8 avec un indicateur d'ordre des octets (BOM : \uFEFF) empêche les parseurs stricts de reconnaître la directive User-agent sur la première ligne, le BOM précédant les caractères utiles. Cela invalide tout le premier groupe de règles, incitant les moteurs de recherche à ignorer ces directives en les traitant comme de simples commentaires orphelins.

Pièges courants et dépannage

⚠️L'URL affiche l'avertissement « Indexée malgré le blocage par le fichier robots.txt » dans Google Search Console

Cet avertissement survient lorsqu'une page est bloquée par Disallow, mais que Google a découvert son URL via des liens entrants internes ou externes. Google ne pouvant pas explorer le contenu de la page, il ne peut pas interpréter les balises noindex présentes dans le HTML. Pour résoudre ce problème, supprimez la règle Disallow dans le robots.txt afin d'autoriser le crawl, intégrez une balise <meta name="robots" content="noindex"> ou l'en-tête HTTP X-Robots-Tag: noindex dans la réponse, puis attendez que Googlebot réexplore la page pour la désindexer.

⚠️La directive Allow explicite est ignorée et l'URL reste bloquée par Disallow

Selon la section 2.2.2 de la RFC 9309, l'évaluation des directives dépend de la spécificité en nombre de caractères et non de leur position dans le fichier. Si votre règle Disallow compte plus de caractères correspondants que votre règle Allow (ex. : Disallow: /products/archived/ avec 20 caractères contre Allow: /products/ avec 10 caractères), Disallow l'emporte. Veillez à ce que votre directive Allow atteigne une longueur égale ou supérieure, notamment en utilisant des ancres de fin ($) ou des segments d'URL plus précis.

⚠️Googlebot ignore Crawl-delay et sature le processeur et la mémoire du serveur web

Googlebot n'a jamais interprété ni pris en charge la directive Crawl-delay dans robots.txt. Pour réguler les requêtes de Googlebot, ajustez la fréquence d'exploration dans les paramètres dédiés de Google Search Console, ou configurez votre serveur web ou proxy inverse (Nginx, Cloudflare) pour renvoyer un code d'état HTTP 429 (Too Many Requests) ou HTTP 503 (Service Unavailable) assorti d'un en-tête explicite Retry-After: 120.

⚠️La règle Disallow d'un répertoire bloque accidentellement des fichiers sans barre oblique terminale

Déclarer Disallow: /press sans barre oblique finale (/ trailing slash) cible toutes les URL commençant par /press, y compris /press-releases/, /press.html et /pression-pneus.html. Pour restreindre le blocage uniquement au répertoire visé et à ses sous-ressources, ajoutez toujours un slash final : Disallow: /press/.

⚠️Les robots de scraping d'IA (CCBot, GPTBot) continuent d'explorer malgré un Disallow générique avec User-agent: *

Lorsqu'un bot de collecte utilise son propre jeton d'identification (ex. : GPTBot ou CCBot), la norme RFC 9309 stipule qu'un groupe de règles correspondant explicitement à ce jeton annule le groupe universel User-agent: *. Si votre robots.txt contient un bloc distinct plus permissif pour ce robot, ou si celui-ci ignore la conformité via des proxies tournants, les règles génériques sont inopérantes. Créez des blocs explicites pour User-agent: GPTBot, User-agent: ClaudeBot et User-agent: CCBot avec Disallow: /.

Foire aux questions (FAQ)

Comment la règle de la correspondance la plus longue de la RFC 9309 résout-elle les conflits entre Allow et Disallow ?▼

Selon la section 2.2.2 de l'IETF RFC 9309, lorsqu'une URL correspond à la fois à une directive Allow et à une directive Disallow au sein du même groupe user-agent, le parseur calcule la longueur en octets de chaque motif correspondant. La directive présentant le plus grand nombre de caractères correspondants l'emporte. Par exemple, pour l'URL /shop/sale/shoes, Disallow: /shop/sale/ (11 caractères) prévaut sur Allow: /shop/ (6 caractères). Si les deux motifs affichent exactement la même longueur de caractères, la RFC 9309 impose que la directive Allow soit prioritaire.

Le blocage d'une URL dans le fichier robots.txt empêche-t-il son apparition dans les résultats Google ?▼

Non. Bloquer une URL dans robots.txt empêche uniquement les robots d'exploration de télécharger et d'analyser le contenu de la page. Si d'autres sites web ou pages internes pointent vers cette URL, Google peut tout de même l'indexer à partir des textes d'ancrage externes et l'afficher dans les résultats de recherche sans extrait (snippet). Pour exclure définitivement une page des résultats de recherche Google, vous devez en autoriser l'exploration dans robots.txt et implémenter une balise méta robots noindex ou un en-tête HTTP de réponse X-Robots-Tag: noindex.

Comment bloquer les robots d'IA comme GPTBot et ClaudeBot sans pénaliser son référencement naturel (SEO) ?▼

Pour bloquer les scrapers d'entraînement des modèles de fondation d'IA tout en préservant votre visibilité SEO organique, ajoutez des groupes user-agent explicites pour les robots d'IA avec la règle Disallow: /, tout en maintenant les autorisations pour User-agent: Googlebot et User-agent: Bingbot. Les principaux jetons de robots IA incluent GPTBot, ChatGPT-User, ClaudeBot, AnthropicAI, CCBot, Google-Extended, PerplexityBot, Bytespider et Diffbot. Le blocage de Google-Extended neutralise spécifiquement l'utilisation de vos données pour l'apprentissage de l'IA sans impacter l'exploration ni l'indexation de Google Search.

Quelle est la différence entre la directive Disallow de robots.txt et la balise méta noindex ?▼

La directive Disallow de robots.txt est une directive de blocage d'exploration : elle empêche les robots de requérir le fichier de la page, préservant la bande passante du serveur et le budget de crawl, mais ne garantit pas l'exclusion des index de recherche. À l'inverse, la balise <meta name="robots" content="noindex"> est une directive d'interdiction d'indexation : elle ordonne aux moteurs de retirer la page des résultats de recherche. Pour qu'une balise noindex soit prise en compte, les moteurs de recherche doivent impérativement être autorisés à explorer la page dans robots.txt.

Pourquoi Google Search ignore-t-il la directive Crawl-delay dans le fichier robots.txt ?▼

Googlebot ne prend pas en charge la directive Crawl-delay car l'infrastructure distribuée de Google utilise des algorithmes d'équilibrage de charge automatisés qui ajustent la fréquence des requêtes en temps réel en fonction de la latence et du taux d'erreur du serveur d'origine. Si Googlebot surcharge votre serveur, régulez sa fréquence via les paramètres de vitesse d'exploration dans Google Search Console, ou renvoyez des codes d'état HTTP 429 ou HTTP 503 assortis d'un en-tête Retry-After.

Quelle est la taille maximale autorisée pour un fichier robots.txt avant troncature par les moteurs ?▼

La norme officielle RFC 9309 fixe une limite maximale de taille de fichier à 500 kibioctets (Kio), soit l'équivalent de 512 000 octets. Les principaux moteurs de recherche, dont Google et Bing, tronquent tout fichier robots.txt dépassant 500 Kio et n'en traitent que le début, écartant l'ensemble des directives suivantes. De plus, si le téléchargement du fichier robots.txt excède 30 secondes, les moteurs considèrent qu'il s'agit d'une erreur serveur temporaire de type 5xx et peuvent suspendre intégralement l'exploration.

Outils et utilitaires connexes

Tous les outils →