Calculadora de RAID & ZFS

Calculadora de Capacidade RAID & ZFS

Calcule a capacidade de armazenamento útil em TB decimais e TiB binários para arranjos RAID 0, 1, 5, 6, 10, 50, 60 e ZFS RAIDZ1/Z2/Z3 com overhead de paridade, risco de falha por URE no rebuild, tempo de reconstrução e visualizador de baias.

Carregar Exemplo
Configuração do Arranjo RAID
Tolerância a Falhas:2 Drives per vdev
4 Disco
0 Reserva
Discos de Dados: 2 | Discos de Paridade: 2 | Discos Hot Spare: 04 Tolerância Máxima a Falhas
Capacidade Útil (TiB)28.19 TiB
Eficiência de Armazenamento48.4%
Limite Seguro de 80% (TiB)22.56 TiB
Risco de URE na Reconstrução0.0%
Tempo de Reconstrução22.2 Horas
Custo por TiB Útil$38.31

Visualizador de Baias de Disco

ZFS RAIDZ2 (Dual Parity vdev) • 4 Baia Online

Dados (2)Paridade (2)
STORAGE CHASSIS ENCLOSURE // ZFS
#01
Disco #1 • 16 TBdata

Online • 7,200 RPM Enterprise HDD (~200 MB/s) • URE: 10⁻¹⁵ (1 sector per ~125 TB) - NAS Pro / CMR

Custo do Disco:$270.00
Custo Total: $1,080.00Custo por TiB Útil: $38.31Custo por TB Útil: $34.84
Referência técnica e guia de arquitetura

Calculadora de RAID & Guia ZFS — Guia de referência

Calcule a capacidade útil de armazenamento em TB decimais e TiB binários para arranjos RAID 0, 1, 5, 6, 10, 50, 60 e ZFS RAIDZ1/Z2/Z3 com overhead de paridade, risco de falha por URE, tempo de reconstrução e visualizador de baias.

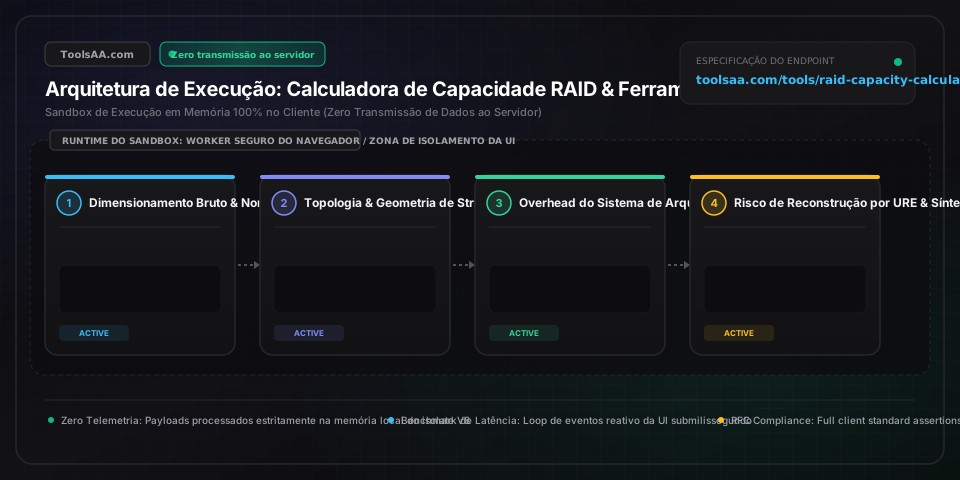
Calculadora de RAID & Guia ZFS — Guia de referência — Arquitetura em memória do lado do cliente e fluxo de dados

Parâmetros-chave e controles

Razão de Dimensionamento Terabytes Decimais (TB) vs Tebibytes Binários (TiB) (IEC 80000-13)Constante de Conversão de Raiz (Float64)

Define a divergência matemática de base entre a rotulagem decimal dos fabricantes de discos (1 TB = 10^12 bytes) e o endereçamento binário em sistemas POSIX (1 TiB = 2^40 = 1.099.511.627.776 bytes), em conformidade com as normas IEC 80000-13 e IEEE 754-2019. Executado localmente via JavaScript no cliente com complexidade O(1), este fator estabelece uma redução aparente imutável de 9,0949% na capacidade antes da criação de estruturas de sistemas de arquivos ou particionamento GPT EFI.

Padrão: 0.90949470177
Taxa de Erros de Bits (BER) por Erro de Leitura Irrecuperável (URE)Constante Exponencial de Poisson

Probabilidade estatística de encontrar um setor físico ilegível durante a reconstrução sequencial do arranjo, modelada como P(falha) = 1 - exp(-Total_Bits_Lidos * BER). HDDs SATA de consumo operam com BER de 10^-14 (1 erro de setor a cada 12,5 TB lidos), discos corporativos Nearline SAS operam em 10^-15 e drives corporativos de missão crítica SAS/NVMe U.2/U.3 atingem 10^-16, definindo o limiar matemático em que topologias de dupla paridade (RAID 6 / RAIDZ2) tornam-se mandatórias.

Padrão: 1e-14 (SATA de Consumo)
Fator de Penalidade de Escrita (Multiplicador Read-Modify-Write RMW)Coeficiente de Multiplicação de I/O

Quantifica as transações físicas de I/O em discos/NAND necessárias para concluir uma única gravação aleatória de stripe sob a semântica POSIX I/O. O RAID 0 incorre em 1 operação de I/O, o RAID 1/10 incorre em 2 (gravações espelhadas paralelas), o RAID 5 incorre em 4 (2 leituras + 2 gravações para dados e paridade) e o RAID 6 incorre em 6 (3 leituras + 3 gravações nas síndromes P+Q calculadas no campo de Galois GF(2^8)), determinando os requisitos de buffers de coalescência de escrita em memória.

Padrão: 4 (RAID 5) / 6 (RAID 6)
Reserva de Slop Space do Zpool OpenZFS & Geometria de Setor de Vdev ashiftFlag de Geometria de Vdev / Memória de Kernel

Buffer em nível de kernel que reserva 1/32 (3,125%, mínimo de 128 MiB) da capacidade bruta do zpool via vdev_slop_shift=5, garantindo que operações administrativas (zfs destroy, zfs rollback) sejam executadas sem gerar erros de pânico POSIX ENOSPC (falta de espaço). Impõe ashift=12 (limite de alocação de 4.096 bytes) para evitar amplificação de escrita superior a 300% em setores físicos Advanced Format 512e e 4Kn.

Padrão: Reserva de 3,125% (ashift=12)
Sandbox de Execução no Navegador com Zero Telemetria & Isolamento CriptográficoContrato de Isolamento no Cliente

Garante que todos os cálculos de arranjo, vetores de sobrevivência de reconstrução por Poisson e geometrias de paridade sejam executados exclusivamente na sandbox WebAssembly/V8 do cliente, com zero telemetria de rede ou transmissão ao servidor. Configurações de topologia de armazenamento, geometrias de discos e capacidades de datastores permanecem isoladas na memória volátil local, em conformidade com arquiteturas zero-trust e confidencialidade criptográfica.

Padrão: Sandbox Isolada no Cliente (0 bytes de I/O de rede)

Dicas profissionais e melhores práticas

O Abismo de Desempenho dos 80% em Sistemas Copy-on-Write

Nunca ultrapasse 80% de alocação em pools de armazenamento Copy-on-Write (ZFS / Btrfs). Quando a capacidade do pool cruza o limite de 80%, o alocador de espaço do ZFS migra de um algoritmo first-fit de mapa de espaço O(1) para uma busca intensiva do tipo best-fit através dos metaslabs. Isso desencadeia fragmentação catastrófica no sistema de arquivos, destruindo a localidade de gravação sequencial e reduzindo os IOPS de escrita aleatória em até 70%.

A Armadilha de IOPS Aleatórios em Vdevs Largos no RAIDZ

Um único vdev RAIDZ do ZFS entrega o desempenho de IOPS de gravação aleatória de apenas UM disco constituinte, independentemente de abranger 4 ou 24 discos. Configurar um chassi de 24 baias como um único vdev RAIDZ2 de 24 discos compromete drasticamente datastores de máquinas virtuais e a vazão de logs de transação de bancos de dados. Para escalar IOPS linearmente, agrupe em stripe múltiplos vdevs menores (ex.: quatro vdevs RAIDZ2 de 6 discos) ou utilize vdevs espelhados (equivalente a RAID 10).

Incompatibilidade de Setores e Amplificação de Escrita com ashift=12

Sempre formate discos rígidos e SSDs modernos com Advanced Format 4Kn e 512e utilizando ashift=12 (alinhamento de setores de 4.096 bytes) ao criar pools ZFS (`zpool create -o ashift=12`). Manter o padrão legado ashift=9 (setores de 512 bytes) faz com que setores nativos de 4 KB sejam divididos em múltiplas gravações físicas, provocando uma penalidade inevitável de amplificação de escrita superior a 300%, o que degrada o rendimento de I/O e acelera o desgaste de células NAND.

Disparidade de Sobrevivência entre Dupla Paridade e Hot Spare

Migrar um pool de armazenamento de RAID 5 + Hot Spare Dedicado para um arranjo RAID 6 ativo com a mesma quantidade de discos oferece uma taxa de sobrevivência exponencialmente superior. Um disco hot spare permanece totalmente ocioso em operação normal e oferece redundância zero durante a janela crítica de estresse da reconstrução. Em contraste, o RAID 6 mantém dupla paridade Reed-Solomon ativa o tempo todo, suportando a falha de um segundo disco ou erro URE durante todo o processo de reconstrução.

Armadilhas comuns e solução de problemas

⚠️A capacidade útil no sistema de arquivos é de 4% a 9% inferior ao espaço bruto calculado do volume

A reserva para o superusuário (root) e a sobrecarga de metadados de partição consomem blocos brutos. O Linux ext4 reserva automaticamente 5% dos blocos do volume para o root para prevenir travamentos gerais do sistema; libere esse espaço em pontos de montagem secundários executando 'tune2fs -m 1 /dev/sdX' para reduzir a reserva a 1%. Além disso, considere as tabelas de partição GPT EFI, as extensões de metadados LVM (4-8 MiB) e a reserva de 3,125% de slop space do ZFS ('spa_slop_shift=5'), que garante margem para snapshots copy-on-write e operações de exclusão de arquivos.

⚠️Erro de Leitura Irrecuperável (URE) aborta a reconstrução do arranjo e define o pool como offline

Falhas secundárias de leitura durante o rebuild de um RAID 5 de paridade simples ocorrem ao encontrar setores ilegíveis nos discos sobreviventes de 8 TB ou mais. Interrompa imediatamente qualquer operação de escrita e gere clones brutos bit a bit de todos os discos íntegros em outra mídia via 'ddrescue -b 4096 /dev/sdX /media/recovery.img' antes de executar o fsck ou reinicializar metadados. Para eliminar essa vulnerabilidade em arranjos futuros, torne obrigatório o uso de dupla paridade (RAID 6 ou RAIDZ2) para qualquer conjunto com discos >= 4 TB, suportando erros de leitura em setores secundários.

⚠️Sobrecarga severa de disco (thrashing) e velocidades de transferência degradadas durante a resilveração do ZFS

A degradação durante a resilveração decorre de gargalos de cache em discos SMR (Shingled Magnetic Recording) ou de contenção de metadados por dimensionamento insuficiente da memória ARC (Adaptive Replacement Cache). Verifique com 'smartctl -i /dev/sdX' se os discos utilizam tecnologia CMR (Conventional Magnetic Recording); substitua imediatamente unidades SMR gerenciadas pelo disco ou pelo host. Para estabilizar cargas de trabalho em produção, limite a prioridade de I/O do resilver com 'zfs set zfs:zfs_resilver_min_time_ms=2000' e aumente a memória ARC do host para evitar expulsão contínua de metadados em cache.

Perguntas frequentes (FAQ)

Como calcular a capacidade útil de RAID entre os diferentes níveis de arranjo?▼

A capacidade útil do RAID é definida pela topologia do arranjo e pela sobrecarga de discos de paridade: RAID 0 fornece N * Capacidade_Disco (0% de perda de paridade); RAID 1 fornece 1 * Capacidade_Disco (50% de perda por espelhamento em 2 discos); RAID 5 fornece (N - 1) * Capacidade_Disco; RAID 6 fornece (N - 2) * Capacidade_Disco; e RAID 10 fornece (N / 2) * Capacidade_Disco. Em pools ZFS RAIDZ, deduza um percentual adicional de 3,125% (1/32) alocado para slop space e converta terabytes decimais para tebibytes binários aplicando o fator 0,9095 (1 TiB = 10^12 / 2^40 TB).

Por que a capacidade formatada do RAID é menor do que a anunciada pelos fabricantes de disco?▼

Os fabricantes de discos comercializam a capacidade em notação decimal, em que 1 Terabyte (TB) = 10^12 bytes, enquanto os sistemas operacionais endereçam o armazenamento em Tebibytes binários (TiB), onde 1 TiB = 2^40 = 1.099.511.627.776 bytes. Essa discrepância matemática gera uma redução aparente imediata de 9,0949% (por exemplo, um disco de 18 TB entrega apenas ~16,37 TiB brutos). Metadados de tabelas de partição (GPT EFI), estruturas do sistema de arquivos (tabelas de inodes, extensões de journal) e reservas de slop space do ZFS reduzem ainda mais a capacidade útil final.

Por que o RAID 5 é perigoso com discos rígidos de alta capacidade de 16 TB ou 18 TB?▼

O RAID 5 tolera a falha de apenas um disco, exigindo a leitura integral de todos os discos sobreviventes para recalcular a paridade durante a reconstrução. Discos SATA convencionais de consumo especificam uma taxa de URE (Erro de Leitura Irrecuperável) de 10^-14 (1 bit corrompido a cada 12,5 TB lidos). A reconstrução de um arranjo de 4 discos de 16 TB exige a leitura contínua de 48 TB de dados, resultando em uma probabilidade estatística de falha de rebuild superior a 98% pelo modelo de Poisson P = 1 - exp(-Bits * BER), o que causa a perda total do arranjo se apenas um setor ilegível for encontrado.

Qual é a diferença entre RAID 10 e RAID 6 para armazenamento de bancos de dados?▼

O RAID 10 combina striping entre pares espelhados com um fator de penalidade de escrita de 2, enquanto o RAID 6 calcula dupla paridade Reed-Solomon P+Q com uma penalidade de escrita de 6. Para bancos de dados transacionais com alta taxa de operações (MySQL, PostgreSQL, Oracle) e intensa carga de gravação aleatória, o RAID 10 oferece 300% mais IOPS de escrita aleatória e reconstrói discos degradados sem a sobrecarga de recálculo de paridade. Já o RAID 6 é otimizado para vazão sequencial de leitura pesada, repositórios de backup e armazenamento de arquivamento com melhor custo por gigabyte.

Qual a diferença entre o ZFS RAIDZ2 e o RAID 6 tradicional por hardware?▼

O ZFS RAIDZ2 substitui stripes fixos e controladoras físicas com baterias de cache (BBU) por larguras dinâmicas de stripe e checksums criptográficos Fletcher4/SHA-256 de 128 bits, eliminando por completo a vulnerabilidade crítica de 'write hole' típica do RAID 5/6. Durante a reconstrução (resilver), o ZFS lê e recalcula apenas metadados válidos e blocos de dados ativos em vez de varrer setores vazios não alocados, além de detectar e reparar automaticamente corrupção silenciosa de dados (bit rot) durante verificações periódicas de scrub.

O que é a regra dos 80% para pools ZFS e como funciona o slop space?▼

A regra dos 80% no ZFS estipula que a utilização do pool de armazenamento não deve ultrapassar 80% para evitar a transição do alocador first-fit de mapa de espaço O(1) para uma busca best-fit de alta latência, que causa fragmentação severa e queda de IOPS. Concomitantemente, o OpenZFS aplica uma reserva padrão de slop space de 3,125% (1/32 da capacidade bruta total do pool, mínimo de 128 MiB) gerenciada por 'spa_slop_shift=5', assegurando que operações administrativas como remoção de snapshots, exclusão de sistemas de arquivos e gravação de metadados continuem funcionando caso o pool atinja 100% da cota do usuário.

Quanto tempo demora a reconstrução de um RAID com discos de 16 TB ou 20 TB?▼

A duração do rebuild depende da capacidade bruta do disco, da largura de banda sequencial sustentada de gravação, da vazão do backplane da controladora e da carga concorrente de I/O das aplicações. Sem carga em segundo plano, um disco corporativo de 18 TB e 7.200 RPM sustentando 200 MB/s leva cerca de 25 a 30 horas para ser reconstruído. Sob uma carga de trabalho de produção transacional de 50% ou quando utilizado com discos SMR (Shingled Magnetic Recording), o tempo de reconstrução pode saltar para 5 a 9 dias, ampliando expressivamente a janela de vulnerabilidade a falhas secundárias de hardware.

Ferramentas e utilitários relacionados

Todas as ferramentas →