Laufwerkseinschübe und Gehäusebelegung
ZFS RAIDZ2 (Dual Parity vdev) • 4 Einschub Online
Online • 7,200 RPM Enterprise HDD (~200 MB/s) • URE: 10⁻¹⁵ (1 sector per ~125 TB) - NAS Pro / CMR
Berechnen Sie die nutzbare Speicherkapazität in dezimalen TB und binären TiB für RAID 0, 1, 5, 6, 10, 50, 60 sowie ZFS RAIDZ1/Z2/Z3 inklusive Paritäts-Overhead, URE-Rebuild-Risiko, Rebuild-Dauer und Drive-Bay-Visualisierung.
ZFS RAIDZ2 (Dual Parity vdev) • 4 Einschub Online
Online • 7,200 RPM Enterprise HDD (~200 MB/s) • URE: 10⁻¹⁵ (1 sector per ~125 TB) - NAS Pro / CMR
Berechnen Sie die nutzbare Speicherkapazität in dezimalen TB und binären TiB für RAID 0, 1, 5, 6, 10, 50, 60 sowie ZFS RAIDZ1/Z2/Z3 unter Berücksichtigung von Paritäts-Overhead, URE-Rebuild-Ausfallrisiko, Wiederherstellungsdauer und Festplatteneinschub-Visualisierung.
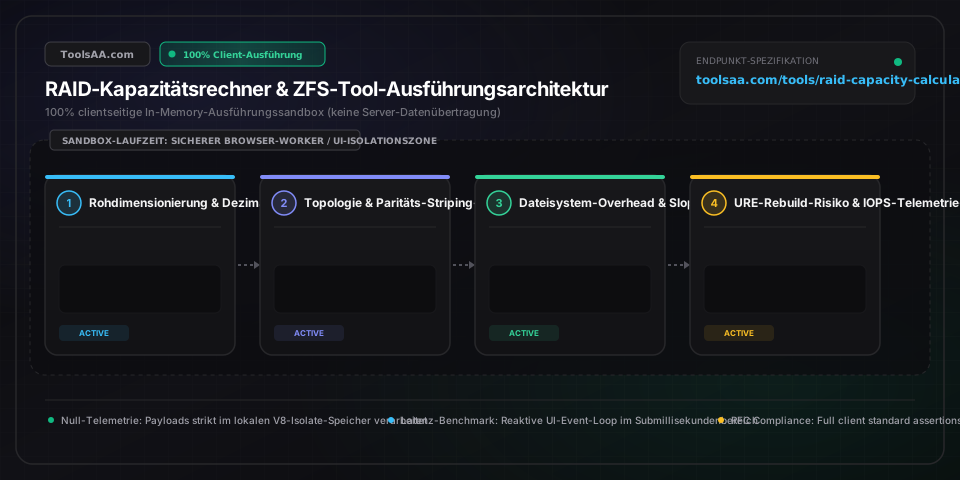
Regelt die mathematische Basisdivergenz zwischen der dezimalen Herstellerangabe von Datenträgern (1 TB = 10^12 Bytes) und der binären Adressierung in POSIX-Betriebssystemen (1 TiB = 2^40 = 1.099.511.627.776 Bytes) gemäß den Präzisionsnormen IEC 80000-13 und IEEE 754-2019. Dieser Faktor wird clientseitig in JavaScript mit O(1)-Komplexität berechnet und bewirkt eine unveränderliche rechnerische Kapazitätsreduktion von 9,0949 % noch vor Abzug von Dateisystemstrukturen oder GPT-EFI-Partitionstabellen.
Statistische Wahrscheinlichkeit für das Auftreten eines unlesbaren physischen Sektors während des sequenziellen Rebuilds eines Arrays, modelliert als P(Ausfall) = 1 - exp(-Gelesene_Bits_Gesamt * BER). Consumer-SATA-Festplatten weisen eine Bitfehlerrate (BER) von 10^-14 auf (1 Sektorfehler pro 12,5 TB gelesener Daten), Enterprise-Nearline-SAS-Laufwerke liegen bei 10^-15 und unternehmenskritische Enterprise-SAS-/NVMe-U.2/U.3-Medien erreichen 10^-16 BER – dies markiert die mathematische Schwelle, ab der Dual-Paritäts-Topologien (RAID 6 / RAIDZ2) zwingend erforderlich sind.
Quantifiziert die physischen Spindel- bzw. NAND-I/O-Transaktionen, die zum Ausführen eines einzelnen zufälligen Stripe-Schreibvorgangs unter POSIX-I/O-Semantik erforderlich sind. RAID 0 verursacht 1 I/O-Operation, RAID 1/10 benötigt 2 (parallele Schreibvorgänge auf Spiegelplatten), RAID 5 erfordert 4 (2 Lese- + 2 Schreibzugriffe für Daten und Parität) und RAID 6 erfordert 6 I/O-Operationen (3 Lese- + 3 Schreibzugriffe über P+Q-Syndrome im Galois-Feld GF(2^8)), was die Pufferanforderungen für Write-Coalescing im Arbeitsspeicher definiert.
Puffer auf Kernel-Ebene, der über vdev_slop_shift=5 standardmäßig 1/32stel (3,125 %, mindestens 128 MiB) der Brutto-Zpool-Kapazität reserviert, um sicherzustellen, dass administrative Transaktionen (zfs destroy, zfs rollback) ohne POSIX-ENOSPC-Panics (Speicherplatz voll) ausgeführt werden können. Erzwingt ashift=12 (4.096-Byte-Allokationsgrenze), um eine Schreibverstärkung (Write Amplification) von über 300 % auf physischen Sektoren mit Advanced Format (512e und 4Kn) zu verhindern.
Garantiert, dass sämtliche Array-Berechnungen, Poisson-Überlebensvektoren beim Rebuild und Paritätsgeometrien ausschließlich innerhalb der clientseitigen WebAssembly-/V8-Sandbox ohne jegliche Netzwerk-Telemetrie oder serverseitige Datenübertragung ausgeführt werden. Speichertopologie-Konfigurationen, Datenträger-Geometrien und Speicherkapazitäten verbleiben im flüchtigen lokalen Arbeitsspeicher – in strikter Übereinstimmung mit Zero-Trust-Architekturen und kryptografischer Vertraulichkeit.
Überschreiten Sie bei Copy-on-Write-Speicherpools (ZFS / Btrfs) niemals eine Pool-Auslastung von 80 %. Sobald die Belegung die 80-%-Marke übersteigt, wechselt der ZFS-Speicherallokator von einem O(1)-Space-Map-First-Fit-Verfahren zu einer rechenintensiven Best-Fit-Suche über alle Metaslabs hinweg. Dies führt zu einer gravierenden Dateisystemfragmentierung, zerstört die sequenzielle Schreiblokalität und bricht die zufälligen Schreib-IOPS um bis zu 70 % ein.
Ein einzelnes ZFS-RAIDZ-Vdev liefert bei zufälligen Schreibzugriffen (Random Write IOPS) lediglich die Leistung EINER EINZELNEN Festplatte – unabhängig davon, ob das Vdev aus 4 oder 24 Laufwerken besteht. Wird ein 24-Bay-Chassis als ein einziges RAIDZ2-Vdev mit 24 Datenträgern konfiguriert, bricht der Durchsatz für VM-Datenspeicher und Datenbank-Transaktionsprotokolle drastisch ein. Um die IOPS linear zu skalieren, sollten mehrere schmalere Vdevs gestript werden (z. B. vier RAIDZ2-Vdevs mit je 6 Laufwerken) oder gespiegelte Vdevs (Äquivalent zu RAID 10) zum Einsatz kommen.
Formatieren Sie moderne 4Kn- und 512e-Advanced-Format-Festplatten sowie SSDs bei der Erstellung von ZFS-Pools immer mit ashift=12 (4.096-Byte-Sektorausrichtung via `zpool create -o ashift=12`). Die Übernahme des veralteten Standardwerts ashift=9 (512-Byte-Sektoren) zwingt native 4-KB-Sektoren dazu, über mehrere physische Schreibvorgänge aufgeteilt zu werden. Dies löst eine unvermeidbare Schreibverstärkung (Write Amplification) von über 300 % aus, mindert die I/O-Performance drastisch und beschleunigt den Verschleiß von NAND-Flash-Zellen.
Die Aufwertung eines Speicherpools von RAID 5 mit dediziertem Hot-Spare zu einem aktiven RAID-6-Array bei identischer Festplattenanzahl bietet eine exponentiell höhere Ausfallsicherheit. Ein Hot-Spare verharrt im Normalbetrieb im Leerlauf und bietet während der hochkritischen Rebuild-Phase keinerlei Redundanz. Im Gegensatz dazu gewährleistet RAID 6 durch permanente, aktive Reed-Solomon-Dual-Parität vollen Schutz und übersteht auch einen zweiten Festplattenausfall oder unlesbare Sektoren (URE) während des Wiederherstellungsprozesses.
Die Root-Reservierung sowie Partitions- und Metadaten-Overheads belegen physische Datenblöcke. Das Linux-Dateisystem ext4 reserviert standardmäßig 5 % aller Blöcke für den Root-Benutzer, um System-Deadlocks bei vollem Speicher zu verhindern; auf reinen Datenspeichermounts lässt sich dieser Anteil mit 'tune2fs -m 1 /dev/sdX' auf 1 % reduzieren. Berücksichtigen Sie zudem GPT-EFI-Partitionstabellen, LVM-Metadatenbereiche (4–8 MiB) sowie den ZFS-Slop-Space von 3,125 % ('spa_slop_shift=5'), der als Sicherheitspuffer für Copy-on-Write-Snapshots und Löschoperationen vorgehalten wird.
Ein sekundärer Lesefehler während des RAID-5-Rebuilds bei Single-Parity tritt auf, wenn auf den verbleibenden Laufwerken (insbesondere ab 8 TB) unlesbare Sektoren vorgefunden werden. Stoppen Sie umgehend alle Schreibzugriffe und erstellen Sie bitgenaue Rohdaten-Klone aller intakten Datenträger auf ein separates Medium mittels 'ddrescue -b 4096 /dev/sdX /media/recovery.img', bevor Sie Dateisystemprüfungen (fsck) ausführen oder Metadaten reinitialisieren. Um diese Schwachstelle künftig zu eliminieren, setzen Sie bei Datenträgern ab 4 TB ausnahmslos auf Dual-Parity (RAID 6 oder RAIDZ2), um sekundäre Sektorlesefehler abzufangen.
I/O-Engpässe beim Resilvering entstehen häufig durch Shingled-Magnetic-Recording-Laufwerke (SMR) mit überlastetem internen Cache oder durch Metadaten-Mangel in einem unterdimensionierten Adaptive Replacement Cache (ARC). Prüfen Sie mittels 'smartctl -i /dev/sdX', ob Ihre Datenträger Conventional Magnetic Recording (CMR) nutzen, und tauschen Sie Host-Managed oder Drive-Managed SMR-Laufwerke unverzüglich aus. Um Produktiv-Workloads zu stabilisieren, drosseln Sie die I/O-Priorität des Resilverings über 'zfs set zfs:zfs_resilver_min_time_ms=2000' und erweitern Sie den ARC-Arbeitsspeicher des Hosts, um Metadaten-Verdrängungen zu stoppen.
Die nutzbare RAID-Kapazität richtet sich nach Array-Topologie und Paritäts-Overhead: RAID 0 bietet N * Festplattenkapazität (0 % Paritätsverlust); RAID 1 liefert 1 * Festplattenkapazität (50 % Spiegelungsverlust bei 2 Laufwerken); RAID 5 bietet (N - 1) * Festplattenkapazität; RAID 6 bietet (N - 2) * Festplattenkapazität; und RAID 10 liefert (N / 2) * Festplattenkapazität. Bei ZFS-RAIDZ-Pools müssen zusätzlich 3,125 % (1/32stel) für den Pool-Slop-Space abgezogen und Dezimal-Terabyte über den Umrechnungsfaktor 0,9095 in Binär-Tebibyte konvertiert werden (1 TiB = 10^12 / 2^40 TB).
Festplattenhersteller geben Kapazitäten im Dezimalsystem an, wobei 1 Terabyte (TB) = 10^12 Bytes entspricht, während Betriebssysteme Speicherplatz binär in Tebibyte (TiB) adressieren, wobei 1 TiB = 2^40 = 1.099.511.627.776 Bytes beträgt. Diese mathematische Diskrepanz verursacht einen anfänglichen rechnerischen Kapazitätsverlust von 9,0949 % (eine 18-TB-Festplatte liefert beispielsweise nur ca. 16,37 TiB Bruttospeicher). GPT-EFI-Partitionstabellen, Dateisystem-Verwaltungsstrukturen (Inode-Tabellen, Journal-Extents) sowie ZFS-Slop-Space-Reservierungen reduzieren die tatsächlich nutzbare Nettokapazität zusätzlich.
RAID 5 bietet lediglich Ausfalltoleranz für eine einzelne Festplatte. Fällt ein Datenträger aus, müssen beim Rebuild alle verbleibenden Laufwerke vollständig ausgelesen werden, um die Parität neu zu berechnen. Standard-Consumer-SATA-Festplatten weisen eine Bitfehlerrate (URE) von 10^-14 auf (1 unlesbarer Bitfehler pro 12,5 TB gelesener Daten). Der Rebuild eines 4-Festplatten-Arrays mit 16-TB-Laufwerken erfordert das kontinuierliche Lesen von 48 TB. Nach dem Poisson-Modell P = 1 - exp(-Bits * BER) ergibt sich daraus eine statistische Ausfallwahrscheinlichkeit von über 98 %, wodurch ein einziger unlesbarer Sektor zur Zerstörung des gesamten Arrays führt.
RAID 10 verteilt Daten via Striping über gespiegelte Laufwerkspaare und hat einen Schreibstrafe-Faktor (Write Penalty) von 2, während RAID 6 eine zweifache P+Q-Reed-Solomon-Parität mit einem Schreibstrafe-Faktor von 6 berechnet. Bei transaktionsintensiven Datenbanken (MySQL, PostgreSQL, Oracle) mit hohem Anteil an zufälligen Schreibzugriffen liefert RAID 10 bis zu 300 % höhere Random-Write-IOPS und spiegelt ausgefallene Laufwerke ohne rechenintensive Paritätsneuberechnung wieder ein. RAID 6 ist dagegen für sequenzielle Lese-Workloads, Backup-Repositories und kosteneffiziente Massen-Archivspeicher optimiert.
ZFS RAIDZ2 ersetzt starre Stripe-Größen und Hardware-RAID-Controller mit batteriegepuffertem Cache (BBU) durch dynamische Stripe-Breiten und kryptografische 128-Bit-Prüfsummen (Fletcher4/SHA-256), was das gefürchtete RAID-5/6-Write-Hole vollständig eliminiert. Bei der Wiederherstellung (Resilvering) liest und berechnet ZFS ausschließlich tatsächlich belegte Metadaten und aktive Datenblöcke statt unbeschriebene Sektoren zu scannen, und repariert unbemerkt auftretende Datenkorruption (Silent Data Corruption / Bitrot) automatisch bei regulären Scrub-Vorgängen.
Die 80-%-Regel bei ZFS besagt, dass Speicherpools zu maximal 80 % ausgelastet werden sollten, da der Speicherallokator andernfalls von einem schnellen O(1)-Space-Map-First-Fit-Verfahren zu einer latenzintensiven Best-Fit-Suche wechselt, die massive Fragmentierung und IOPS-Einbrüche verursacht. Ergänzend erzwingt OpenZFS über 'spa_slop_shift=5' eine Slop-Space-Reservierung von standardmäßig 3,125 % der Brutto-Poolkapazität (mindestens 128 MiB). Dies stellt sicher, dass administrative Befehle wie das Löschen von Snapshots oder Dateisystemen sowie Metadaten-Schreibvorgänge selbst bei 100 % Benutzerquoten-Belegung fehlerfrei ausgeführt werden können.
Die Rebuild-Dauer hängt von der Bruttokapazität der Laufwerke, der kontinuierlichen sequenziellen Schreibraten-Bandbreite, dem Controller- und Backplane-Durchsatz sowie der gleichzeitigen I/O-Last durch Anwendungen ab. Ohne Hintergrundlast benötigt eine Enterprise-Festplatte mit 18 TB und 7.200 U/min bei kontinuierlichen 200 MB/s etwa 25 bis 30 Stunden für den Rebuild. Unter 50 % Produktivlast oder beim Einsatz von Shingled-Magnetic-Recording-Laufwerken (SMR) verlängert sich der Rebuild-Prozess auf 5 bis 9 Tage, was das zeitliche Risikofenster für einen folgenschweren Zweitausfall drastisch vergrößert.
Exakte A/B-Test-Stichprobengröße, statistische Power und Testdauer berechnen. Mit MDE-Rückrechnung, stetigen Metriken, Bonferroni-Korrektur und SRM-Prüfung.
PX in REM und REM in PX sofort mit flexibler Basis-Schriftgröße umrechnen. Erzeugt saubere CSS clamp() Fluid-Typografie, Tailwind-Klassen und Umrechnungstabellen.
HTTP-Statuscodes prüfen, Weiterleitungsketten testen und Response-Header analysieren. Diagnose von 1xx- bis 5xx-Fehlercodes nach RFC 9110, SEO-Auswirkungen und Behebungen.
Reguläre Ausdrücke in Echtzeit testen, debuggen und optimieren. Treffer, Erfassungsgruppen, Token-Erklärungen und Ersetzungsmuster direkt im Browser prüfen.
Berechnen Sie IPv4-Subnetzmasken, CIDR-Bereiche, nutzbare Host-IPs und Broadcast-Adressen. Mit bitweiser Binärinspektion, VLSM-Planung und Cloud-VPC-Regeln.
Berechnen Sie binäre Addition und Subtraktion in Echtzeit mit schrittweiser Übertragslogik, vorzeichenbehaftetem Zweierkomplement, Bit-Gattern und Hex-Konvertierung.