A/B-Test Stichprobenrechner & Power
Exakte A/B-Test-Stichprobengröße, statistische Power und Testdauer berechnen. Mit MDE-Rückrechnung, stetigen Metriken, Bonferroni-Korrektur und SRM-Prüfung.
Regime:
Exakte A/B-Test-Stichprobengröße, statistische Power und Testdauer berechnen. Mit MDE-Rückrechnung, stetigen Metriken, Bonferroni-Korrektur und SRM-Prüfung.
Berechnen Sie exakte Stichprobengrößen, statistische Power und Testdauer für A/B-Tests. Mit MDE-Rückrechnung, kontinuierlichen Metriken, Bonferroni-Korrektur und SRM-Prüfung.
Historischer binomialer Anteil der Kontrollgruppe. Die asymptotische Normalapproximation setzt das Cochran-Kriterium n·p₁ ≥ 5 und n(1 - p₁) ≥ 5 voraus. Niedrigere Basisraten erhöhen die erforderliche Fallzahl umgekehrt proportional zur Bernoulli-Varianz p₁(1 - p₁).
Zielschwellenwert der statistischen Sensitivität. Folgt der invers-quadratischen Skalierung n ∝ 1/Δ²: Eine Halbierung des relativen MDE vervierfacht die erforderliche Stichprobengröße. Client-seitig berechnet über rationale Approximationen der inversen Normalverteilungs-CDF (Probit-Funktion) innerhalb der IEEE-754-Maschinengenauigkeit (2,22e-16).
Maximal tolerierte Wahrscheinlichkeit für falsch-positive Befunde (Ablehnung der wahren Nullhypothese). Der zweiseitige symmetrische Standard-Schwellenwert teilt α auf beide Verteilungsränder auf (Z_{α/2} = 1,95996 für α = 0,05). Multi-Arm-Experimente erfordern eine Bonferroni-Korrektur α_adj = α / (K - 1) zur Begrenzung der familienspezifischen Fehlerrate (FWER).
Komplement der Fehlerquote 2. Art (β). Definiert die Wahrscheinlichkeit, die Nullhypothese bei Vorliegen eines echten Effekts korrekt abzulehnen. Eine Erhöhung der Teststärke von 0,80 (Z_β = 0,8416) auf 0,90 (Z_β = 1,2816) vergrößert die erforderliche Stichprobe um ca. 34,2 % aufgrund des nichtlinearen Z-Score-Versatzes.
Gesamtzahl der experimentellen Varianten einschließlich Kontrollgruppe. Bei Multi-Arm-Tests (A/B/n) führen unkorrigierte Vergleiche zu kumulativer Alphainflation: α_kum = 1 - (1 - α)^(K - 1). Client-seitig kontrolliert über O(K)-Bonferroni- oder Dunnett-Multiplizitätskorrekturen.
Selbst wenn Plattformen mit hohem Traffic innerhalb von 48 Stunden nominale Signifikanz (p < 0,05) erreichen, macht ein vorzeitiger Abbruch statistische Schlüsse ungültig: Temporale Autokorrelation und Wochentagseffekte (Kaufmuster unter der Woche vs. am Wochenende) verzerren das Ergebnis. Führen Sie mindestens zwei vollständige 7-Tage-Zyklen durch, um die wöchentliche Varianz abzubilden und Neuheitseffekte (Novelty Effects) zu neutralisieren.
Wiederholtes Prüfen von Dashboard-p-Werten bei auflaufenden Daten („Peeking“) treibt den empirischen Fehler 1. Art vom nominalen Niveau von 5 % auf über 30 % bei Testende. Ist ein vorzeitiges Beenden in Echtzeit erforderlich, implementieren Sie Lan-DeMets-Alpha-Spending-Funktionen mit O’Brien-Fleming-Grenzwerten oder asymmetrische sequentielle Wahrscheinlichkeitsquotiententests (mSPRT).
Führen Sie vor der Konversionsauswertung stets einen Pearson-Chi-Quadrat-Anpassungstest (χ² = Σ(O - E)² / E) in O(K) auf die Zuweisungszahlen durch. Ein SRM-p-Wert unter 0,001 signalisiert einen strukturellen Tracking-Bias – etwa durch asynchrone CDN-Worker-Abbrüche, Redirect-Cache-Anomalien oder Bot-Filter –, der jeden nachgelagerten Hypothesentest statistisch entwertet.
Kommunizieren Sie den minimal erkennbaren Effekt (MDE) grundsätzlich relativ (z. B. +8,0 % relativer Lift bei 4,0 % Basisrate entspricht 4,32 %) statt in absoluten Prozentpunkten (+0,32 Prozentpunkte). Relative Kennzahlen skalieren konsistent über unterschiedliche Kohortengrößen, integrieren sich nahtlos in Finanzmodelle und verhindern Verwechslungen zwischen Margenpunkten und prozentualem Zuwachs.
Optimieren Sie auf eine vorgelagerte Mikro-Konversion mit höherer Basisfrequenz (z. B. „In den Warenkorb“ bei 12 % statt Bestellabschluss bei 1,8 %), lockern Sie den MDE von Minimalzielen (z. B. 2 % relativ) auf geschäftsrelevante Schwellen (7 %–10 %) oder setzen Sie die Power auf 80 % statt 95 % an.
Entscheidungsfindung sofort stoppen und keinen Sieger küren. Segmentieren Sie die Zuweisungsraten nach Browser-Engine, Geräteklasse, geografischem CDN-Knotenpunkt (POP) und Weiterleitungslatenz. SRM entsteht häufig durch clientseitige Skript-Timeouts, aggressives Cookie-Dropping durch WebKit Intelligent Tracking Prevention (ITP) oder Bot-Filter, die Varianten-URLs unverhältnismäßig verwerfen.
Kontinuierliche E-Commerce-Daten weisen eine extreme rechtsschiefe Pareto-Verteilung und hohe Varianz auf (σ² >> μ). Dämpfen Sie Heavy Tails durch Winsorisieren der Bestellwerte am 99. Perzentil, wenden Sie eine logarithmische Transformation an (log(1 + x)) oder wechseln Sie vom Welch-t-Test zu nichtparametrischen Verfahren wie dem Mann-Whitney-U-Test oder empirischem Bootstrapping.
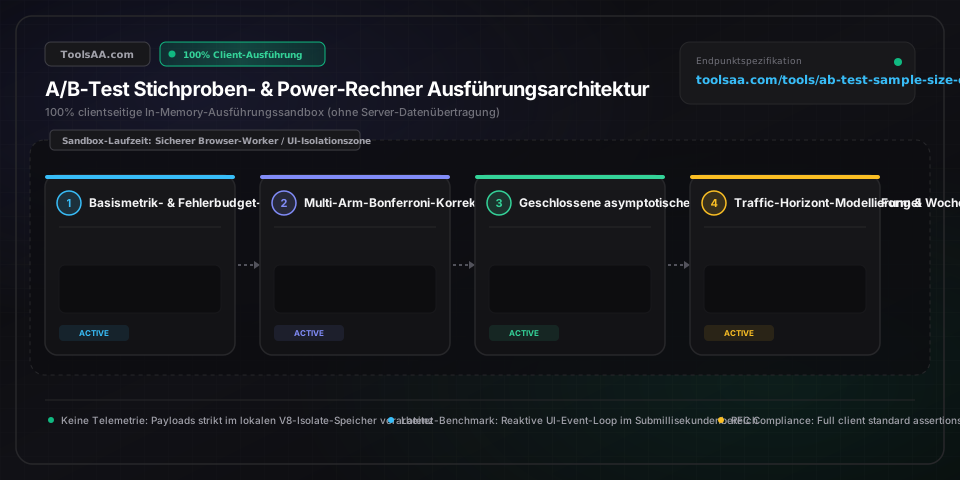
Die Stichprobengröße pro Variante wird über die Standardformel für zwei Anteile berechnet: n = [Z_{α/2}√(2p̄(1 - p̄)) + Z_β√(p₁(1 - p₁) + p₂(1 - p₂))]² / (p₂ - p₁)², wobei p̄ = (p₁ + p₂)/2, Z_{α/2} der kritische Z-Wert für das Signifikanzniveau (1,96 bei 95 % Konfidenz) und Z_β der kritische Z-Wert für die Teststärke ist (0,8416 bei 80 % Power). Dieses Tool führt clientseitige rationale Approximationen der inversen Normalverteilungs-CDF mit O(1)-Zeitkomplexität und ohne jegliche Server-Datenübertragung aus.
Eine statistische Power von 80 % (β = 0,20) stellt den optimalen ökonomischen Kompromiss zwischen dem Risiko falsch-negativer Ergebnisse und den Traffic-Kosten dar. Eine Anhebung der Power von 80 % auf 90 % (Anstieg von Z_β von 0,84 auf 1,28) erfordert ca. 34 % mehr Stichprobenvolumen; 95 % Power verlangen bereits rund 74 % mehr Traffic. Bei den meisten digitalen Produkten führen überlange Testlaufzeiten zu Opportunitätskosten, die das verbleibende 20-%-Risiko für einen Fehler 2. Art bei weitem übersteigen.
Der relative MDE gibt den erwarteten Lift als prozentuale Veränderung bezogen auf die Basisrate an: Bei 5,0 % Basisrate zielt ein relativer MDE von 10 % auf eine Konversionsrate von 5,5 % (Δ = 0,005). Der absolute MDE beziffert die Veränderung direkt in Prozentpunkten: Ein absoluter MDE von 2,0 % auf 5,0 % Basisrate erfordert 7,0 % (Δ = 0,02). Der relative MDE ist der Standard moderner Experimentier-Plattformen, da geschäftliche Wachstumsziele und stochastische Varianzen sich natürlicherweise an relativen Verschiebungen orientieren.
Für Produktiv-A/B-Tests ist zwingend ein zweiseitiger Hypothesentest erforderlich, da Testvarianten das Nutzererlebnis verschlechtern und Konversionen senken können. Der zweiseitige Test teilt das Fehlerrisiko α auf beide Verteilungsränder auf (α/2 = 0,025 je Seite) und schützt mathematisch davor, fälschlicherweise signifikant negative Effekte als Gewinner zu deklarieren. Einseitige Tests sollten strikt auf Nicht-Unterlegenheitsprüfungen (Non-Inferiority Trials) oder Infrastruktur-Migrationen beschränkt bleiben, bei denen ausschließlich Performance-Einbußen ausgeschlossen werden müssen.
Ein Sample Ratio Mismatch (SRM) liegt vor, wenn die beobachtete Traffic-Verteilung statistisch signifikant vom geplanten Randomisierungsverhältnis abweicht (z. B. geplantes 50/50-Split vs. beobachtetes 48,8/51,2). Er wird über einen Pearson-Chi-Quadrat-Anpassungstest berechnet: χ² = Σ(O_i - E_i)² / E_i mit K - 1 Freiheitsgraden. Ein Schwellenwert von p < 0,001 weist auf gravierende technische Störungen hin (z. B. Edge-Caching-Fehler, Browser-Abstürze oder asynchrone Redirect-Latenzen), die jegliche Kausalschlüsse zunichtemachen.
Tests müssen unabhängig vom frühzeitigen Erreichen der Stichprobengröße mindestens 7 oder 14 volle 24-Stunden-Zyklen durchlaufen, da das Nutzerverhalten starker unterwöchiger Periodizität unterliegt (unterschiedliches Kaufverhalten an Wochentagen vs. Wochenenden). Ein vorzeitiger Abbruch provoziert Scheinsignifikanzen durch zeitliche Autokorrelation, das Simpson-Paradoxon über Wochentagskohorten hinweg und ignoriert mehrschrittige Konversionslatenzen (Time-to-Convert).
PX in REM und REM in PX sofort mit flexibler Basis-Schriftgröße umrechnen. Erzeugt saubere CSS clamp() Fluid-Typografie, Tailwind-Klassen und Umrechnungstabellen.
HTTP-Statuscodes prüfen, Weiterleitungsketten testen und Response-Header analysieren. Diagnose von 1xx- bis 5xx-Fehlercodes nach RFC 9110, SEO-Auswirkungen und Behebungen.
Reguläre Ausdrücke in Echtzeit testen, debuggen und optimieren. Treffer, Erfassungsgruppen, Token-Erklärungen und Ersetzungsmuster direkt im Browser prüfen.
Berechnen Sie IPv4-Subnetzmasken, CIDR-Bereiche, nutzbare Host-IPs und Broadcast-Adressen. Mit bitweiser Binärinspektion, VLSM-Planung und Cloud-VPC-Regeln.
Berechnen Sie binäre Addition und Subtraktion in Echtzeit mit schrittweiser Übertragslogik, vorzeichenbehaftetem Zweierkomplement, Bit-Gattern und Hex-Konvertierung.
Testen und validieren Sie robots.txt-Dateien nach RFC 9309. Prüfen Sie User-Agent-Crawl-Rechte, debuggen Sie Disallow-Pfade und analysieren Sie Sitemaps direkt im Browser.