Calculadora de Shards & Cluster ES

Calculadora de Shards & Cluster ES

Calcule a quantidade de shards e o dimensionamento de clusters Elasticsearch. Estime armazenamento primário e de réplicas, memória RAM dos nós, limites da heap da JVM e margens de segurança de watermark de disco.

Carregar Exemplo
Armazenamento Primário9.92 TB
Disco Total24.80 TB
Shards Ativos398
Nós de Dados Recomendados7 Nodes
Quórum de Nós Master3 Dedicated
Saúde da Heap por Shard9%
Arquitetura de Carga de Trabalho

Time-series telemetry, container logs, and system metrics with ILM rollover and 1 replica.

250.0 GB / day
30 Days
Sobrecarga de Indexação:+15%
Peak Burst:+15%
Margem de Watermark:20%
Especificações de Hardware dos Nós
64 GB RAM
Proporção de Heap da JVM:31 GB Heap / 33 GB OS Cache

Compressed OOPs Enabled (< 31 GB): Mantenha a heap abaixo de 32 GB para habilitar ponteiros compactados (Compressed OOPs).

4.0 TB (4,000 GB)
20 shards / GB
10 (Conservative)20 (Official Default)25 (Aggressive)
Dimensionamento Reverso de Capacidade

Cálculo reverso de capacidade para estimar ingestão suportada pelo cluster.

Max Safe Daily Ingestion278.3 GB / dayBottleneck: Disk Space
Max Shards Allowed3,7201,860 Primaries
Max Retention (Current Load)33 Days@ 250 GB/d
Cluster DimensionCalculated Metric
Armazenamento Primário9.919 TB (9,918.8 GB)
Armazenamento Replicado19.838 TB
Disco Total com Margem de Segurança24.797 TB
Shards Recomendados199 Primaries (398 Active)
Nós de Dados Recomendados7 Nodes
Quórum de Nós Master3 Dedicated Master Nodes
Coordinating Ingest NodesShared with Data
Topologia do Cluster (SVG)7 Data + 3 Master
DEDICATED MASTER QUORUM (Split-Brain Immune)master-01master-02master-03data-01SHARDSPR~57 shards9% densityHEAP 31GDISK 4.0Tdata-02SHARDSPR~57 shards9% densityHEAP 31GDISK 4.0Tdata-03SHARDSPR~57 shards9% densityHEAP 31GDISK 4.0Tdata-04SHARDSPR~57 shards9% densityHEAP 31GDISK 4.0Tdata-05SHARDSPR~57 shards9% densityHEAP 31GDISK 4.0Tdata-06SHARDSPR~57 shards9% densityHEAP 31GDISK 4.0Tdata-07SHARDSPR~57 shards9% densityHEAP 31GDISK 4.0T
CLUSTER HEALTH: OPTIMAL
Nodes: 7Shards: 398Disk: 24.80 TB
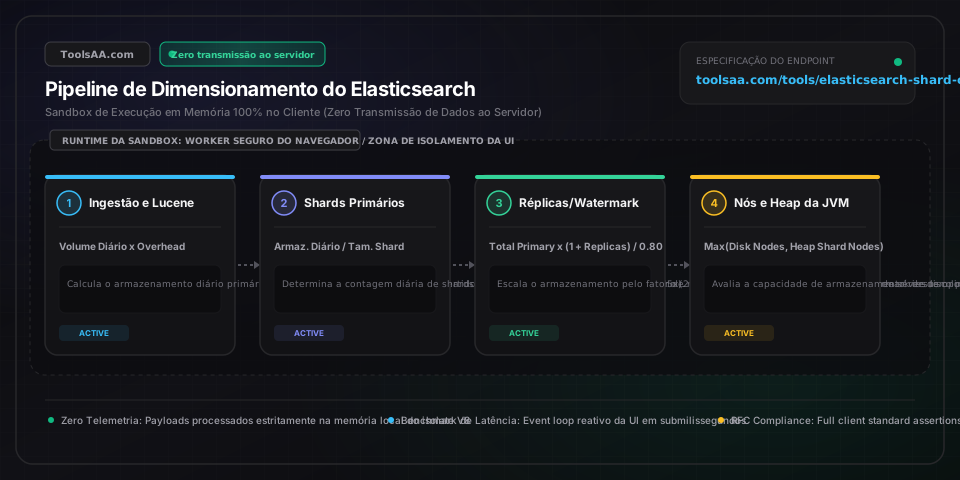
Referência técnica e guia de arquitetura

Guia de Shards & Cluster Elasticsearch — Guia de referência

Calcule a quantidade de shards e o dimensionamento de cluster no Elasticsearch. Estime armazenamento primário e de réplica, RAM dos nós, limites de heap da JVM e margens seguras de watermark de disco.

Guia de Shards & Cluster Elasticsearch — Guia de referência — Arquitetura em memória do lado do cliente e fluxo de dados

Parâmetros-chave e controles

Volume Diário de IngestãoGigabytes por dia (GB/dia)

Volume bruto de documentos não compactados indexados no Elasticsearch por ciclo de 24 horas antes da expansão do Lucene.

Padrão: 100 GB/dia
Tamanho Alvo do Shard PrimárioGigabytes por shard (GB)

Padrão de referência ideal: 10 GB a 30 GB para cargas de trabalho de busca; 30 GB a 50 GB para análise de logs e métricas temporais (time-series). Ultrapassar 50 GB gera riscos de recuperação demorada de shards e timeouts de rebalanceamento.

Padrão: 50 GB
Contagem de Réplicas (number_of_replicas)Número inteiro de réplicas

Número de cópias redundantes por shard primário. O valor 1 garante alta disponibilidade contra falha de nó único e dobra a capacidade de leitura; 2 réplicas protegem contra falhas simultâneas em dois nós.

Padrão: 1
Alocação de Heap da JVMGigabytes de RAM (GB)

A regra padrão dos 50% aloca metade da RAM física do nó ao heap da JVM e reserva os outros 50% para o cache de sistema de arquivos do SO (Lucene mmapfs). Nunca deve ultrapassar 31 GB para preservar o suporte a ponteiros compactados de objetos ordinários (Compressed OOPs).

Padrão: 31 GB
Proporção Shard por HeapShards por GB de heap da JVM

O teto arquitetural oficial da Elastic é de 20 shards por 1 GB de heap da JVM (ex.: um heap de 30 GB suporta até 600 shards). Em produção, o benchmark conservador recomendado é de 10 a 15 shards/GB para evitar o esgotamento do heap com metadados de segmentos.

Padrão: 20 shards/GB
Margem de Segurança do Watermark de DiscoMargem percentual de folga (%)

Margem de disco não alocada que garante que a utilização do nó permaneça com segurança abaixo do low watermark de 85% (que bloqueia a alocação de novos shards) e do high watermark de 90% (que aciona a realocação ativa de shards).

Padrão: 20%

Dicas profissionais e melhores práticas

O Limite Crítico de 31 GB para Compressed OOPs

Nunca configure a alocação de heap no ES_JAVA_OPTS para 32 GB ou mais. Em aproximadamente 31,5 GB ou acima, a JVM deixa de utilizar ponteiros compactados de 32 bits (Compressed OOPs) e passa a usar ponteiros não compactados de 64 bits. Isso consome imediatamente cerca de 40% a mais de memória para referenciar os mesmos objetos, fazendo com que um heap de 32 GB ofereça substancialmente menos memória útil do que um heap de 31 GB.

Rollover API vs. Oversharding de Índices Diários

Evite padrões rígidos de índices baseados em data como logstash-AAAA.MM.DD com contagem estática de shards. Dias de baixo tráfego criam shards minúsculos de 100 MB, enquanto picos geram shards colossais de 80 GB. Utilize o Index Lifecycle Management (ILM) com a Rollover API configurada com 'max_primary_shard_size: 50gb' ou 'max_age: 30d' para assegurar tamanhos uniformes e eliminar o oversharding.

Regra dos 50% para Cache de Segmentos Lucene

Nunca aloque mais de 50% da RAM total do sistema para o heap da JVM do Elasticsearch. O Lucene depende intensamente do page cache do sistema operacional Linux para manter arquivos de segmento de índice, índices invertidos e doc_values na memória. Privar o cache do SO provoca alto I/O de leitura em disco, disparando a latência de consultas e as pausas de coleta de lixo (GC).

Fórmula de Quórum para Master Dedicado

Para clusters com 6 ou mais nós ou cargas de trabalho críticas para o negócio, utilize exatamente 3 nós dedicados elegíveis a master (configurados com node.roles: [master]). Isso atende à fórmula de quórum (N / 2) + 1 = 2 votos para prevenir partições de split-brain, sem desperdiçar recursos caros de armazenamento ou processamento em funções de master.

Armadilhas comuns e solução de problemas

⚠️Cluster Fica Vermelho ou Amarelo com Shards UNASSIGNED

Execute GET _cluster/allocation/explain. As duas causas mais frequentes são: (1) O uso de disco em um data node ultrapassou o low watermark de 85%, impedindo o Elasticsearch de alocar shards de réplica; (2) O valor de number_of_replicas foi definido igual ou superior ao número total de data nodes. Reduza a quantidade de réplicas ou expanda o armazenamento.

⚠️Cluster Bloqueado em Modo Somente Leitura no Flood Stage de 95%

Quando qualquer data node atinge o watermark de flood stage de 95%, o Elasticsearch impõe automaticamente cluster.blocks.read_only_allow_delete: true em todos os índices. Exclua índices antigos ou expanda a capacidade de disco e, em seguida, execute PUT */_settings com {'index.blocks.read_only_allow_delete': null} para restaurar as operações de escrita.

⚠️CircuitBreakingException [parent] Data Too Large na JVM

Esse erro ocorre quando o rastreamento de memória para circuitos pai ultrapassa 95% do heap. É provocado por alta contagem de segmentos decorrente de oversharding, acúmulo de fielddata não liberado em campos textuais ou buckets massivos de agregação. Consolide índices pequenos executando _forcemerge?max_num_segments=1 em índices somente leitura e reduza a contagem total de shards ativos.

Perguntas frequentes (FAQ)

Como calcular o tamanho do shard no Elasticsearch?▼

O tamanho do shard primário é igual a (Volume Diário de Ingestão em GB * (1 + Multiplicador de Overhead de Indexação)) dividido pelo número de shards primários. Em produção, meça a ocupação real de disco via GET _cat/shards?v&h=index,shard,prirep,store para analisar a pegada física de armazenamento, incluindo doc_values e metadados de segmentos.

Qual é o tamanho máximo recomendado para um shard no Elasticsearch?▼

A recomendação máxima oficial é de 50 GB por shard para logs temporais (time-series), métricas e eventos de segurança, e de 20 GB a 30 GB para catálogos de busca de baixa latência. Shards que ultrapassam 65 GB sofrem com sobrecarga severa de fusão de segmentos Lucene (segment merge), rebalanceamento demorado do cluster e restaurações lentas de snapshots.

Quantos shards devo manter por GB de heap?▼

Mantenha o teto rigoroso de no máximo 20 shards por 1 GB de heap da JVM configurado. Um nó com o limite padrão de 30 GB de heap suporta com segurança até 600 shards no total (somando shards primários e réplicas). Operar acima de 20 shards/GB acarreta riscos de instabilidade generalizada no cluster e falhas por esgotamento de memória (OOM) causadas pela sobrecarga de metadados de segmentos.

Qual é a diferença entre shards primários e shards de réplica?▼

Shards primários são as partições originais que armazenam os documentos indexados e processam inicialmente as operações de escrita. Shards de réplica são cópias síncronas exatas dos shards primários que fornecem tolerância a falhas de hardware (alta disponibilidade) e aumentam a vazão de consultas de leitura entre múltiplos nós. Uma réplica nunca reside no mesmo nó físico que seu respectivo shard primário.

Por que meu cluster Elasticsearch está com status vermelho por shards não atribuídos?▼

O status vermelho indica que um ou mais shards primários não puderam ser alocados em nenhum nó, provocando indisponibilidade imediata de dados. Isso ocorre frequentemente quando o disco ultrapassa o watermark de flood stage de 95%, quando um host com shards primários não replicados cai ou quando há arquivos de segmento Lucene corrompidos no disco. Execute GET _cluster/allocation/explain para diagnosticar a causa exata do bloqueio.

Ferramentas e utilitários relacionados

Todas as ferramentas →
Calculadora de Pool de Conexões & DBDesenvolvimento

Calculadora de pool de conexões e planejamento de capacidade para bancos de dados em produção. Calcule com precisão o dimensionamento ideal do pool por pod Kubernetes, evite thread thrashing, estime tempos de espera em fila e proteja a memória do banco contra falhas de OOM utilizando a Lei de Little, fórmulas de saturação do HikariCP e taxas de multiplexação de transações do PgBouncer.

Abrir ferramenta→
Calculadora de Rate Limit API & RPSDesenvolvimento

High-performance processing executed entirely in browser memory.

Abrir ferramenta→
Código de Cores de Resistores & CálculoDesenvolvimento

Calcule códigos de cores de resistores de 3, 4, 5 e 6 faixas com decodificação bidirecional instantânea, margens de tolerância, deriva por coeficiente de temperatura, síntese reversa da série E e equivalências SMD segundo a IEC 60062.

Abrir ferramenta→
Calculadora RabbitMQ (RAM & Throughput)Desenvolvimento

Calculadora interativa de memória e throughput para filas RabbitMQ com análise e visualização em tempo real no navegador.

Abrir ferramenta→
Calculadora PostgreSQL & Config PGTuneDesenvolvimento

Calcule os parâmetros de memória do PostgreSQL e gere configurações postgresql.conf via PGTune. Otimize shared_buffers, work_mem, effective_cache_size e max_connections.

Abrir ferramenta→
Calculadora de Capacidade RAID & ZFSDesenvolvimento

Calcule a capacidade de armazenamento útil em TB decimais e TiB binários para arranjos RAID 0, 1, 5, 6, 10, 50, 60 e ZFS RAIDZ1/Z2/Z3 com overhead de paridade, risco de falha por URE no rebuild, tempo de reconstrução e visualizador de baias.

Abrir ferramenta→