Calculadora RabbitMQ (RAM & Throughput)

Calculadora RabbitMQ (RAM & Throughput)

Calculadora interativa de memória e throughput para filas RabbitMQ com análise e visualização em tempo real no navegador.

Cenários Pré-configurados

Configuração do Cluster RabbitMQ

1nós15
1réplicas7

Armazenamento Total de Mensagens

Profundidade do Backlog150,000 mensagens
mensagens
bytes
bytes

Taxas de Tráfego & Consumidores

Taxa de publicação2,500
Taxa de consumo2,200
ms

Dimensionamento de Recursos por Nó

RAM por nó16 GB
High Watermark de memória40%
Taxa de paginação50%
Conexões Ativas100 conexões

Marca d'Água de RAM (Watermark)

Operação segura
0 MBMarcador de paginação: 3,277 MB (20%)Marcador de Alarme de Memória: 6,554 MB (40%)Limite Total do Nó: 16,384 MB
RAM total do líder630.8 MB
Utilização do Watermark9.6%
Margem livre restante5,922.8 MB
RAM total do cluster1.54 GB

Diagrama do Pipeline de Mensagens

Motor gráfico SVG
Publicadores2,500 msg/s6.26 MB/sBuffers de Socket TCP100 conexões15.6 MB Erlang BEAM & Raft631 MBQUORUM (3 nós)I/O de disco: 21.58 MB/sRAM Residente149,000 mensagens447.4 MB PayloadsSegmentos em Disco0 mensagens0.36 GB Em discoConsumidores20 workersPrefetch: 1,000 mensagensVazão líquida+300 msg/sIndicador da linha do tempoAlarme em 1h 37m

Detalhamento de Memória RAM630.8 MB

Payload residente em RAM:447.4 MB
Buffers de prefetch:2.7 MB
Heap da BEAM:165 MB
Buffers de socket:15.6 MB
Métrica PrincipalOperação segura
Eficiência / CapacidadePrivacidade 100% no Cliente
Throughput Líquido631 MB (10%)
Referência técnica e guia de arquitetura

Calculadora RabbitMQ (Memória & Vazão) — Guia de referência

Calculadora interativa de dimensionamento de memória e vazão para filas RabbitMQ com análise em tempo real e visualização local no cliente.

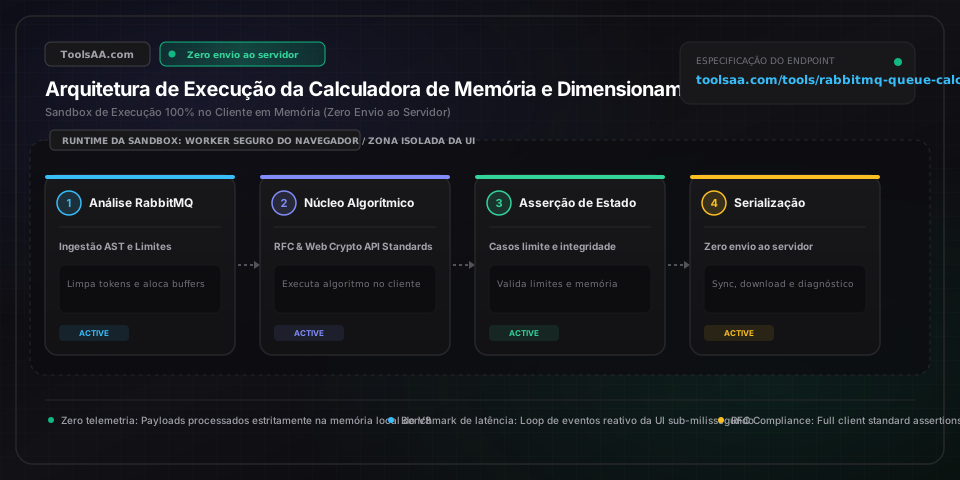
Calculadora RabbitMQ (Memória & Vazão) — Guia de referência — Arquitetura em memória do lado do cliente e fluxo de dados

Parâmetros-chave e controles

tipoArquiteturaFilaEnum ('quorum' | 'classic_v2' | 'stream' | 'classic_v1')

Especifica o mecanismo de consenso e o subsistema de armazenamento da BEAM do Erlang. As filas Quorum implementam consenso Raft, exigindo cerca de 30% a 40% de RAM adicional por entrada da máquina de estados em trânsito (~384 B vs. ~32 B na CQv2). A Classic Queue v2 segmenta mensagens em blocos (slabs) imutáveis de 32 MB em disco, reduzindo a memória de índice paginada em 77% em comparação com os dicionários ETS na heap do Erlang da Classic Queue v1.

Padrão: quorum
bytesPayloadMedioMensagemInteiro (Bytes)

Comprimento do corpo da mensagem AMQP 0-9-1 não compactada em bytes. Payloads <= 64 bytes são alocados diretamente na heap local do processo Erlang e sujeitos à coleta de lixo por cópia (copying GC). Payloads > 64 bytes utilizam o alocador global de binários com contagem de referências do Erlang (refc binaries), permitindo compartilhamento de memória com cópia zero (zero-copy) entre múltiplos assinantes em exchanges fanout AMQP.

Padrão: 4096
contagemPrefetchQoSConsumidorInteiro (Mensagens / Consumidor)

Limite configurado de prefetch basic.qos do AMQP por canal de consumidor. Mensagens entregues sob prefetch ficam retidas em RAM não paginável do Erlang até serem confirmadas (acknowledged). Definir prefetch como 0 (ilimitado) provoca inchaço severo de RAM durante picos de acúmulo (backlog). O intervalo de referência ideal (gold benchmark) para vazão contínua de rede sem saturação de memória é de 50 a 200.

Padrão: 100
contagemConsumidoresAtivosInteiro (Canais AMQP Ativos)

Total de canais de processamento concorrentes mantendo tags basic.consume ativas. Multiplicado diretamente por contagemPrefetchQoSConsumidor e bytesPayloadMedioMensagem para calcular a alocação total de memória em trânsito não paginável: M_inflight = Consumidores * Prefetch * (BytesPayload + 120 B de metadados de quadro BEAM).

Padrão: 20
taxaVazaoPublicacaoAlvoFloat (Mensagens / Segundo)

Vazão sustentada de publicação de entrada (ingress). Avaliada em relação ao vm_memory_high_watermark (padrão de 0,40 da RAM do host) e ao disk_free_limit. Quando a taxa de publicação supera a taxa de confirmação dos consumidores, a velocidade líquida de acúmulo do backlog determina o tempo até o estouro do limite: t_breach = (M_watermark - M_current) / (R_backlog * OverheadPorMsg).

Padrão: 1500

Dicas profissionais e melhores práticas

Evite Vazamentos de Memória Binária Refc no Erlang com Subfatiamento de Mensagens

Mensagens AMQP com mais de 64 bytes residem na heap global de binários com contagem de referências do Erlang (refc binaries). Se um consumidor ou plugin do broker extrair uma fatia mínima de cabeçalho de um payload de 1 MB, o runtime da BEAM do Erlang reterá toda a alocação binária de 1 MB na RAM física até que esse sub-binário seja coletado pelo garbage collector. Em pipelines de roteamento de alta vazão, force a cópia binária ou recodificação de string para liberar a referência refc subjacente e eliminar o crescimento fantasma de memória.

Mitigue a Latência de Fsync do WAL Raft em Filas Quorum de Alta Vazão

As filas Quorum descarregam os logs de gravação antecipada (WAL) do Raft em disco por meio de operações fsync(). Em armazenamentos em bloco na nuvem com latência de gravação volátil (como exaustão de burst no AWS EBS gp2), o estrangulamento de IOPS pode limitar a vazão da fila a 200 msg/s, independentemente dos núcleos de CPU disponíveis. Ajuste raft.wal_max_batch_size para 4096 e mantenha o diretório /var/lib/rabbitmq em SSDs NVMe de alto desempenho que forneçam >= 10.000 IOPS de gravação sustentadas para escalar além de 30.000 msg/s por fila Quorum.

Desacople Handshakes de Conexão da Multiplexação de Canais AMQP

Cada conexão TCP ativa consome memória de socket do kernel (rmem/wmem alocando de 64 KB a 256 KB) além do overhead do processo leitor do Erlang (~40 KB). Multiplexar centenas de canais ativos em uma única conexão causa bloqueio de início de fila (head-of-line blocking) nos leitores de socket de thread única do Erlang. Mantenha um pool balanceado de 10 a 50 canais ativos por conexão TCP para saturar os agendadores (schedulers) multi-core da BEAM sem esgotar os descritores de arquivos de socket.

Garantia O(1) de Modelagem de Memória sem Exfiltração no Cliente

Todas as projeções de dimensionamento de fila e esvaziamento de backlog executam integralmente no lado do cliente, utilizando equações algébricas determinísticas de forma fechada O(1) e Web Workers em memória. As métricas de topologia do cluster, estatísticas de profundidade de fila e parâmetros de tamanho de payload nunca saem do sandbox local do seu navegador nem atingem endpoints de rede externos, garantindo estrita confidencialidade para auditorias de infraestrutura corporativa.

Armadilhas comuns e solução de problemas

⚠️Conexões de publicadores bloqueadas indefinidamente com basic.publish do AMQP travando sem erros

Execute 'rabbitmq-diagnostics memory_breakdown' para verificar se o vm_memory_high_watermark (padrão 0,40) foi acionado. O RabbitMQ implementa contrapressão (backpressure) interrompendo a leitura dos sockets TCP dos publicadores, preenchendo o buffer de socket do cliente e travando a thread publicadora sem emitir exceções do protocolo AMQP. Não aumente o limite acima de 0,50. Em vez disso, reduza o prefetch basic.qos dos consumidores para <= 100 para liberar mensagens não confirmadas, dimensione consumidores horizontalmente ou faça expurgo em dead-letter queues inativas.

⚠️Processo BEAM do Erlang sofre crash inesperado com 100% de uso de RAM apesar do baixo acúmulo de mensagens

Identifique vazamento de mensagens não confirmadas (unacked) e esgotamento da tabela de átomos. Execute 'rabbitmqctl list_queues name messages_unacknowledged consumers'. Se messages_unacknowledged estiver elevado, os consumidores estão perdendo confirmações, retendo mensagens permanentemente na RAM. Além disso, inspecione cabeçalhos customizados de roteamento AMQP para garantir que publicadores não estejam gerando dinamicamente cabeçalhos com strings únicas convertidas em átomos Erlang, pois a tabela de átomos da BEAM tem um limite fixo de 1.048.576 entradas e derruba o broker imediatamente ao ser esgotada.

⚠️Memória da Quorum Queue sobe continuamente mesmo com mensagens sendo paginadas para o disco

Verifique a configuração de cache de janela deslizante da fila Quorum 'quorum_commands_soft_limit' (padrão de 32.768 mensagens). As filas Quorum mantêm mensagens confirmadas recentemente no cache em memória para entrega de baixa latência aos consumidores. Sob acúmulos profundos com publicadores rápidos e consumidores lentos, configure 'quorum_commands_soft_limit = 1000' e aplique uma política 'x-max-in-memory-length' para forçar despejo agressivo da memória para o disco sem comprometer a durabilidade do Raft.

Perguntas frequentes (FAQ)

Como calcular o consumo de memória do RabbitMQ por fila?▼

A memória total da fila é calculada como: M_total = M_payload + M_metadata + M_inflight + M_socket, onde M_payload representa os corpos das mensagens residentes na RAM, M_metadata representa o overhead de índice do processo BEAM (~32 B para Classic Queue v2, ~140 B para Classic Queue v1 e ~384 B para Quorum Queues), M_inflight = Consumidores * Prefetch basic.qos * (Payload + Metadados), e M_socket aloca de 64 KB a 256 KB por conexão TCP. Por exemplo, 50 consumidores com prefetch definido em 100 processando mensagens de 4 KB retêm 50 * 100 * 4,12 KB = 20,6 MB apenas em RAM não paginável em trânsito.

Qual é a referência ideal de vm_memory_high_watermark para o RabbitMQ em produção?▼

O valor de referência recomendado em produção para vm_memory_high_watermark é de 0,40 a 0,45 (40% a 45% da RAM total do sistema), reservando os 55% a 60% restantes para o page cache do sistema operacional, buffers de sockets e ciclos de compactação do garbage collector da BEAM do Erlang. Configurar o limite acima de 0,55 gera risco crítico de acionamento do Linux Out-Of-Memory (OOM) killer, pois o coletor de lixo por cópia do Erlang pode dobrar momentaneamente o tamanho da heap residente de um processo durante a compactação antes que os alarmes de memória consigam frear as publicações recebidas.

Quanta memória uma Quorum Queue consome em comparação com a Classic Queue?▼

Para mensagens ativas mantidas na memória, as filas Quorum exigem cerca de 30% a 40% mais memória por mensagem em relação à Classic Queue v2 devido ao rastreamento de consenso Raft (metadados de term, index e command: ~384 B vs. ~32 B por mensagem). Contudo, as filas Quorum gravam segmentos de log diretamente no disco e mantêm uma janela de cache com política de despejo, eliminando por completo a severa fragmentação de heap do Erlang e os travamentos de sincronização em todo o cluster que afetam as filas clássicas espelhadas legadas (HA sync).

O que acontece quando o RabbitMQ atinge o vm_memory_high_watermark?▼

Quando o uso total de memória do Erlang ultrapassa o vm_memory_high_watermark, o RabbitMQ dispara imediatamente um alarme de memória em todo o cluster, interrompe a leitura dos sockets TCP dos produtores e suspende o processamento de basic.publish. Os produtores são bloqueados em seus buffers locais de gravação de socket TCP sem receber um erro AMQP, enquanto os consumidores continuam operando normalmente. Assim que a memória residente cai abaixo do limite por meio do consumo de mensagens e da coleta de lixo da BEAM, o RabbitMQ cancela o alarme e retoma automaticamente a leitura dos sockets dos publicadores.

Como a contagem de prefetch do consumidor (QoS) afeta a RAM do RabbitMQ?▼

A configuração de prefetch basic.qos define quantas mensagens não confirmadas o RabbitMQ envia a um consumidor antes de aguardar um basic.ack. Mensagens despachadas ficam fixadas na memória do processo Erlang e não podem ser paginadas para o disco, independentemente da pressão de memória. Se 50 consumidores estiverem com prefetch em 1.000 processando mensagens de 10 KB, isso aloca 50 * 1.000 * 10 KB = 500 MB de RAM em trânsito não paginável. Limitar o prefetch entre 50 e 100 mantém a saturação de rede em velocidade de linha (line-rate) enquanto preserva a RAM em trânsito abaixo de 50 MB.

Como calcular o tempo de drenagem do backlog de uma fila no RabbitMQ?▼

O tempo de drenagem do backlog é calculado pela fórmula: Tempo de Drenagem (segundos) = Quantidade de Mensagens no Backlog / (Taxa Total de Consumo dos Consumidores msg/s - Taxa de Publicação de Entrada msg/s). Se 20 consumidores confirmarem 150 msg/s cada (3.000 msg/s no agregado) contra uma taxa de publicação de 1.000 msg/s, a velocidade líquida de drenagem será de 2.000 msg/s. Um backlog de 500.000 mensagens será esvaziado em 500.000 / 2.000 = 250 segundos (4 minutos e 10 segundos). Se a taxa dos consumidores for menor ou igual à taxa de publicação, o tempo de drenagem será infinito, indicando uma fila em expansão contínua.

Qual é a diferença no overhead de memória entre a Classic Queue v1 e a v2?▼

A Classic Queue v1 (CQv1) armazena os índices da fila em estruturas de dicionário de processo do Erlang, retendo de 120 B a 140 B em RAM por mensagem mesmo após os corpos dos payloads serem paginados para o disco. Em contrapartida, a Classic Queue v2 (CQv2) armazena mensagens e índices em arquivos de segmento imutáveis de 32 MB no disco, reduzindo o overhead em memória para mensagens paginadas em mais de 75%, chegando a cerca de 32 B por mensagem. Em um acúmulo de 10 milhões de mensagens, a CQv1 consome ~1,4 GB de memória de índice residente na heap do Erlang, enquanto a CQv2 exige apenas ~320 MB.

Ferramentas e utilitários relacionados

Todas as ferramentas →