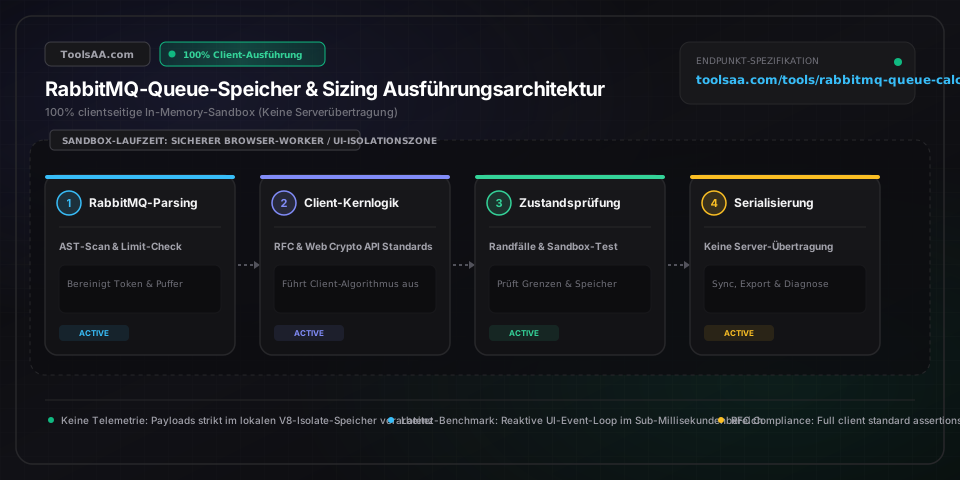
Interaktiver RabbitMQ-Rechner für Speicher & Durchsatz mit clientseitiger Echtzeitanalyse und Visualisierung.
Interaktiver RabbitMQ-Rechner für Queue-Speicherbedarf und Durchsatz mit clientseitiger Echtzeitanalyse und Visualisierung.
Definiert die Erlang-BEAM-Konsens-Engine und das Speichersubsystem. Quorum Queues implementieren den Raft-Konsensalgorithmus, der rund 30–40 % zusätzlichen RAM pro aktivem Zustandsübergang (In-Flight State Machine Entry) beansprucht (~384 B gegenüber ~32 B bei CQv2). Classic Queue v2 segmentiert Nachrichten in unveränderliche 32-MB-Plattenslices (Slabs) und reduziert den ausgelagerten Indexspeicher im Vergleich zu Erlang-Heap-ETS-Tabellen von Classic Queue v1 um 77 %.
Länge des unkomprimierten AMQP-0-9-1-Nachrichtenkörpers in Bytes. Payloads <= 64 Bytes werden direkt im lokalen Prozess-Heap von Erlang allokiert und durchlaufender Copying Garbage Collection unterzogen. Payloads > 64 Bytes nutzen Erlangs globalen, referenzgezählten Binär-Allokator (Refc Binaries), was speichereffizientes Zero-Copy-Sharing über mehrere Subscriber hinweg bei AMQP-Fanout-Exchanges ermöglicht.
Konfiguriertes AMQP-basic.qos-Prefetch-Limit pro Consumer-Kanal. Unter Prefetch übertragene Nachrichten bleiben bis zur Quittierung (Ack) im nicht auslagerbaren Erlang-RAM gesperrt. Ein Prefetch-Wert von 0 (unbegrenzt) führt bei Backlog-Spitzen zu drastischem RAM-Bloat. Der optimale Richtwert für stabilen Netzwerkdurchsatz ohne Speicherüberlastung liegt zwischen 50 und 200.
Gesamtzahl gleichzeitiger Worker-Kanäle mit aktiven basic.consume-Tags. Wird direkt mit consumerQosPrefetchCount und averageMessagePayloadBytes multipliziert, um den gesamten nicht auslagerbaren In-Flight-Speicherbedarf zu ermitteln: M_inflight = Consumer * Prefetch * (PayloadBytes + 120 B BEAM-Frame-Metadaten).
Dauerhafter Ingress-Durchsatz. Wird gegen vm_memory_high_watermark (Standard: 0,40 des Host-RAMs) und disk_free_limit validiert. Wenn die Ingress-Rate die Acknowledge-Rate der Consumer übersteigt, bestimmt die Netto-Backlog-Geschwindigkeit die Zeit bis zum Erreichen des Schwellenwerts: t_breach = (M_watermark - M_current) / (R_backlog * OverheadPerMsg).
AMQP-Nachrichten größer als 64 Bytes liegen auf Erlangs globalem, referenzgezähltem Binär-Heap (Refc Binaries). Extrahiert ein Consumer oder Broker-Plugin einen winzigen Header-Ausschnitt aus einer 1-MB-Payload, hält die Erlang-BEAM-Laufzeit die gesamte 1-MB-Binärallokation im physischen RAM, bis diese winzige Sub-Binary von der Garbage Collection bereinigt wird. In Routing-Pipelines mit hohem Durchsatz sollte daher ein explizites Binärkopieren (Binary Copying) oder String-Re-Encoding erzwungen werden, um die zugrunde liegende Refc-Referenz freizugeben und Phantom-Speicherwachstum zu eliminieren.
Quorum Queues schreiben Append-only Raft-Write-Ahead-Logs via fsync()-Operationen direkt auf die Festplatte. Bei Cloud-Block-Storage mit volatilen Schreiblatenzen (z. B. AWS EBS gp2 nach Erschöpfung des Burst-Guthabens) drosselt das IOPS-Throttling den Durchsatz unabhängig von CPU-Kernen auf teils 200 msg/s. Setzen Sie raft.wal_max_batch_size auf 4096 und binden Sie /var/lib/rabbitmq an performante NVMe-SSDs mit mindestens 10.000 dauerhaften Schreib-IOPS an, um mehr als 30.000 msg/s pro Quorum Queue zu erzielen.
Jede aktive TCP-Verbindung belegt Kernel-Socket-Speicher (rmem/wmem mit 64 KB–256 KB) plus Erlang-Reader-Prozess-Overhead (~40 KB). Werden hunderte aktiver Kanäle über eine einzige Verbindung gemultiplext, entsteht Head-of-Line-Blocking auf den Single-Thread-Socket-Readern von Erlang. Etablieren Sie stattdessen einen ausbalancierten Pool mit 10 bis 50 aktiven Kanälen pro TCP-Verbindung, um Multi-Core-BEAM-Scheduler optimal auszulasten, ohne Socket-File-Deskriptoren zu erschöpfen.
Sämtliche Prognosen zur Queue-Dimensionierung und zum Backlog-Abbau laufen vollständig clientseitig über deterministische algebraische O(1)-Gleichungen in In-Memory-Web-Workern. Cluster-Topologiedaten, Queue-Tiefen und Payload-Parameter verlassen zu keinem Zeitpunkt die lokale Browser-Sandbox und erreichen keine externen Netzwerk-Endpunkte – dies garantiert strikte Vertraulichkeit bei Sicherheits- und Infrastruktur-Audits.
Führen Sie 'rabbitmq-diagnostics memory_breakdown' aus, um zu prüfen, ob der vm_memory_high_watermark-Alarm (Standard: 0,40) ausgelöst wurde. RabbitMQ erzeugt Backpressure, indem es keine Daten mehr aus den TCP-Sockets der Publisher liest. Dadurch läuft der clientseitige Socket-Puffer voll und der Publisher-Thread friert ein, ohne eine AMQP-Protokollausnahme zu werfen. Erhöhen Sie den Grenzwert keinesfalls über 0,50. Reduzieren Sie stattdessen den Consumer-basic.qos-Prefetch auf <= 100, um unquittierte Nachrichten freizugeben, skalieren Sie Consumer horizontal oder leeren Sie inaktive Dead-Letter-Queues.
Prüfen Sie das System auf Leaks unquittierter Nachrichten und eine Erschöpfung der Atom-Tabelle. Führen Sie 'rabbitmqctl list_queues name messages_unacknowledged consumers' aus. Ist messages_unacknowledged hoch, quittieren Consumer keine Nachrichten mehr und sperren diese dauerhaft im RAM. Kontrollieren Sie zudem benutzerdefinierte AMQP-Routing-Header: Publisher dürfen keine dynamisch generierten Strings senden, die serverseitig in Erlang-Atome konvertiert werden. Die BEAM-Atom-Tabelle besitzt ein hartes Limit von 1.048.576 Einträgen; bei Überlauf stürzt der Broker sofort ab.
Überprüfen Sie den Sliding-Window-Cache der Quorum Queue über 'quorum_commands_soft_limit' (Standard: 32.768 Nachrichten). Quorum Queues halten kürzlich committete Nachrichten im RAM-Cache, um Consumer mit minimaler Latenz zu bedienen. Bei tiefen Backlogs mit schnellen Publishern und langsamen Consumern sollten Sie 'quorum_commands_soft_limit = 1000' konfigurieren und eine 'x-max-in-memory-length'-Policy hinterlegen, um eine aggressive Auslagerung auf die Festplatte zu erzwingen, ohne die Raft-Persistenz zu gefährden.
Der Gesamtspeicher einer Queue berechnet sich wie folgt: M_total = M_payload + M_metadata + M_inflight + M_socket. Dabei steht M_payload für im RAM verbleibende Nachrichtenkörper, M_metadata für den Index-Overhead der BEAM-Prozesse (~32 B bei Classic Queue v2, ~140 B bei Classic Queue v1, ~384 B bei Quorum Queues), M_inflight = Consumer * basic.qos-Prefetch * (Payload + Metadaten) und M_socket für 64 KB–256 KB pro TCP-Verbindung. Beispiel: 50 Consumer mit einem Prefetch von 100, die 4-KB-Nachrichten verarbeiten, blockieren allein 50 * 100 * 4,12 KB = 20,6 MB an nicht auslagerbarem In-Flight-RAM.
Der empfohlene Produktions-Richtwert für vm_memory_high_watermark liegt bei 0,40 bis 0,45 (40 % bis 45 % des gesamten System-RAMs). Die verbleibenden 55 % bis 60 % werden für den Dateisystem-Page-Cache des Betriebssystems, Socket-Puffer und Speicherbereinigungszyklen (Compaction Sweeps) der Erlang-BEAM-Garbage-Collection benötigt. Ein Schwellenwert über 0,55 birgt ein hohes Risiko, dass der Linux Out-Of-Memory (OOM) Killer den Broker beendet, da der Copying-Garbage-Collector von Erlang die Heap-Größe eines Prozesses während der Kompaktierung kurzzeitig verdoppeln kann, noch bevor Alarme eingehende Publishes drosseln.
Für aktive In-Memory-Nachrichten benötigen Quorum Queues aufgrund der Raft-Konsensverwaltung (Term-, Index- und Befehlsmetadaten: ~384 B gegenüber ~32 B pro Nachricht) rund 30 % bis 40 % mehr RAM als Classic Queue v2. Allerdings speichern Quorum Queues Log-Segmente direkt auf der Festplatte und nutzen ein Eviction-Cache-Fenster. Dadurch werden starke Erlang-Heap-Fragmentierung und clusterweite Synchronisationsblockaden, wie sie bei veralteten gespiegelten Classic Queues (HA Sync) auftraten, vollständig eliminiert.
Übersteigt der gesamte Erlang-Speicherverbrauch vm_memory_high_watermark, löst RabbitMQ unmittelbar einen clusterweiten Speicheralarm aus, stoppt das Lesen aus den TCP-Sockets der Producer und pausiert die Verarbeitung von basic.publish. Producer werden durch volllaufende lokale TCP-Socket-Schreibpuffer blockiert, ohne einen AMQP-Fehler zu erhalten, während Consumer unbeeinträchtigt weiterarbeiten. Sobald der physische Speicherverbrauch durch Abarbeitung und BEAM-Garbage-Collection wieder unter den Grenzwert sinkt, hebt RabbitMQ den Alarm auf und setzt das Polling der Publisher-Sockets automatisch fort.
Die Einstellung basic.qos prefetch legt fest, wie viele unquittierte Nachrichten RabbitMQ an einen Consumer ausliefert, bevor auf ein basic.ack gewartet wird. Ausgelieferte Nachrichten verbleiben im Erlang-Prozessspeicher gesperrt und können selbst unter Speicherdruck nicht auf die Festplatte ausgelagert werden. Wenn 50 Consumer mit einem Prefetch von 1.000 jeweils 10-KB-Nachrichten verarbeiten, blockiert dies 50 * 1.000 * 10 KB = 500 MB an nicht auslagerbarem In-Flight-RAM. Eine Begrenzung des Prefetch auf 50–100 gewährleistet maximale Netzwerkauslastung (Line-Rate) und hält den In-Flight-Speicher unter 50 MB.
Die Abbauzeit eines Backlogs berechnet sich nach der Formel: Abbauzeit (Sekunden) = Backlog-Nachrichtenanzahl / (Gesamte Consumer-Abbaurate msg/s - Eingehende Publish-Rate msg/s). Wenn 20 Consumer jeweils 150 msg/s quittieren (aggregiert 3.000 msg/s) bei einer Publish-Rate von 1.000 msg/s, beträgt die Netto-Abbaugeschwindigkeit 2.000 msg/s. Ein Backlog von 500.000 Nachrichten baut sich in 500.000 / 2.000 = 250 Sekunden (4 Minuten und 10 Sekunden) ab. Ist die Consumer-Rate kleiner oder gleich der Publish-Rate, ist die Abbauzeit unendlich und die Queue wächst unkontrolliert an.
Classic Queue v1 (CQv1) speichert Queue-Indizes in Prozess-Dictionary-Strukturen von Erlang und belegt selbst nach Auslagerung der Nachrichtenkörper auf die Festplatte weiterhin 120 B bis 140 B RAM pro Nachricht. Classic Queue v2 (CQv2) hingegen speichert Nachrichten und Indizes in unveränderlichen 32-MB-Segmentdateien auf der Festplatte. Dies reduziert den In-Memory-Overhead für ausgelagerte Nachrichten um mehr als 75 % auf etwa 32 B pro Nachricht. Bei einem Backlog von 10 Millionen Nachrichten beansprucht CQv1 rund 1,4 GB residenten Erlang-Heap-Indexspeicher, während CQv2 lediglich etwa 320 MB benötigt.
PostgreSQL-Speicher berechnen und optimierte PGTune-Parameter für die postgresql.conf generieren. Optimieren Sie shared_buffers, work_mem, effective_cache_size und max_connections.
Berechnen Sie die nutzbare Speicherkapazität in dezimalen TB und binären TiB für RAID 0, 1, 5, 6, 10, 50, 60 sowie ZFS RAIDZ1/Z2/Z3 inklusive Paritäts-Overhead, URE-Rebuild-Risiko, Rebuild-Dauer und Drive-Bay-Visualisierung.
Exakte A/B-Test-Stichprobengröße, statistische Power und Testdauer berechnen. Mit MDE-Rückrechnung, stetigen Metriken, Bonferroni-Korrektur und SRM-Prüfung.
PX in REM und REM in PX sofort mit flexibler Basis-Schriftgröße umrechnen. Erzeugt saubere CSS clamp() Fluid-Typografie, Tailwind-Klassen und Umrechnungstabellen.
HTTP-Statuscodes prüfen, Weiterleitungsketten testen und Response-Header analysieren. Diagnose von 1xx- bis 5xx-Fehlercodes nach RFC 9110, SEO-Auswirkungen und Behebungen.
Reguläre Ausdrücke in Echtzeit testen, debuggen und optimieren. Treffer, Erfassungsgruppen, Token-Erklärungen und Ersetzungsmuster direkt im Browser prüfen.