/
PostgreSQL-Speicherrechner & PGTune
Server-KlassePostgreSQL-Version

PostgreSQL-Speicherrechner & PGTune

PostgreSQL-Speicher berechnen und optimierte PGTune-Parameter für die postgresql.conf generieren. Optimieren Sie shared_buffers, work_mem, effective_cache_size und max_connections.

Workload-Voreinstellungen:

Hardware-Spezifikationen

Wählen Sie die Serverumgebung: Dedizierter DB-Server, Shared-Server oder Container.

GB
1 GB16 GB64 GB128 GB256 GB

Anzahl physischer CPU-Kerne für parallele Abfragen und Hintergrundprozesse (z. B. max_parallel_workers).

Wählen Sie das Speichermedium (SSD, NVMe oder HDD) zur Abstimmung der I/O-Kosten.

Verbindungen
Deaktiviert
Aktive Backend-Verbindungen100
Basis-Overhead pro Thread1000MB
Erforderliche Huge Pages4108
Optimierte Konfigurationsparameter (postgresql.conf)PostgreSQL 16 • NVMe SSD
# ----------------------------------------------------------------------
# PostgreSQL PostgreSQL 16 Performance Tuning Profile
# Generated by ToolsAA PostgreSQL Memory Calculator & PGTune Engine
# Host RAM: 32 GB | Cores: 8 | Storage: NVMe SSD
# Platform Regime: Linux Bare-Metal / VM | Workload: Web Application / High-Concurrency OLTP
# ----------------------------------------------------------------------

# ----------------------------
# Connectivity & Concurrency
# ----------------------------
max_connections = 100 # Active backend workers
superuser_reserved_connections = 3

# ----------------------------
# Memory & Cache Allocation
# ----------------------------
shared_buffers = 8GB # Hot page buffer pool
effective_cache_size = 24GB # Planner RAM estimate (Shared + OS Cache)
maintenance_work_mem = 1.6GB # Dedicated VACUUM & CREATE INDEX memory
work_mem = 98MB # Per sort/hash node memory
autovacuum_work_mem = -1 # Inherits maintenance_work_mem
huge_pages = try # Requires vm.nr_hugepages in /etc/sysctl.conf
temp_buffers = 16MB # Session-local temporary table memory

# ----------------------------
# Storage I/O & Query Planner
# ----------------------------
random_page_cost = 1.1 # Calibrated for NVMe SSD
seq_page_cost = 1.0 # Sequential disk block scan baseline
effective_io_concurrency = 300 # Prefetch asynchronous disk queues
default_statistics_target = 100 # Planner table sample resolution

# ----------------------------
# Checkpoints & WAL Journaling
# ----------------------------
checkpoint_completion_target = 0.9 # Spread checkpoint I/O over interval
checkpoint_timeout = 15min # Maximum duration between automatic checkpoints
min_wal_size = 4GB # Baseline recycled WAL buffer ring
max_wal_size = 32GB # Soft WAL ceiling before forced checkpoint
wal_buffers = 16MB # Ring buffer for unsaved WAL transactions
wal_compression = on # Lz4 or pglz compression to reduce disk I/O write amplification

# ----------------------------
# Parallel Query Execution
# ----------------------------
max_worker_processes = 8 # Maximum background and parallel workers
max_parallel_workers = 8 # Pool dedicated to parallel executor
max_parallel_workers_per_gather = 2 # Workers per single query plan node
max_parallel_maintenance_workers = 2 # Parallel index creation & VACUUM

# ----------------------------
# PostgreSQL Version-Specific Nuances
# ----------------------------
io_combine_limit = 256kB # PG16+ vectorized disk block read
track_io_timing = on # Monitor block read/write latencies
compute_query_id = on # Built-in query fingerprints for pg_stat_statements
shared_preload_libraries = 'pg_stat_statements' # Core query performance telemetry
Abfrageplaner-Status
Maximaler RAM-Bedarf32.9GB
Shared Buffers8GB25 % des Gesamtspeichers
Work Mem98MBPro Sortier- und Hash-Operation
OOM-Risiko103% PeakKritisches Risiko

Clientseitige Verarbeitung

Hochleistungsberechnung, die vollständig im lokalen Browser-Speicher ausgeführt wird.

Keine Server-Übertragung

Alle Nutzdaten verbleiben strikt lokal ohne jegliche externe Serverkommunikation.

Produktionsreifer Export

Saubere, optimierte Ausgabeformate für den sofortigen Produktiveinsatz.

Hinweis: Die berechneten Empfehlungen basieren auf bewährten PGTune-Heuristiken. Vor dem produktiven Einsatz wird ein Stresstest in einer Staging-Umgebung dringend empfohlen.
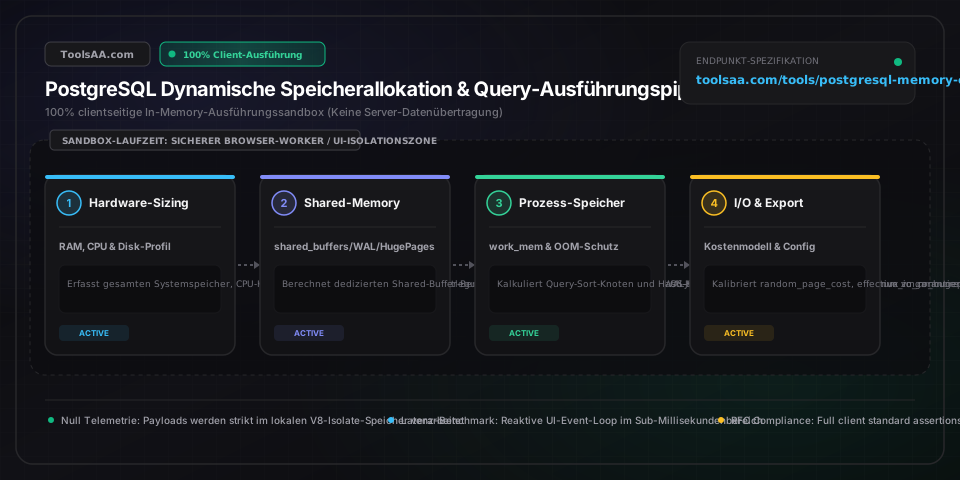
Technische Referenz & Architektur-Leitfaden

PostgreSQL Speicherrechner & PGTune — Referenzhandbuch

PostgreSQL-Speicherparameter präzise berechnen und PGTune-Konfigurationen für die postgresql.conf generieren. Optimieren Sie shared_buffers, work_mem, effective_cache_size und max_connections für maximale Performance.

PostgreSQL Speicherrechner & PGTune — Referenzhandbuch — Client-seitige In-Memory-Architektur und Datenfluss

Wichtige Parameter & Einstellungen

shared_buffersSpeicherangabe (z. B. 8 GB, 16 GB)

Definiert den dedizierten Arbeitsspeicher, den PostgreSQL für den gemeinsamen Daten-Cache (Shared Buffer Cache) reserviert. Der praxiserprobte Richtwert (Golden Ratio) unter Linux liegt bei 25 % des gesamten System-RAM. Werte über 40 % führen häufig zu Performance-Einbußen durch doppelte Pufferung (Double-Buffering) im Zusammenspiel mit dem Linux-Kernel-Page-Cache.

Standard: 128 MB (PostgreSQL-Werksstandard)
work_memSpeicherangabe (z. B. 32 MB, 64 MB)

Bestimmt das Basis-Speicherbudget für interne Sortieroperationen (ORDER BY) und Hash-Tabellen (Hash-Joins, Aggregationen), bevor Daten in temporäre Festplattendateien ausgelagert werden. Entscheidend: Dieser Wert wird pro Sortier- bzw. Hash-Knoten im Abfrageplan allokiert, NICHT pro Verbindung. Komplexe Abfragen mit mehreren Joins fordern work_mem mehrfach gleichzeitig an.

Standard: 4 MB
effective_cache_sizeSpeicherangabe (z. B. 24 GB, 48 GB)

Informiert den PostgreSQL-Abfrageplaner (Query Planner) über die Gesamtkapazität des für das Caching von Plattenblöcken verfügbaren Speichers (shared_buffers + Kernel-Page-Cache des Betriebssystems). Es wird kein physischer Speicher allokiert. Der Standardrichtwert beträgt 75 % des gesamten Host-RAM auf dedizierten Datenbankservern bzw. 50 % auf Shared-Servern.

Standard: 4 GB
maintenance_work_memSpeicherangabe (z. B. 1 GB, 2 GB)

Gibt das maximale Speicherbudget für administrative Wartungsoperationen wie VACUUM, CREATE INDEX und ALTER TABLE ADD FOREIGN KEY an. Empfohlene Obergrenze ist min(2 GB, 5 % des Gesamt-RAM); höhere Werte beschleunigen die Indexerstellung drastisch, allerdings können mehrere parallele Autovacuum-Worker bei zu hohen Werten den Host-Speicher überlasten.

Standard: 64 MB
max_connectionsGanzzahl (10 bis 5000)

Legt die maximale Anzahl gleichzeitiger direkter Client-Verbindungen fest. Da PostgreSQL pro Verbindung einen eigenen OS-Prozess forkt, verbraucht jede Session ~10 MB Basis-RAM plus dynamische work_mem-Allokationen. Hohe Verbindungszahlen (> 300) ohne Connection-Pooler (wie PgBouncer) führen zu massivem CPU-Cache-Thrashing und Kontextwechsel-Overhead.

Standard: 100
checkpoint_completion_targetDezimaler Fließkommawert (0,1 bis 1,0)

Gibt den Anteil des Checkpoint-Intervalls an, über den modifizierte Pufferseiten (Dirty Pages) auf die Festplatte geschrieben werden müssen. Der Benchmark-Standard liegt bei 0,9 (90 %), wodurch I/O-Schreibspitzen gleichmäßig über das Checkpoint-Fenster verteilt und I/O-Latenzspitzen vermieden werden.

Standard: 0,9 (seit PG 14; 0,5 in älteren Versionen)
wal_buffersSpeicherangabe (z. B. 16 MB, 64 MB)

Arbeitsspeicher für Write-Ahead-Log-Daten (WAL), bevor diese synchron auf den persistenten Speicher geflasht werden. Wird standardmäßig automatisch auf 3 % von shared_buffers skaliert (bis zu einer Obergrenze von 16 MB); bei schreibintensiven Massen-Ingestion-Workloads empfiehlt sich eine Erhöhung auf bis zu 64 MB.

Standard: -1 (automatisch auf 3 % von shared_buffers optimiert)
random_page_costDezimaler Fließkommawert (1,0 bis 10,0)

Kalkulatorischer Schätzwert des Abfrageplaners für nicht-sequentielle Plattenzugriffe im Verhältnis zu sequentiellen Scans (seq_page_cost = 1.0). Für NVMe-SSDs wird 1,1 und für SATA-SSDs 1,5 empfohlen; verbleibt der Wert beim historischen HDD-Standard von 4,0, bevorzugt der Planer fälschlicherweise langsame Sequential-Scans gegenüber Index-Scans.

Standard: 4,0
effective_io_concurrencyGanzzahl (0 bis 1000)

Anzahl gleichzeitiger asynchroner Platten-I/O-Operationen, die das zugrunde liegende Storage-Subsystem parallel verarbeiten kann. Der optimale Wert liegt bei 200 bis 300 für NVMe- und SATA-SSDs, während rotierende mechanische Festplatten (HDDs) bei 2 belassen werden sollten.

Standard: 1 (Linux-Standardwert; 0 deaktiviert Prefetching)
huge_pagesEnum ('on', 'off', 'try')

Steuert, ob shared_buffers Linux-HugePages (typisch 2 MB) anfordert. Die Aktivierung von HugePages eliminiert Translation-Lookaside-Buffer-Misses (TLB-Misses) auf Servern mit > 32 GB RAM, verhindert das Aufblähen der Page-Tables im Kernel und reduziert den CPU-Speicherzugriffs-Overhead um bis zu 15 %.

Standard: try

Profi-Tipps & Best Practices

Die work_mem-Multiplikatorfalle bei Multi-Join-Abfragen

Berechnen Sie den Spitzen-Speicherverbrauch niemals durch einfaches Multiplizieren von max_connections mit work_mem. Eine einzelne komplexe SQL-Abfrage mit 4 Hash-Joins, 2 Sortieroperationen und einer Window-Funktion kann work_mem innerhalb eines einzigen Backend-Prozesses bis zu 7-mal gleichzeitig allokieren. Bei 200 max_connections und 64 MB work_mem liegt der Worst-Case-Speicherbedarf nicht bei 12,8 GB, sondern bei über 89 GB – was den Linux-OOM-Killer unweigerlich auf den Plan ruft.

Warum shared_buffers über 40 % die Performance drastisch verschlechtert

PostgreSQL nutzt standardmäßig kein Direct I/O, sondern liest und schreibt Daten über den Kernel-Cache des Betriebssystems. Werden shared_buffers auf 60–80 % des RAM gesetzt, entsteht massives Double-Buffering: Identische Datenblöcke liegen redundant im PostgreSQL-Shared-Buffer und im Linux-Page-Cache. Belässt man 50–75 % des RAMs für den Page-Cache des Betriebssystems frei, kann Linux Index- und temporäre Arbeitsdateien wesentlich effizienter zwischenspeichern.

Absicherung von Linux vm.overcommit_memory gegen Postmaster-Abstürze

Standardmäßig nutzt Linux ein heuristisches Memory-Overcommit (vm.overcommit_memory = 0). Sind physischer RAM und Swap erschöpft, beendet der Linux-OOM-Killer den Prozess mit dem höchsten Badness-Score – was fast immer der PostgreSQL-Postmaster-Prozess ist. Konfigurieren Sie im Produktivbetrieb vm.overcommit_memory = 2 und vm.overcommit_ratio = 80 in Kombination mit vorallokierten HugePages, um unvorhersehbare Out-of-Memory-Crashes zuverlässig zu verhindern.

Der Connection-Pooling-Leistungsabfall: Warum 1.000 Direktverbindungen den Durchsatz zerstören

Da PostgreSQL auf einer Prozess-pro-Verbindung-Architektur (Process-per-Connection) basiert, zwingen 1.000 aktive Direktverbindungen die CPU dazu, über 40 % ihrer Zyklen für Kontextwechsel auf Betriebssystemebene und L1/L2/L3-Cache-Invalidierungen aufzuwenden. Der Einsatz von PgBouncer im Transaction-Pooling-Modus mit pool_size = 2 * CPU-Kerne + Festplatten-Spindeln (z. B. 32–64 Backend-Verbindungen) steigert den Gesamtdurchsatz um 300–500 % und eliminiert ungenutzten Idle-Speicher-Overhead vollständig.

Optimierung der Checkpoint-Frequenz zur Vermeidung von I/O-Blockaden

Bei hohem Transaktions- und Schreibvolumen führt der Standardwert max_wal_size = 1GB dazu, dass Checkpoints alle paar Sekunden ausgelöst werden, anstatt das reguläre checkpoint_timeout abzuwarten. Erhöhen Sie max_wal_size auf modernen SSDs auf 16 GB oder 32 GB und stellen Sie sicher, dass checkpoint_completion_target explizit auf 0,9 konfiguriert ist. Dies verteilt die Schreiblast gleichmäßig über 90 % des Checkpoint-Intervalls und verhindert plötzliche I/O-Engpässe.

Häufige Fehlerquellen & Fehlerbehebung

⚠️Out of memory: Killed process (postmaster) durch den Linux-Kernel-OOM-Killer

Reduzieren Sie umgehend work_mem oder verringern Sie max_connections. Implementieren Sie Connection-Pooling mit PgBouncer, damit Client-Verbindungen nicht unkontrolliert Backend-Speicher allokieren. Konfigurieren Sie vm.overcommit_memory = 2 in der Datei /etc/sysctl.conf und richten Sie Swap-Speicher im Umfang von mindestens 50 % des RAMs als Sicherheitsreserve ein.

⚠️FATAL: could not attach to shared memory segment: Cannot allocate memory

Dieser Fehler tritt auf, wenn shared_buffers das Kernel-Limit für shmmax oder das HugePages-Kontingent übersteigt. Falls huge_pages = on gesetzt ist, prüfen Sie mittels 'grep Huge /proc/meminfo', ob HugePages_Free >= ceil(shared_buffers / 2048kB) gilt. Setzen Sie alternativ huge_pages = try oder hinterlegen Sie 'vm.nr_hugepages = [berechneter_Wert]' in /etc/sysctl.conf und laden Sie die Parameter via 'sysctl -p' neu.

⚠️PostgreSQL ignoriert Indizes auf SSDs und führt langsame sequentielle Tabellen-Scans durch

Der Standardwert von random_page_cost liegt bei 4,0 – kalibriert für rotierende Festplatten, bei denen zufällige Zugriffe viermal langsamer sind als sequentielle Lesevorgänge. Auf NVMe- und SATA-SSDs entfällt diese mechanische Latenz nahezu vollständig. Konfigurieren Sie random_page_cost = 1.1 (NVMe) bzw. 1.5 (SATA-SSD) in der postgresql.conf und führen Sie 'SELECT pg_reload_conf();' aus, um Index-Scans sofort wieder zu priorisieren.

⚠️Periodische Latenzspitzen bei Abfragen alle 5 bis 15 Minuten

Verursacht durch aggressive Checkpoint-Schreibvorgänge, die modifizierte Pufferseiten schlagartig auf die Festplatte flashen. Prüfen Sie die PostgreSQL-Logs auf Warnungen wie 'checkpoints are occurring too frequently'. Setzen Sie checkpoint_completion_target = 0.9 zur I/O-Glättung, erhöhen Sie max_wal_size von 1 GB auf 16 GB oder mehr und heben Sie checkpoint_timeout auf 15min oder 30min an.

⚠️Hohe CPU-Auslastung bei Hunderten von Verbindungen im Status 'idle in transaction'

Direkte Client-Verbindungen verbrauchen selbst im Leerlauf jeweils ca. 10 MB Resident Memory und blockieren Transaktions-Snapshots sowie Speicher-Locks. Setzen Sie PgBouncer im Transaction-Pooling-Modus ein. Ergänzen Sie zudem idle_in_transaction_session_timeout = '60s' in der postgresql.conf, um verwaiste Client-Transaktionen nach 60 Sekunden automatisch zu beenden.

Häufig gestellte Fragen (FAQ)

Wie wird work_mem berechnet, um den Linux-OOM-Killer zu verhindern?▼

work_mem wird nach folgender Formel berechnet: work_mem = ((Gesamt_RAM - shared_buffers) * (1 - OS_Reserve_Ratio)) / (max_connections * concurrent_sort_nodes_per_query), wobei OS_Reserve_Ratio typischerweise 0,20 (20 %) beträgt und concurrent_sort_nodes bei 2 für OLTP bzw. 4 bis 8 für OLAP liegt. Da work_mem pro Sortier- bzw. Hash-Operation allokiert wird und nicht pro Verbindung, schützt ein work_mem-Wert zwischen 16 MB und 64 MB bei OLTP-Workloads davor, dass Abfragen mit mehreren Joins den System-RAM erschöpfen und den Linux-OOM-Killer auslösen.

Welche shared_buffers-Größe wird für 16 GB, 32 GB oder 64 GB RAM empfohlen?▼

Die empfohlene Konfiguration für shared_buffers unter Linux beträgt 25 % des gesamten System-Arbeitsspeichers: 4 GB bei einem 16-GB-Server, 8 GB bei 32 GB RAM und 16 GB bei 64 GB RAM. Zwar unterstützt PostgreSQL Werte von bis zu 40 % des RAMs, Einstellungen über 40 % bringen jedoch selten Performance-Vorteile und führen infolge von Double-Buffering mit dem Linux-Kernel-Page-Cache häufig zu erheblichen Leistungseinbußen.

Was ist der Unterschied zwischen shared_buffers und effective_cache_size?▼

shared_buffers allokiert beim Start von PostgreSQL echten physischen Arbeitsspeicher, um Tabellen- und Indexseiten im gemeinsamen Cache vorzuhalten. Im Gegensatz dazu allokiert effective_cache_size keinerlei Speicher; es dient dem Query Planner lediglich als Schätzwert, wie viel Datenvolumen voraussichtlich in shared_buffers und dem Betriebssystem-Page-Cache kumuliert zwischengespeichert ist. Der empfohlene Standardwert liegt bei 50 % bis 75 % des gesamten Host-RAMs.

Warum stürzt PostgreSQL mit Out-of-Memory ab, obwohl scheinbar noch freier RAM vorhanden ist?▼

PostgreSQL stürzt mit einem Out-of-Memory-Fehler ab, wenn der von Backend-Abfragen angeforderte Speicher das Overcommit-Limit des Kernels überschreitet oder wenn Speicherfragmentierung die Allokation zusammenhängender Shared-Memory-Segmente verhindert. Ist zudem das Linux-Memory-Overcommit aktiv (vm.overcommit_memory = 0), gestattet der Kernel Prozessen, mehr virtuellen Speicher zu reservieren, als physisch existiert. Werden diese Pages tatsächlich beschrieben, beendet der OOM-Killer den Postmaster-Prozess abrupt per SIGKILL, was den gesamten Datenbank-Cluster stoppt.

Wie viele max_connections sollten für PostgreSQL konfiguriert werden?▼

Direkte max_connections sollten idealerweise auf 100 bis 200 begrenzt werden. Da PostgreSQL für jede Verbindung einen dedizierten Betriebssystem-Prozess nutzt, führen mehr als 200 bis 300 aktive Direktverbindungen zu enormem CPU-Kontextwechsel-Overhead und Lock-Contention. Für Anwendungen mit Hunderten oder Tausenden parallelen Client-Verbindungen sollte ein Connection-Pooler wie PgBouncer im Transaction-Mode eingesetzt werden (mit pool_size = 2 * CPU-Kerne + Spindeln), wodurch sich Tausende Client-Sessions effizient 20 bis 50 aktive Backend-Verbindungen teilen.

Sollten HugePages unter Linux für PostgreSQL aktiviert werden?▼

Ja, HugePages sollten für Produktionsdatenbanken mit 32 GB RAM oder mehr grundsätzlich aktiviert werden. Standardmäßige x86_64-Linux-Speicherseiten sind 4 KB groß, was bei großen shared_buffers Millionen Page-Table-Einträge erfordert, den Kernel-Speicher aufbläht und Translation-Lookaside-Buffer-Misses (TLB-Misses) provoziert. Linux-HugePages mit 2 MB reduzieren diesen Page-Table-Overhead um den Faktor 512, steigern den Abfragedurchsatz um 5 % bis 15 % und verhindern Allokationsabstürze des Shared Memory zuverlässig.

Welcher Wert für random_page_cost empfiehlt sich für NVMe- und SSD-Speicher?▼

Konfigurieren Sie random_page_cost auf 1,1 für NVMe-SSDs und 1,5 für SATA-SSDs (im Vergleich zum Basiswert seq_page_cost = 1.0). Der Standardwert von 4,0 stammt aus der Ära rotierender Festplatten mit hoher mechanischer Suchzeit (Seek Latency). Wird der Wert 4,0 auf SSDs beibehalten, überschätzt der PostgreSQL-Query-Planner die Kosten von Index-Lookups und führt fälschlicherweise vollständige Tabellen-Scans (Sequential Scans) aus.

Was ist der Unterschied zwischen maintenance_work_mem und autovacuum_work_mem?▼

maintenance_work_mem bestimmt das Speicherbudget für manuelle administrative Aufgaben wie CREATE INDEX und VACUUM FULL (üblicherweise zwischen 1 GB und 2 GB konfiguriert). autovacuum_work_mem begrenzt hingegen gezielt den Speicher, der jedem einzelnen Autovacuum-Hintergrund-Worker zur Verfügung steht. Steht autovacuum_work_mem auf -1, greift jeder Worker auf maintenance_work_mem zurück; bei autovacuum_max_workers = 3 könnten drei parallele Worker somit 6 GB RAM beanspruchen. Ein explizit definierter Wert für autovacuum_work_mem (z. B. 512 MB) schützt den regulären Abfragebetrieb vor Speicherengpässen.

Verwandte Tools & Hilfsprogramme

Alle Tools →