/
Calculateur Mémoire PostgreSQL & PGTune
Profil d'instanceVersion PostgreSQL

Calculateur Mémoire PostgreSQL & PGTune

Calculez l'allocation mémoire PostgreSQL et générez les paramètres PGTune de postgresql.conf. Optimisez shared_buffers, work_mem, effective_cache_size et max_connections.

Préréglages rapides:

Spécifications matérielles

Sélectionnez le profil de charge de travail (Web, OLTP, Décisionnel ou Mixte) pour calibrer la mémoire.

GB
1 GB16 GB64 GB128 Go256 GB

Nombre de cœurs processeur physiques ou logiques (vCPU) alloués à l'instance PostgreSQL.

Spécifiez le support de stockage (SSD, NVMe, HDD) pour ajuster les coûts d'E/S du planificateur.

connexions
Désactivé
Connexions backend actives100
Consommation fixe par processus1000MB
Huge Pages requises4108
Paramètres recommandés pour postgresql.confPostgreSQL 16 • NVMe SSD
# ----------------------------------------------------------------------
# PostgreSQL PostgreSQL 16 Performance Tuning Profile
# Generated by ToolsAA PostgreSQL Memory Calculator & PGTune Engine
# Host RAM: 32 GB | Cores: 8 | Storage: NVMe SSD
# Platform Regime: Linux Bare-Metal / VM | Workload: Web Application / High-Concurrency OLTP
# ----------------------------------------------------------------------

# ----------------------------
# Connectivity & Concurrency
# ----------------------------
max_connections = 100 # Active backend workers
superuser_reserved_connections = 3

# ----------------------------
# Memory & Cache Allocation
# ----------------------------
shared_buffers = 8GB # Hot page buffer pool
effective_cache_size = 24GB # Planner RAM estimate (Shared + OS Cache)
maintenance_work_mem = 1.6GB # Dedicated VACUUM & CREATE INDEX memory
work_mem = 98MB # Per sort/hash node memory
autovacuum_work_mem = -1 # Inherits maintenance_work_mem
huge_pages = try # Requires vm.nr_hugepages in /etc/sysctl.conf
temp_buffers = 16MB # Session-local temporary table memory

# ----------------------------
# Storage I/O & Query Planner
# ----------------------------
random_page_cost = 1.1 # Calibrated for NVMe SSD
seq_page_cost = 1.0 # Sequential disk block scan baseline
effective_io_concurrency = 300 # Prefetch asynchronous disk queues
default_statistics_target = 100 # Planner table sample resolution

# ----------------------------
# Checkpoints & WAL Journaling
# ----------------------------
checkpoint_completion_target = 0.9 # Spread checkpoint I/O over interval
checkpoint_timeout = 15min # Maximum duration between automatic checkpoints
min_wal_size = 4GB # Baseline recycled WAL buffer ring
max_wal_size = 32GB # Soft WAL ceiling before forced checkpoint
wal_buffers = 16MB # Ring buffer for unsaved WAL transactions
wal_compression = on # Lz4 or pglz compression to reduce disk I/O write amplification

# ----------------------------
# Parallel Query Execution
# ----------------------------
max_worker_processes = 8 # Maximum background and parallel workers
max_parallel_workers = 8 # Pool dedicated to parallel executor
max_parallel_workers_per_gather = 2 # Workers per single query plan node
max_parallel_maintenance_workers = 2 # Parallel index creation & VACUUM

# ----------------------------
# PostgreSQL Version-Specific Nuances
# ----------------------------
io_combine_limit = 256kB # PG16+ vectorized disk block read
track_io_timing = on # Monitor block read/write latencies
compute_query_id = on # Built-in query fingerprints for pg_stat_statements
shared_preload_libraries = 'pg_stat_statements' # Core query performance telemetry
Statut du planificateur
Pic de RAM32.9GB
shared_buffers8GBMémoire tampon partagée
work_mem98MBMémoire de travail par opération
Risque OOM103% PeakCritique

Traitement côté client

Calcul haute performance exécuté intégralement dans la mémoire du navigateur.

Zéro envoi sur serveur

Toutes les données restent strictement locales, sans aucune transmission vers des serveurs externes.

Prêt pour la production

Directives de configuration propres et optimisées, prêtes pour un déploiement immédiat.

Ces recommandations constituent une référence d'ingénierie. Validez systématiquement vos ajustements sur un environnement de préproduction avant déploiement.
Référence technique et guide d'architecture

Calculateur Mémoire PostgreSQL & PGTune — Guide de référence

Calculez la mémoire PostgreSQL et générez vos paramètres postgresql.conf optimisés via PGTune. Ajustez shared_buffers, work_mem, effective_cache_size et max_connections.

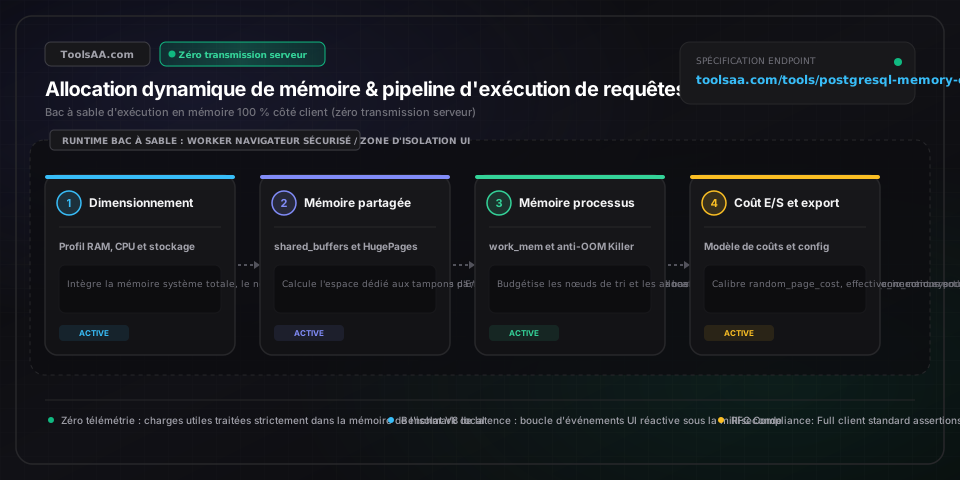
Calculateur Mémoire PostgreSQL & PGTune — Guide de référence — Architecture en mémoire côté client et flux de données

Paramètres clés et contrôles

shared_buffersChaîne de taille mémoire (ex. : 8 Go, 16 Go)

Définit la mémoire dédiée allouée par PostgreSQL pour le cache partagé des blocs de données. Le ratio de référence optimal (golden ratio) sur Linux est de 25 % de la RAM totale. Dépasser 40 % dégrade les performances en raison du double tamponnage avec le cache de pages du noyau Linux.

Par défaut : 128 Mo (valeur par défaut d'usine PostgreSQL)
work_memChaîne de taille mémoire (ex. : 32 Mo, 64 Mo)

Spécifie le budget mémoire de base alloué aux opérations de tri interne et aux tables de hachage avant écriture sur les fichiers temporaires du disque. Élément fondamental : cette mémoire est allouée par nœud d'opération (tri ou hachage) au sein de chaque requête, et NON par connexion. Une requête complexe comportant plusieurs jointures alloue work_mem plusieurs fois en simultané.

Par défaut : 4 Mo
effective_cache_sizeChaîne de taille mémoire (ex. : 24 Go, 48 Go)

Informe le planificateur de requêtes du volume total de mémoire disponible pour la mise en cache disque (shared_buffers + cache de pages du noyau). N'alloue aucune mémoire physique. La valeur standard recommandée est de 75 % de la RAM totale sur un serveur dédié, ou 50 % sur un serveur partagé.

Par défaut : 4 Go
maintenance_work_memChaîne de taille mémoire (ex. : 1 Go, 2 Go)

Définit la mémoire maximale utilisée pour les opérations de maintenance comme VACUUM, CREATE INDEX et ALTER TABLE ADD FOREIGN KEY. Le plafond recommandé est min(2 Go, 5 % de la RAM totale) ; une valeur supérieure accélère la création d'index, mais les workers d'autovacuum peuvent saturer la mémoire de l'hôte en l'absence de régulation.

Par défaut : 64 Mo
max_connectionsEntier (10 à 5000)

Détermine le nombre maximal de connexions clientes directes et simultanées. Chaque connexion PostgreSQL instancie un processus système distinct consommant environ 10 Mo de RAM de base, auxquels s'ajoutent les allocations dynamiques de work_mem. Un volume élevé de connexions (> 300) sans PgBouncer provoque une saturation sévère du cache processeur (thrashing).

Par défaut : 100
checkpoint_completion_targetFlottant décimal (0,1 à 1,0)

Fraction de l'intervalle de point de contrôle (checkpoint) sur laquelle les pages modifiées (dirty buffers) doivent être écrites sur disque. Le standard de référence est de 0,9 (90 %), ce qui lisse les pics d'E/S en écriture sur toute la fenêtre de checkpoint et élimine les micro-blocages de latence.

Par défaut : 0,9 (depuis PG 14 ; 0,5 sur les anciennes versions)
wal_buffersChaîne de taille mémoire (ex. : 16 Mo, 64 Mo)

Mémoire allouée pour les données du journal de transactions (WAL) avant leur synchronisation sur disque. Ajustée automatiquement à 3 % de shared_buffers jusqu'à un plafond de 16 Mo, ou 64 Mo pour les charges d'ingestion massive intensives en écriture.

Par défaut : -1 (auto-ajusté à 3 % de shared_buffers)
random_page_costFlottant décimal (1,0 à 10,0)

Estimation par le planificateur du coût d'accès à une page disque non séquentielle par rapport à un balayage séquentiel (seq_page_cost = 1.0). Réglez-le à 1.1 pour les SSD NVMe et à 1.5 pour les SSD SATA ; conserver la valeur par défaut de 4.0 (héritée des disques mécaniques) incite le planificateur à privilégier à tort les scans séquentiels au détriment des index.

Par défaut : 4,0
effective_io_concurrencyEntier (0 à 1000)

Nombre d'opérations d'E/S disque asynchrones simultanées que le sous-système de stockage sous-jacent peut traiter en parallèle. La valeur optimale se situe entre 200 et 300 pour les SSD NVMe/SATA, tandis que les disques durs rotatifs mécaniques doivent rester à 2.

Par défaut : 1 (valeur par défaut Linux ; 0 désactive la pré-lecture)
huge_pagesÉnumération ('on', 'off', 'try')

Détermine si shared_buffers sollicite les HugePages de 2 Mo du noyau Linux. L'activation des HugePages élimine les défauts de cache du TLB (Translation Lookaside Buffer) sur les serveurs dotés de plus de 32 Go de RAM, empêchant la prolifération de la table des pages et réduisant le surcoût processeur d'accès à la mémoire jusqu'à 15 %.

Par défaut : try

Conseils de pro et bonnes pratiques

Le piège multiplicateur de work_mem dans les requêtes multi-jointures

Ne calculez jamais la mémoire de pointe en multipliant simplement max_connections par work_mem. Une seule requête SQL complexe comprenant 4 jointures de hachage (hash joins), 2 tris et une fonction de fenêtrage peut allouer work_mem 7 fois simultanément au sein d'un unique processus backend. Si max_connections vaut 200 et work_mem 64 Mo, la consommation maximale théorique n'est pas de 12,8 Go, mais dépasse 89 Go, déclenchant l'intervention immédiate de l'OOM Killer Linux.

Pourquoi un shared_buffers supérieur à 40 % dégrade les performances

PostgreSQL n'utilise pas les E/S directes par défaut ; il lit les pages à travers le cache de pages du noyau du système d'exploitation. Allouer shared_buffers à 60-80 % de la RAM crée un double tamponnage massif où les mêmes blocs résident simultanément dans les tampons partagés de PostgreSQL et le cache Linux. Laisser 50 à 75 % de la RAM libre pour le cache du noyau permet à Linux de mettre en cache les fichiers d'index et les fichiers temporaires avec une bien plus grande efficacité.

Verrouiller le paramètre Linux vm.overcommit_memory pour protéger le Postmaster

Par défaut, Linux applique une surallocation heuristique de la mémoire (vm.overcommit_memory = 0). Lorsque la RAM physique et le swap sont saturés, l'OOM Killer de Linux sélectionne et termine le processus affichant le score de criticité (badness score) le plus élevé, qui correspond presque systématiquement au processus postmaster de PostgreSQL. En production, configurez vm.overcommit_memory = 2 et vm.overcommit_ratio = 80 avec des HugePages préallouées pour garantir une protection totale contre les arrêts inopinés par manque de mémoire.

L'écueil du multiplexage : pourquoi 1 000 connexions directes effondrent le débit

PostgreSQL s'appuyant sur une architecture à un processus par connexion, maintenir 1 000 connexions clientes directes force le processeur à consacrer plus de 40 % de ses cycles aux changements de contexte du système d'exploitation et aux invalidations de lignes de cache L1/L2/L3. Déployer PgBouncer en mode transactionnel avec un pool_size calibré à 2 * cœurs CPU + disques physiques (ex. : 32 à 64 connexions backend) augmente le débit global des requêtes de 300 à 500 % tout en réduisant la mémoire résiduelle inactive à zéro.

Ajuster la fréquence des checkpoints pour éliminer les goulots d'étranglement disque

Si PostgreSQL absorbe un volume massif de transactions en écriture, le réglage par défaut max_wal_size de 1 Go déclenchera des points de contrôle toutes les quelques secondes au lieu de respecter checkpoint_timeout. Augmentez max_wal_size à 16 Go ou 32 Go sur les SSD récents, et assurez-vous que checkpoint_completion_target est explicitement configuré à 0.9. Cette configuration répartit uniformément les écritures sur 90 % de l'intervalle de checkpoint, évitant ainsi les blocages brutaux d'E/S disque.

Pièges courants et dépannage

⚠️Out of memory: Killed process (postmaster) déclenché par l'OOM Killer du noyau Linux

Réduisez immédiatement work_mem ou diminuez max_connections. Mettez en place un pooler de connexions (PgBouncer) pour éviter que les sessions clientes n'instancient des consommateurs de mémoire illimités en backend. Configurez vm.overcommit_memory = 2 dans /etc/sysctl.conf et assurez-vous que l'espace swap équivaut à au moins 50 % de la RAM physique en guise de marge de sécurité d'urgence.

⚠️FATAL: could not attach to shared memory segment: Cannot allocate memory

Cette erreur survient lorsque shared_buffers dépasse les limites shmmax du noyau ou le quota de HugePages alloué. Si huge_pages = on, exécutez 'grep Huge /proc/meminfo' pour vérifier que HugePages_Free >= ceil(shared_buffers / 2048kB). Vous pouvez également définir huge_pages = try, ou ajouter 'vm.nr_hugepages = [valeur_calculée]' dans /etc/sysctl.conf puis appliquer via 'sysctl -p'.

⚠️PostgreSQL ignore les index sur SSD et exécute des scans séquentiels lents (Seq Scan)

La valeur par défaut de random_page_cost est de 4.0, calibrée historiquement pour les disques durs mécaniques où les accès aléatoires sont 4 fois plus lents que les lectures séquentielles. Sur les SSD NVMe et SATA, la latence mécanique de recherche aléatoire est quasiment nulle. Configurez random_page_cost = 1.1 (NVMe) ou 1.5 (SSD SATA) dans postgresql.conf puis exécutez 'SELECT pg_reload_conf();' pour restaurer immédiatement la priorité aux balayages par index.

⚠️Pics périodiques de latence sur les requêtes toutes les 5 à 15 minutes

Ce phénomène provient d'écritures de checkpoints trop agressives qui déchargent brutalement les tampons modifiés. Vérifiez dans les journaux de PostgreSQL la présence du message 'checkpoints are occurring too frequently'. Configurez checkpoint_completion_target = 0.9 pour lisser le flux d'E/S, passez max_wal_size de 1 Go à 16 Go ou plus, et étendez checkpoint_timeout à 15min ou 30min.

⚠️Consommation CPU critique avec des centaines de connexions 'idle in transaction'

Chaque connexion cliente directe monopolise environ 10 Mo de mémoire résidente même au repos, tout en maintenant ouverts des snapshots de transaction et des verrous mémoire. Déployez PgBouncer en mode transaction. Ajoutez la directive idle_in_transaction_session_timeout = '60s' dans postgresql.conf pour clore automatiquement les transactions orphelines abandonnées par les clients.

Foire aux questions (FAQ)

Comment calculer work_mem pour éviter l'intervention de l'OOM Killer Linux ?▼

work_mem se calcule selon la formule suivante : work_mem = ((RAM_Totale - shared_buffers) * (1 - Ratio_Reserve_OS)) / (max_connections * nœuds_de_tri_simultanés), où Ratio_Reserve_OS est généralement fixé à 0,20 (20 %) et le nombre de nœuds de tri simultanés est de 2 pour les charges transactionnelles (OLTP) ou de 4 à 8 pour l'analytique (OLAP). Puisque work_mem est alloué par opération élémentaire de tri ou de hachage et non par connexion, maintenir work_mem entre 16 Mo et 64 Mo en OLTP empêche les requêtes avec jointures multiples d'épuiser la RAM système et de déclencher l'OOM Killer (Out-of-Memory) de Linux.

Quel dimensionnement de shared_buffers est recommandé pour 16 Go, 32 Go ou 64 Go de RAM ?▼

Le réglage recommandé pour shared_buffers sous Linux est de 25 % de la RAM totale du système : 4 Go pour un serveur de 16 Go, 8 Go pour 32 Go, et 16 Go pour 64 Go de RAM. Bien que PostgreSQL prenne en charge des valeurs allant jusqu'à 40 % de la mémoire, dépasser ce seuil n'apporte que très rarement des gains de performance et entraîne souvent des dégradations notables dues au phénomène de double tamponnage avec le cache de pages du noyau de l'OS.

Quelle est la différence entre shared_buffers et effective_cache_size ?▼

shared_buffers alloue réellement de la mémoire physique au démarrage de l'instance PostgreSQL pour héberger le cache partagé des blocs de tables et d'index. À l'inverse, effective_cache_size n'alloue absolument aucune mémoire physique : il s'agit d'un indicateur purement consultatif utilisé par le planificateur de requêtes pour estimer le volume cumulé de données mis en cache conjointement dans shared_buffers et dans le cache de pages du système d'exploitation. La bonne pratique consiste à calibrer effective_cache_size entre 50 % et 75 % de la RAM totale de la machine.

Pourquoi PostgreSQL plante-t-il par manque de mémoire alors qu'il semble rester de la RAM libre ?▼

PostgreSQL s'interrompt brutalement pour manque de mémoire (Out of Memory) lorsque la quantité allouée par les requêtes backend outrepasse la limite de surallocation (overcommit) du noyau, ou lorsque la fragmentation mémoire empêche l'attribution de segments contigus en mémoire partagée. De surcroît, si la surallocation de mémoire Linux (vm.overcommit_memory = 0) est active, le noyau autorise les processus à réserver davantage de mémoire virtuelle qu'il n'en existe physiquement ; dès lors que ces pages sont écrites, l'OOM Killer envoie sans préavis un signal SIGKILL au processus postmaster, provoquant le crash immédiat de l'ensemble du cluster de bases de données.

Combien de connexions max_connections faut-il configurer sur PostgreSQL ?▼

Le paramètre direct max_connections doit idéalement être restreint entre 100 et 200. PostgreSQL exploitant un processus système dédié par connexion, dépasser 200 à 300 connexions directes actives génère des commutations de contexte CPU massives et de sévères contentions de verrous. Pour les applications nécessitant des centaines voire des milliers de connexions clientes simultanées, utilisez un multiplexeur de connexions tel que PgBouncer en mode transaction avec pool_size dimensionné à (2 * cœurs CPU + nombre de disques), ce qui permet à des milliers de sessions clientes de se partager efficacement 20 à 50 backends PostgreSQL actifs.

Faut-il activer les HugePages sous Linux pour PostgreSQL ?▼

Oui, les HugePages doivent impérativement être activées sur les bases de données de production dotées de 32 Go de RAM ou plus. Par défaut, les pages de mémoire Linux x86_64 sont de 4 Ko, imposant des millions d'entrées dans la table des pages pour un shared_buffers volumineux, ce qui gonfle la consommation mémoire et génère des défauts de cache TLB (Translation Lookaside Buffer). L'adoption des HugePages de 2 Mo sous Linux divise l'empreinte de la table des pages par 512, procurant un gain de débit de 5 % à 15 % sur les requêtes tout en éliminant les échecs d'allocation de mémoire partagée.

Quelle valeur de random_page_cost appliquer pour un stockage SSD ou NVMe ?▼

Configurez random_page_cost à 1.1 pour les SSD NVMe et à 1.5 pour les SSD SATA, face à la valeur de référence seq_page_cost fixée à 1.0. La valeur par défaut de 4.0 a été établie il y a plusieurs décennies pour les disques durs magnétiques rotatifs pénalisés par une forte latence mécanique lors des accès aléatoires. Conserver 4.0 sur un stockage SSD pousse le planificateur de PostgreSQL à surestimer le coût des index et à déclencher des scans séquentiels intempestifs sur l'intégralité des tables.

Quelle est la différence entre maintenance_work_mem et autovacuum_work_mem ?▼

maintenance_work_mem détermine la mémoire allouée aux opérations administratives manuelles telles que CREATE INDEX et VACUUM FULL, couramment calibrée entre 1 Go et 2 Go. De son côté, autovacuum_work_mem plafonne spécifiquement la mémoire allouée à chaque processus worker d'autovacuum en tâche de fond. Si autovacuum_work_mem reste positionné à -1, chaque worker hérite de la valeur de maintenance_work_mem ; avec autovacuum_max_workers = 3, trois workers concurrents pourraient ainsi accaparer 6 Go de RAM, au risque d'asphyxier le serveur. Définir autovacuum_work_mem explicitement (par exemple à 512 Mo) préserve les ressources requises pour les requêtes applicatives courantes.

Outils et utilitaires connexes

Tous les outils →
Calculateur de capacité RAID & ZFSDéveloppement

Calculez la capacité de stockage utile en To décimaux et Tio binaires pour grappes RAID 0, 1, 5, 6, 10, 50, 60 et ZFS RAIDZ1/Z2/Z3 avec surcoût de parité, risque d'erreur URE lors de la reconstruction, durée estimée et visualiseur de baies.

Ouvrir l'outil→
Taille d'échantillon & puissance A/BDéveloppement

Calculez la taille d'échantillon exacte, la puissance statistique et la durée de vos tests A/B. Résolution inverse du MDE, métriques continues, correction de Bonferroni multi-bras et détection de SRM.

Ouvrir l'outil→
Convertisseur PX en REM & REM en PXDéveloppement

Convertissez instantanément PX en REM et REM en PX avec taille de police racine personnalisée. Générez du CSS clamp() fluide, des classes Tailwind et des tables de conversion.

Ouvrir l'outil→
Vérificateur Code HTTP & RedirectionDéveloppement

Vérifiez les codes d'état HTTP, testez les chaînes de redirection et analysez les en-têtes de réponse. Diagnostiquez les erreurs 1xx à 5xx, la conformité RFC et l'impact SEO.

Ouvrir l'outil→
Testeur Regex & DébogueurDéveloppement

Testez, déboguez et optimisez vos expressions régulières en temps réel. Analysez les correspondances de motifs, les groupes de capture, l'arbre syntaxique et les substitutions.

Ouvrir l'outil→
Calculateur Sous-Réseau IP & CIDRDéveloppement

Calculez masques de sous-réseau IPv4, plages CIDR, hôtes utilisables et adresses de diffusion. Inspection binaire bit à bit, découpage VLSM et règles VPC cloud.

Ouvrir l'outil→