/
Calculadora PostgreSQL & Config PGTune
Perfil de ServidorVersão PostgreSQL

Calculadora PostgreSQL & Config PGTune

Calcule os parâmetros de memória do PostgreSQL e gere configurações postgresql.conf via PGTune. Otimize shared_buffers, work_mem, effective_cache_size e max_connections.

Predefinições Rápidas:

Especificações de Hardware

Perfil de carga da aplicação e regime de uso do banco (ex.: OLTP, DW, Web ou Misto)

GB
1 GB16 GB64 GB128 GB256 GB

Número de núcleos de CPU disponíveis, utilizado para dimensionar processos paralelos de consulta e manutenção.

Tecnologia de armazenamento dos discos de dados (ex.: NVMe, SSD SATA ou HDD)

conexões
Desativado
Conexões de Backend Ativas100
Sobrecarga Base por Conexão1000MB
Requisitos de Huge Pages4108
Diretivas recomendadas de postgresql.conf para seu ambientePostgreSQL 16 • NVMe SSD
# ----------------------------------------------------------------------
# PostgreSQL PostgreSQL 16 Performance Tuning Profile
# Generated by ToolsAA PostgreSQL Memory Calculator & PGTune Engine
# Host RAM: 32 GB | Cores: 8 | Storage: NVMe SSD
# Platform Regime: Linux Bare-Metal / VM | Workload: Web Application / High-Concurrency OLTP
# ----------------------------------------------------------------------

# ----------------------------
# Connectivity & Concurrency
# ----------------------------
max_connections = 100 # Active backend workers
superuser_reserved_connections = 3

# ----------------------------
# Memory & Cache Allocation
# ----------------------------
shared_buffers = 8GB # Hot page buffer pool
effective_cache_size = 24GB # Planner RAM estimate (Shared + OS Cache)
maintenance_work_mem = 1.6GB # Dedicated VACUUM & CREATE INDEX memory
work_mem = 98MB # Per sort/hash node memory
autovacuum_work_mem = -1 # Inherits maintenance_work_mem
huge_pages = try # Requires vm.nr_hugepages in /etc/sysctl.conf
temp_buffers = 16MB # Session-local temporary table memory

# ----------------------------
# Storage I/O & Query Planner
# ----------------------------
random_page_cost = 1.1 # Calibrated for NVMe SSD
seq_page_cost = 1.0 # Sequential disk block scan baseline
effective_io_concurrency = 300 # Prefetch asynchronous disk queues
default_statistics_target = 100 # Planner table sample resolution

# ----------------------------
# Checkpoints & WAL Journaling
# ----------------------------
checkpoint_completion_target = 0.9 # Spread checkpoint I/O over interval
checkpoint_timeout = 15min # Maximum duration between automatic checkpoints
min_wal_size = 4GB # Baseline recycled WAL buffer ring
max_wal_size = 32GB # Soft WAL ceiling before forced checkpoint
wal_buffers = 16MB # Ring buffer for unsaved WAL transactions
wal_compression = on # Lz4 or pglz compression to reduce disk I/O write amplification

# ----------------------------
# Parallel Query Execution
# ----------------------------
max_worker_processes = 8 # Maximum background and parallel workers
max_parallel_workers = 8 # Pool dedicated to parallel executor
max_parallel_workers_per_gather = 2 # Workers per single query plan node
max_parallel_maintenance_workers = 2 # Parallel index creation & VACUUM

# ----------------------------
# PostgreSQL Version-Specific Nuances
# ----------------------------
io_combine_limit = 256kB # PG16+ vectorized disk block read
track_io_timing = on # Monitor block read/write latencies
compute_query_id = on # Built-in query fingerprints for pg_stat_statements
shared_preload_libraries = 'pg_stat_statements' # Core query performance telemetry
Status do Planejador de Consultas
Consumo de Pico da RAM32.9GB
shared_buffers8GBMemória compartilhada do PostgreSQL
work_mem98MBMemória por operação de ordenação
Risco de OOM103% PeakCrítico

Processamento no Navegador

Cálculos de alta performance executados inteiramente na memória do navegador.

Zero Upload para o Servidor

Todos os dados permanecem estritamente locais, sem qualquer comunicação com servidores externos.

Exportação Pronta para Produção

Formatos de saída limpos e otimizados, prontos para implantação imediata.

As configurações sugeridas são pontos de partida baseados em heurísticas consolidadas da comunidade PostgreSQL. Valide e monitore o comportamento sob carga real antes de aplicar em ambiente de produção.
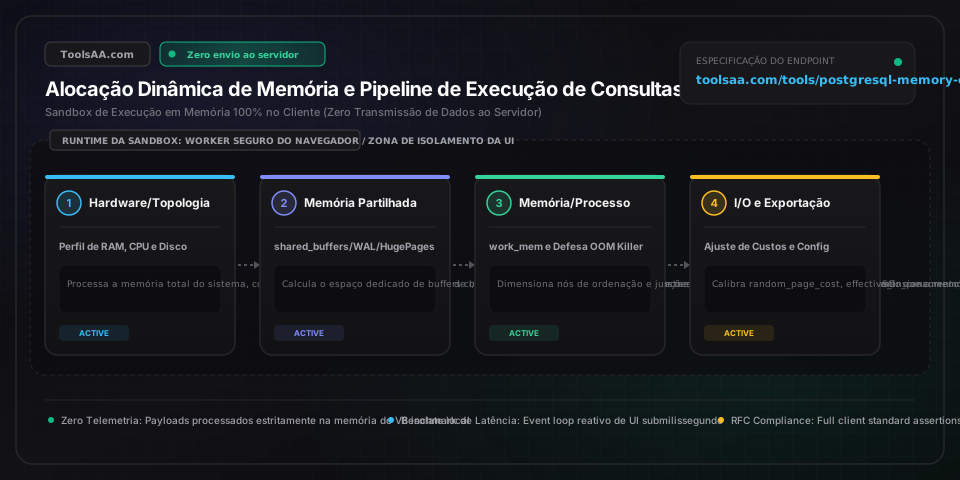
Referência técnica e guia de arquitetura

Cálculo de Memória PostgreSQL & PGTune — Guia de referência

Calcule as configurações de memória do PostgreSQL e gere parâmetros do postgresql.conf com o PGTune. Otimize shared_buffers, work_mem, effective_cache_size e max_connections.

Cálculo de Memória PostgreSQL & PGTune — Guia de referência — Arquitetura em memória do lado do cliente e fluxo de dados

Parâmetros-chave e controles

shared_buffersString de Memória (ex.: 8GB, 16GB)

Define a memória dedicada que o PostgreSQL utiliza para o cache compartilhado de dados. A proporção áurea recomendada por benchmarks é de 25% da RAM total do sistema no Linux. Configurar acima de 40% degrada o desempenho devido ao buffer duplo contra o cache de páginas do kernel Linux.

Padrão: 128MB (Padrão de fábrica do PostgreSQL)
work_memString de Memória (ex.: 32MB, 64MB)

Especifica o orçamento base de memória para operações internas de ordenação e tabelas hash antes de gravar arquivos temporários em disco. Crucialmente, esse valor é alocado por nó de ordenação/hash da consulta, e NÃO por conexão. Consultas complexas com múltiplos joins alocam work_mem várias vezes de forma simultânea.

Padrão: 4MB
effective_cache_sizeString de Memória (ex.: 24GB, 48GB)

Informa ao planejador de consultas a memória total disponível para cache de disco (shared_buffers + cache de páginas do kernel). Não aloca memória física. O valor padrão é 75% da RAM total do sistema em servidores dedicados ou 50% em servidores compartilhados.

Padrão: 4GB
maintenance_work_memString de Memória (ex.: 1GB, 2GB)

Especifica a memória máxima utilizada por operações de manutenção como VACUUM, CREATE INDEX e ALTER TABLE ADD FOREIGN KEY. O teto recomendado é min(2GB, 5% da RAM total); valores maiores aceleram a criação de índices, mas os workers do autovacuum podem esgotar a memória do host se não forem limitados.

Padrão: 64MB
max_connectionsInteiro (10 a 5000)

Determina o número máximo de conexões diretas simultâneas de clientes. Cada conexão do PostgreSQL cria um processo próprio no sistema operacional consumindo ~10MB de RAM base, além de alocações dinâmicas de work_mem. Contagens altas de conexões (>300) sem PgBouncer causam severo thrashing de cache da CPU.

Padrão: 100
checkpoint_completion_targetPonto Flutuante Decimal (0.1 a 1.0)

Fração do intervalo de checkpoint durante a qual as páginas modificadas (dirty buffers) devem ser gravadas em disco. O padrão de referência é 0.9 (90%), suavizando picos de I/O de escrita ao longo da janela de checkpoint para eliminar travamentos e latência de I/O.

Padrão: 0.9 (a partir do PG 14; 0.5 em versões legadas)
wal_buffersString de Memória (ex.: 16MB, 64MB)

Memória alocada para dados do write-ahead log (WAL) antes da gravação em disco. Dimensionada automaticamente para 3% de shared_buffers até um limite de 16MB, ou 64MB para cargas de trabalho com ingestão massiva e intensa escrita.

Padrão: -1 (ajustado automaticamente para 3% de shared_buffers)
random_page_costPonto Flutuante Decimal (1.0 a 10.0)

Estimativa do planejador para leitura de páginas não sequenciais em disco em relação a varreduras sequenciais (seq_page_cost = 1.0). Configure como 1.1 para SSDs NVMe e 1.5 para SSDs SATA; manter o padrão de 4.0 de HDDs mecânicos faz o planejador favorecer erroneamente varreduras sequenciais em vez de varreduras por índice.

Padrão: 4.0
effective_io_concurrencyInteiro (0 a 1000)

Número de operações assíncronas simultâneas de I/O em disco que o subsistema de armazenamento subjacente pode processar ao mesmo tempo. O valor ideal é de 200 a 300 para SSDs NVMe/SATA, enquanto discos rígidos mecânicos rotacionais devem permanecer em 2.

Padrão: 1 (Padrão no Linux; 0 desativa o prefetch)
huge_pagesEnum ('on', 'off', 'try')

Controla se o shared_buffers requisita HugePages de 2MB do Linux. O uso de HugePages elimina perdas no Translation Lookaside Buffer (TLB) em servidores com mais de 32GB de RAM, evitando o inchaço da tabela de páginas na memória e reduzindo o overhead de acesso à memória pela CPU em até 15%.

Padrão: try

Dicas profissionais e melhores práticas

A Armadilha do Multiplicador de work_mem em Consultas com Múltiplos Joins

Nunca calcule o pico de consumo de memória simplesmente multiplicando max_connections por work_mem. Uma única consulta SQL complexa com 4 hash joins, 2 operações de ordenação (sort) e uma função de janela (window function) pode alocar work_mem 7 vezes simultaneamente em um único processo backend. Se max_connections for 200 e work_mem for 64MB, o pior cenário de consumo não será 12,8GB, mas mais de 89GB, o que desencadeia a terminação imediata pelo OOM Killer do Linux.

Por Que shared_buffers Acima de 40% Degrada o Desempenho

O PostgreSQL não utiliza direct I/O por padrão; ele lê páginas através do cache do kernel do sistema operacional. Definir shared_buffers entre 60% e 80% da RAM gera um buffer duplo massivo, no qual páginas idênticas residem simultaneamente nos shared buffers do PostgreSQL e no page cache do Linux. Deixar de 50% a 75% da RAM livre para o cache do SO permite que o Linux faça cache de arquivos de índice e temporários de forma muito mais eficiente.

Blindando o vm.overcommit_memory no Linux para Evitar a Morte do Postmaster

Por padrão, o Linux utiliza overcommit heurístico de memória (vm.overcommit_memory = 0). Quando a RAM física e a swap se esgotam, o OOM Killer do Linux seleciona e encerra o processo com maior pontuação de 'badness', que quase sempre é o processo postmaster do PostgreSQL. Em produção, configure vm.overcommit_memory = 2 e vm.overcommit_ratio = 80 junto com HugePages pré-alocadas para eliminar completamente travamentos por falta de memória.

O Precipício do Pool de Conexões: Por Que 1.000 Conexões Diretas Destroem a Vazão

Como o PostgreSQL utiliza uma arquitetura de processo por conexão, executar 1.000 conexões diretas ativas força a CPU a gastar mais de 40% dos seus ciclos em trocas de contexto no sistema operacional e invalidações de linhas de cache L1/L2/L3. Implementar o PgBouncer em modo de pooling por transação com pool_size = 2 * Núcleos_CPU + Discos (ex.: 32 a 64 conexões backend) aumenta a vazão geral de consultas em 300% a 500%, reduzindo a zero o overhead de memória ociosa.

Ajustando a Frequência de Checkpoint para Evitar Travamentos de Escrita em Disco

Se o PostgreSQL gerar um volume elevado de escrita por transações, o padrão de 1GB para max_wal_size fará checkpoints serem disparados a cada poucos segundos em vez de respeitar o checkpoint_timeout. Aumente max_wal_size para 16GB ou 32GB em SSDs modernos e garanta que checkpoint_completion_target esteja explicitamente configurado em 0.9. Isso distribui o I/O de disco uniformemente ao longo de 90% da janela do checkpoint, prevenindo gargalos repentinos de escrita.

Armadilhas comuns e solução de problemas

⚠️Out of memory: Killed process (postmaster) pelo Linux kernel OOM Killer

Reduza o work_mem imediatamente ou diminua max_connections. Implemente um pool de conexões (PgBouncer) para que as conexões de clientes não criem consumidores ilimitados de memória no backend. Configure vm.overcommit_memory = 2 no /etc/sysctl.conf e garanta que o espaço de swap seja dimensionado para pelo menos 50% da RAM como margem de segurança de emergência.

⚠️FATAL: could not attach to shared memory segment: Cannot allocate memory

Esse erro ocorre quando shared_buffers excede os limites de shmmax ou de HugePages do kernel. Se huge_pages = on, execute 'grep Huge /proc/meminfo' para confirmar se HugePages_Free >= ceil(shared_buffers / 2048kB). Como alternativa, defina huge_pages = try ou atualize o /etc/sysctl.conf com 'vm.nr_hugepages = [valor_calculado]' seguido de 'sysctl -p'.

⚠️PostgreSQL ignora índices em SSDs e executa varreduras sequenciais lentas nas tabelas

O valor padrão de random_page_cost é 4.0, calibrado originalmente para discos rígidos mecânicos, onde buscas aleatórias são 4 vezes mais lentas que leituras sequenciais. Em SSDs NVMe e SATA, leituras aleatórias têm custo mecânico praticamente nulo. Defina random_page_cost = 1.1 (NVMe) ou 1.5 (SSD SATA) no postgresql.conf e execute 'SELECT pg_reload_conf();' para restaurar instantaneamente a prioridade de varreduras por índice.

⚠️Picos periódicos de latência nas consultas a cada 5 a 15 minutos

Causado por descargas agressivas de checkpoint que gravam dirty buffers todos de uma vez. Verifique os logs do PostgreSQL em busca de 'checkpoints are occurring too frequently'. Defina checkpoint_completion_target = 0.9 para suavizar o I/O de escrita, aumente max_wal_size de 1GB para 16GB+ e aumente checkpoint_timeout para 15min ou 30min.

⚠️Alta utilização de CPU com centenas de conexões em estado 'idle in transaction'

Conexões diretas de clientes consomem ~10MB de memória residente cada uma, mesmo ociosas, retendo snapshots de transação e locks de memória. Implante o PgBouncer em modo de pooling por transação. Adicione idle_in_transaction_session_timeout = '60s' no postgresql.conf para encerrar automaticamente transações órfãs de clientes.

Perguntas frequentes (FAQ)

Como o work_mem é calculado para evitar o Linux OOM Killer?▼

O work_mem é calculado pela fórmula: work_mem = ((RAM_Total - shared_buffers) * (1 - Taxa_Reserva_SO)) / (max_connections * nos_ordenacao_simultaneos_por_consulta), onde a Taxa_Reserva_SO é tipicamente 0.20 (20%) e os nós de ordenação simultâneos são 2 para OLTP ou de 4 a 8 para OLAP. Como o work_mem é alocado por operação de ordenação/hash e não por conexão, manter o work_mem entre 16MB e 64MB em cargas OLTP evita que consultas com múltiplos joins esgotem a memória RAM do sistema e acionem o Linux Out-of-Memory (OOM) Killer.

Qual é o tamanho recomendado de shared_buffers para 16GB, 32GB ou 64GB de RAM?▼

A configuração recomendada de shared_buffers no Linux é de 25% da memória RAM total do sistema: 4GB para um servidor de 16GB, 8GB para um servidor de 32GB e 16GB para um servidor de 64GB. Embora o PostgreSQL suporte valores de até 40% da RAM, configurar shared_buffers acima desse patamar raramente traz ganhos de performance e com frequência causa severa degradação devido ao buffer duplo com o cache de páginas do kernel do sistema operacional.

Qual é a diferença entre shared_buffers e effective_cache_size?▼

O shared_buffers aloca memória física real durante a inicialização do PostgreSQL para armazenar páginas compartilhadas de tabelas e índices em cache. Em contrapartida, o effective_cache_size não aloca nenhuma memória física; trata-se de uma métrica puramente informativa utilizada pelo planejador de consultas para estimar quanto dado provavelmente está em cache na soma de shared_buffers com o page cache do sistema operacional. A boa prática é definir effective_cache_size entre 50% e 75% da RAM total do host.

Por que o PostgreSQL cai por falta de memória mesmo quando parece haver RAM livre?▼

O PostgreSQL cai por falta de memória (Out of Memory) quando a memória solicitada pelas consultas do backend excede o limite de overcommit do kernel ou quando a fragmentação de memória impede a alocação de segmentos contíguos de memória compartilhada. Além disso, se o overcommit do Linux estiver em modo heurístico padrão (vm.overcommit_memory = 0), o kernel permite que processos aloquem mais memória virtual do que existe fisicamente; quando essas páginas recebem escrita real, o OOM Killer envia abruptamente um SIGKILL ao processo postmaster, derrubando todo o cluster do banco de dados.

Quantas max_connections devo configurar no PostgreSQL?▼

As conexões diretas em max_connections devem, idealmente, ser restritas a um intervalo de 100 a 200. Como o PostgreSQL utiliza um processo dedicado do sistema operacional para cada conexão, ter mais de 200 a 300 conexões diretas ativas introduz intensa troca de contexto de CPU e disputa de locks. Para aplicações que exigem centenas ou milhares de conexões simultâneas de clientes, utilize um gerenciador de pool de conexões como o PgBouncer em modo transacional com pool_size configurado para (2 * Núcleos_CPU + Discos), permitindo que milhares de sessões compartilhem de 20 a 50 backends ativos no banco de dados.

Devo ativar HugePages no Linux para o PostgreSQL?▼

Sim, HugePages devem sempre ser ativadas em bancos de dados de produção com 32GB de RAM ou mais. As páginas de memória padrão da arquitetura x86_64 no Linux possuem 4KB, exigindo milhões de entradas na tabela de páginas para shared_buffers grandes, o que infla o consumo de memória da CPU e provoca perdas de cache no Translation Lookaside Buffer (TLB). As HugePages de 2MB do Linux reduzem o overhead da tabela de páginas em 512 vezes, proporcionando de 5% a 15% mais vazão nas consultas e eliminando falhas de alocação de memória compartilhada.

Qual random_page_cost devo usar para armazenamento NVMe e SSD?▼

Configure random_page_cost como 1.1 para SSDs NVMe e 1.5 para SSDs SATA, em comparação ao seq_page_cost base de 1.0. O valor padrão de 4.0 foi estabelecido décadas atrás para discos magnéticos rotacionais, que sofriam com alta latência mecânica de busca. Manter 4.0 em armazenamento SSD faz o planejador de consultas do PostgreSQL superestimar o custo de buscas por índice e executar erroneamente varreduras sequenciais completas na tabela (seq scans).

Qual é a diferença entre maintenance_work_mem e autovacuum_work_mem?▼

O maintenance_work_mem determina a memória alocada para tarefas administrativas manuais como CREATE INDEX e VACUUM FULL, geralmente definido entre 1GB e 2GB. Já o autovacuum_work_mem limita especificamente a memória alocada para cada processo worker de autovacuum em segundo plano. Se autovacuum_work_mem for mantido em -1, cada worker utilizará o valor de maintenance_work_mem; com autovacuum_max_workers = 3, três workers simultâneos consumiriam 6GB de RAM, gerando risco de esgotamento do sistema. Definir autovacuum_work_mem explicitamente (ex.: 512MB) protege as operações normais de consulta.

Ferramentas e utilitários relacionados

Todas as ferramentas →