/
Calculadora Memoria PostgreSQL & PGTune
Perfil de cargaVersión de PostgreSQL

Calculadora Memoria PostgreSQL & PGTune

Calcula la memoria para PostgreSQL y genera parámetros de postgresql.conf con PGTune. Optimiza shared_buffers, work_mem, effective_cache_size y max_connections.

Perfiles rápidos:

Especificaciones de hardware

Perfil de carga y entorno operativo (Web, OLTP, DW o Mixto)

GB
1 GB16 GB64 GB128 GB256 GB

Número de núcleos de CPU lógicos o vCPUs disponibles para el motor PostgreSQL.

Tipo de medio de almacenamiento del host (SSD, NVMe, HDD o SAN)

conexiones
Desactivado
Conexiones backend activas100
Sobrecarga base por proceso1000MB
Requerimiento de Huge Pages4108
Directivas optimizadas para postgresql.confPostgreSQL 16 • NVMe SSD
# ----------------------------------------------------------------------
# PostgreSQL PostgreSQL 16 Performance Tuning Profile
# Generated by ToolsAA PostgreSQL Memory Calculator & PGTune Engine
# Host RAM: 32 GB | Cores: 8 | Storage: NVMe SSD
# Platform Regime: Linux Bare-Metal / VM | Workload: Web Application / High-Concurrency OLTP
# ----------------------------------------------------------------------

# ----------------------------
# Connectivity & Concurrency
# ----------------------------
max_connections = 100 # Active backend workers
superuser_reserved_connections = 3

# ----------------------------
# Memory & Cache Allocation
# ----------------------------
shared_buffers = 8GB # Hot page buffer pool
effective_cache_size = 24GB # Planner RAM estimate (Shared + OS Cache)
maintenance_work_mem = 1.6GB # Dedicated VACUUM & CREATE INDEX memory
work_mem = 98MB # Per sort/hash node memory
autovacuum_work_mem = -1 # Inherits maintenance_work_mem
huge_pages = try # Requires vm.nr_hugepages in /etc/sysctl.conf
temp_buffers = 16MB # Session-local temporary table memory

# ----------------------------
# Storage I/O & Query Planner
# ----------------------------
random_page_cost = 1.1 # Calibrated for NVMe SSD
seq_page_cost = 1.0 # Sequential disk block scan baseline
effective_io_concurrency = 300 # Prefetch asynchronous disk queues
default_statistics_target = 100 # Planner table sample resolution

# ----------------------------
# Checkpoints & WAL Journaling
# ----------------------------
checkpoint_completion_target = 0.9 # Spread checkpoint I/O over interval
checkpoint_timeout = 15min # Maximum duration between automatic checkpoints
min_wal_size = 4GB # Baseline recycled WAL buffer ring
max_wal_size = 32GB # Soft WAL ceiling before forced checkpoint
wal_buffers = 16MB # Ring buffer for unsaved WAL transactions
wal_compression = on # Lz4 or pglz compression to reduce disk I/O write amplification

# ----------------------------
# Parallel Query Execution
# ----------------------------
max_worker_processes = 8 # Maximum background and parallel workers
max_parallel_workers = 8 # Pool dedicated to parallel executor
max_parallel_workers_per_gather = 2 # Workers per single query plan node
max_parallel_maintenance_workers = 2 # Parallel index creation & VACUUM

# ----------------------------
# PostgreSQL Version-Specific Nuances
# ----------------------------
io_combine_limit = 256kB # PG16+ vectorized disk block read
track_io_timing = on # Monitor block read/write latencies
compute_query_id = on # Built-in query fingerprints for pg_stat_statements
shared_preload_libraries = 'pg_stat_statements' # Core query performance telemetry
Estado del planificador
Consumo pico de RAM32.9GB
Búferes compartidos8GBCaché de datos recomendada (~25% de RAM)
Memoria de trabajo98MBLímite por operación de ordenación y hash
Riesgo de OOM103% PeakCrítico

Procesamiento en el cliente

Cálculo de alto rendimiento ejecutado íntegramente en la memoria del navegador.

Sin envío de datos al servidor

Todos los datos permanecen estrictamente en local, sin comunicación con servidores externos.

Exportación para producción

Configuración optimizada y lista para su despliegue inmediato en producción.

Recomendaciones basadas en las mejores prácticas de la comunidad de PostgreSQL y PGTune. Valida siempre en un entorno de pruebas antes de desplegar en producción.
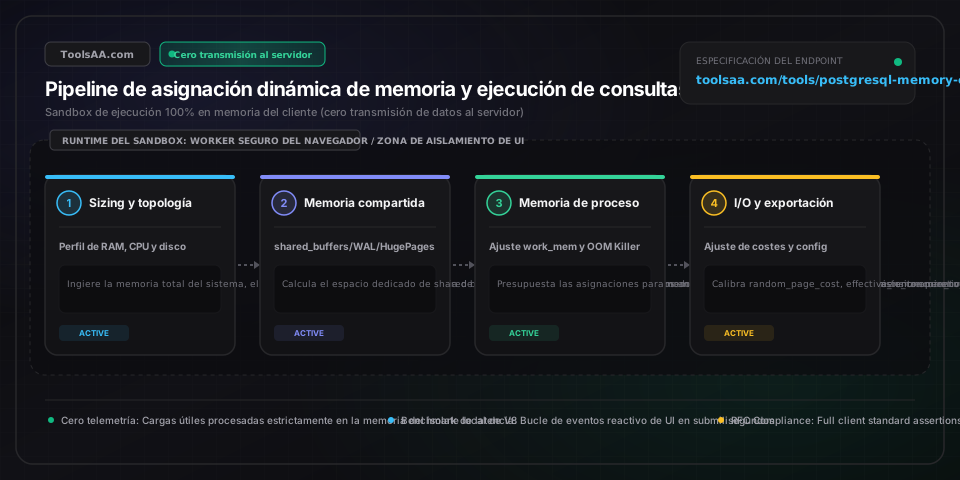
Referencia técnica y guía de arquitectura

Calculadora Memoria PostgreSQL & PGTune — Guía de referencia

Calcula la configuración de memoria en PostgreSQL y genera parámetros de postgresql.conf con PGTune. Optimiza shared_buffers, work_mem, effective_cache_size y max_connections.

Calculadora Memoria PostgreSQL & PGTune — Guía de referencia — Arquitectura en memoria del lado del cliente y flujo de datos

Parámetros clave y controles

shared_buffersCadena de memoria (p. ej., 8GB, 16GB)

Define la memoria dedicada que utiliza PostgreSQL para la caché compartida de datos. La proporción dorada de referencia es el 25% de la RAM total del sistema en Linux. Superar el 40% degrada el rendimiento debido al doble almacenamiento en búfer frente a la caché de páginas del kernel de Linux.

Por defecto: 128MB (ajuste predeterminado de fábrica de PostgreSQL)
work_memCadena de memoria (p. ej., 32MB, 64MB)

Especifica el presupuesto de memoria base para operaciones internas de ordenación y tablas hash antes de escribir en archivos temporales en disco. De forma crucial, se asigna por cada nodo de ordenación/hash de la consulta, NO por conexión. Las consultas complejas con múltiples joins asignan work_mem varias veces en simultáneo.

Por defecto: 4MB
effective_cache_sizeCadena de memoria (p. ej., 24GB, 48GB)

Informa al planificador de consultas sobre la memoria total disponible para caché de disco (shared_buffers + caché de páginas del kernel). No asigna memoria física. El valor estándar es el 75% de la RAM total en servidores dedicados o el 50% en servidores compartidos.

Por defecto: 4GB
maintenance_work_memCadena de memoria (p. ej., 1GB, 2GB)

Determina la memoria máxima utilizada por operaciones de mantenimiento como VACUUM, CREATE INDEX y ALTER TABLE ADD FOREIGN KEY. El límite recomendado es min(2GB, 5% de la RAM total); valores mayores aceleran la creación de índices, pero los procesos de autovacuum pueden agotar la memoria del host si no se regulan.

Por defecto: 64MB
max_connectionsEntero (10 a 5000)

Determina el número máximo de conexiones directas simultáneas de clientes. Cada conexión en PostgreSQL genera un proceso independiente del SO que consume ~10MB de RAM base más asignaciones dinámicas de work_mem. Un volumen alto de conexiones (>300) sin PgBouncer provoca una degradación severa por saturación de la caché de CPU (cache thrashing).

Por defecto: 100
checkpoint_completion_targetFlotante decimal (0.1 a 1.0)

Fracción del intervalo de checkpoint durante la cual las páginas sucias de los búferes compartidos deben vaciarse a disco. El estándar de referencia es 0.9 (90%), lo que suaviza los picos de E/S de escritura a lo largo del intervalo de control para eliminar interrupciones de E/S.

Por defecto: 0.9 (desde PG 14; 0.5 en versiones heredadas)
wal_buffersCadena de memoria (p. ej., 16MB, 64MB)

Memoria asignada para almacenar datos del registro de escritura previa (WAL) antes de vaciarlos a disco. Se escala automáticamente al 3% de shared_buffers hasta un tope de 16MB, o 64MB para cargas de trabajo con ingesta masiva de escritura intensiva.

Por defecto: -1 (autoajustado al 3% de shared_buffers)
random_page_costFlotante decimal (1.0 a 10.0)

Estimación del planificador para lecturas de páginas de disco no secuenciales respecto a los escaneos secuenciales (seq_page_cost = 1.0). Establece 1.1 para SSD NVMe y 1.5 para SSD SATA; mantener el valor predeterminado de 4.0 para discos mecánicos hace que el planificador priorice erróneamente escaneos secuenciales sobre escaneos de índices.

Por defecto: 4.0
effective_io_concurrencyEntero (0 a 1000)

Número de operaciones asíncronas de E/S de disco simultáneas que el subsistema de almacenamiento subyacente puede gestionar en paralelo. El valor óptimo es de 200 a 300 para SSD NVMe/SATA, mientras que los discos mecánicos tradicionales deben mantenerse en 2.

Por defecto: 1 (predeterminado en Linux; 0 desactiva prefetch)
huge_pagesEnum ('on', 'off', 'try')

Controla si shared_buffers solicita HugePages de 2MB en Linux. El uso de HugePages elimina los fallos en el Translation Lookaside Buffer (TLB) en servidores con >32GB de RAM, evitando la sobrecarga de memoria en las tablas de páginas y reduciendo la latencia de acceso a memoria de la CPU hasta en un 15%.

Por defecto: try

Consejos profesionales y mejores prácticas

La trampa del multiplicador de work_mem en consultas con múltiples joins

Nunca calcules el consumo pico de memoria multiplicando simplemente max_connections por work_mem. Una sola consulta SQL compleja con 4 hash joins, 2 operaciones de ordenación y una función de ventana puede asignar work_mem 7 veces en simultáneo dentro de un único proceso de backend. Si max_connections es 200 y work_mem es 64MB, el consumo en el peor de los casos no es de 12.8GB, sino de más de 89GB, lo que desencadena la terminación inmediata por el OOM Killer de Linux.

Por qué configurar shared_buffers por encima del 40% degrada el rendimiento

PostgreSQL no utiliza E/S directa (Direct I/O) por defecto; lee las páginas a través de la caché del kernel del sistema operativo. Configurar shared_buffers al 60-80% de la RAM genera un doble almacenamiento en búfer masivo, donde páginas idénticas residen tanto en los búferes compartidos de PostgreSQL como en la page cache de Linux. Dejar entre el 50% y el 75% de la RAM libre para la caché del SO permite a Linux gestionar en caché archivos de índices y archivos temporales con mucha mayor eficiencia.

Blindaje de vm.overcommit_memory en Linux para evitar la caída del proceso postmaster

Por defecto, Linux utiliza sobreasignación heurística de memoria (vm.overcommit_memory = 0). Cuando la RAM física y la swap se agotan, el OOM Killer de Linux selecciona y termina el proceso con la puntuación de penalización (badness score) más alta, que casi siempre resulta ser el proceso postmaster de PostgreSQL. En entornos de producción, configura vm.overcommit_memory = 2 y vm.overcommit_ratio = 80 junto con HugePages preasignadas para garantizar tolerancia cero a caídas por falta de memoria.

El abismo del pooling de conexiones: por qué 1.000 conexiones directas destruyen el rendimiento

Debido a que PostgreSQL utiliza una arquitectura de proceso por conexión, mantener 1.000 conexiones directas activas obliga a la CPU a gastar más del 40% de sus ciclos en cambios de contexto de procesos del SO e invalidación de líneas de caché L1/L2/L3. Implementar PgBouncer en modo de pooling por transacción con pool_size = 2 * núcleos_CPU + discos (p. ej., 32-64 conexiones de backend) incrementa el rendimiento global de consultas entre un 300% y un 500%, reduciendo a cero el sobrecoste de memoria en conexiones inactivas.

Ajuste de la frecuencia de checkpoints para prevenir bloqueos de escritura en disco

Si PostgreSQL procesa un volumen elevado de escrituras transaccionales, el valor predeterminado de max_wal_size (1GB) provocará checkpoints cada pocos segundos en lugar de respetar checkpoint_timeout. Incrementa max_wal_size a 16GB o 32GB en SSDs modernos y asegúrate de fijar checkpoint_completion_target explícitamente en 0.9. Esto distribuye la E/S a disco uniformemente a lo largo del 90% de la duración del checkpoint, evitando cuellos de botella repentinos en escritura.

Problemas comunes y soluciones

⚠️Out of memory: Killed process (postmaster) por el OOM Killer del kernel de Linux

Reduce work_mem de inmediato o disminuye max_connections. Implementa un pool de conexiones (PgBouncer) para evitar que las conexiones de clientes generen consumidores ilimitados de memoria en el backend. Configura vm.overcommit_memory = 2 en /etc/sysctl.conf y asegúrate de disponer de un espacio swap dimensionado al menos al 50% de la RAM como colchón de seguridad de emergencia.

⚠️FATAL: could not attach to shared memory segment: Cannot allocate memory

Este error ocurre cuando shared_buffers excede los límites de shmmax o HugePages del kernel. Si huge_pages = on, verifica con 'grep Huge /proc/meminfo' que HugePages_Free >= ceil(shared_buffers / 2048kB). Como alternativa, establece huge_pages = try, o actualiza /etc/sysctl.conf con 'vm.nr_hugepages = [valor_calculado]' seguido del comando 'sysctl -p'.

⚠️PostgreSQL ignora los índices en discos SSD y ejecuta escaneos secuenciales lentos

El valor predeterminado de random_page_cost es 4.0, calibrado originalmente para discos duros mecánicos donde las búsquedas aleatorias son 4 veces más lentas que las lecturas secuenciales. En SSDs NVMe y SATA, las búsquedas aleatorias no tienen penalización mecánica. Configura random_page_cost = 1.1 (NVMe) o 1.5 (SSD SATA) en postgresql.conf y ejecuta 'SELECT pg_reload_conf();' para restablecer de inmediato la prioridad de escaneo por índices.

⚠️Picos periódicos de latencia en consultas cada 5 a 15 minutos

Originado por escrituras agresivas de checkpoints que vacían búferes sucios de golpe. Revisa los logs de PostgreSQL buscando la advertencia 'checkpoints are occurring too frequently'. Configura checkpoint_completion_target = 0.9 para amortiguar la E/S de escritura, incrementa max_wal_size de 1GB a 16GB o más, y aumenta checkpoint_timeout a 15min o 30min.

⚠️Alto uso de CPU con cientos de conexiones en estado 'idle in transaction'

Las conexiones directas de clientes consumen ~10MB de memoria residente cada una incluso inactivas, reteniendo instantáneas de transacciones y bloqueos en memoria. Despliega PgBouncer en modo de pooling por transacción. Añade idle_in_transaction_session_timeout = '60s' en postgresql.conf para terminar automáticamente las transacciones huérfanas de clientes.

Preguntas frecuentes (FAQ)

¿Cómo se calcula work_mem para evitar el OOM killer de Linux?▼

work_mem se calcula mediante la fórmula: work_mem = ((RAM_Total - shared_buffers) * (1 - Ratio_Reserva_SO)) / (max_connections * nodos_ordenacion_simultaneos_por_consulta), donde Ratio_Reserva_SO es habitualmente 0.20 (20%) y nodos_ordenacion_simultaneos es 2 para OLTP o de 4 a 8 para OLAP. Dado que work_mem se asigna por cada operación de ordenación/hash y no por conexión, mantener work_mem entre 16MB y 64MB en OLTP evita que las consultas con múltiples joins agoten la RAM del sistema y activen el Out-of-Memory (OOM) killer de Linux.

¿Cuál es el tamaño recomendado de shared_buffers para 16GB, 32GB o 64GB de RAM?▼

El ajuste recomendado de shared_buffers en Linux es el 25% de la RAM total del sistema: 4GB para un servidor con 16GB, 8GB para 32GB y 16GB para 64GB de RAM. Aunque PostgreSQL admite valores de hasta el 40% de la RAM, asignar más del 40% rara vez aporta mejoras de rendimiento y a menudo provoca una degradación severa por el doble almacenamiento en búfer frente a la caché de páginas del kernel del sistema operativo.

¿Cuál es la diferencia entre shared_buffers y effective_cache_size?▼

shared_buffers asigna memoria física real al iniciar PostgreSQL para almacenar en caché las páginas compartidas de tablas e índices. En contraste, effective_cache_size no reserva memoria física alguna; es simplemente una métrica de referencia que utiliza el planificador de consultas para estimar cuánto volumen de datos se encuentra probablemente en caché entre shared_buffers y la caché de páginas del sistema operativo combinadas. La práctica estándar consiste en fijar effective_cache_size entre el 50% y el 75% de la RAM total del host.

¿Por qué se cae PostgreSQL por falta de memoria incluso cuando parece haber RAM libre?▼

PostgreSQL se bloquea por falta de memoria (Out of Memory) cuando la memoria solicitada por las consultas del backend sobrepasa el límite de sobreasignación del kernel o cuando la fragmentación de memoria impide asignar segmentos contiguos de memoria compartida. Además, si la sobreasignación de memoria de Linux está activa (vm.overcommit_memory = 0), el kernel permite a los procesos solicitar más memoria virtual de la físicamente disponible; cuando se escriben esas páginas, el OOM Killer ejecuta abruptamente una señal SIGKILL contra el proceso postmaster, provocando la caída de todo el clúster de base de datos.

¿Cuántas max_connections debo configurar en PostgreSQL?▼

Las conexiones directas (max_connections) deben limitarse idealmente entre 100 y 200. Dado que PostgreSQL crea un proceso dedicado del sistema operativo por cada conexión, superar las 200 o 300 conexiones directas activas genera una sobrecarga masiva por cambios de contexto de CPU y contención de bloqueos. Para aplicaciones que requieren cientos o miles de conexiones simultáneas, utiliza un gestor de pooling como PgBouncer en modo de transacción con pool_size configurado en (2 * núcleos_CPU + cantidad_discos), permitiendo que miles de sesiones compartan entre 20 y 50 backends activos en la base de datos.

¿Debería habilitar HugePages en Linux para PostgreSQL?▼

Sí, HugePages debe activarse siempre en bases de datos de producción con 32GB de RAM o más. Las páginas de memoria estándar en arquitecturas x86_64 de Linux son de 4KB, lo que exige millones de entradas en la tabla de páginas para configuraciones grandes de shared_buffers, inflando el consumo de memoria y provocando fallos en el Translation Lookaside Buffer (TLB). Las HugePages de 2MB reducen la sobrecarga de la tabla de páginas por un factor de 512, proporcionando entre un 5% y un 15% más de rendimiento en consultas y eliminando bloqueos por asignación de memoria compartida.

¿Qué valor de random_page_cost debo utilizar para almacenamiento NVMe y SSD?▼

Establece random_page_cost en 1.1 para SSD NVMe y en 1.5 para SSD SATA, frente al valor de referencia de seq_page_cost fijado en 1.0. El valor predeterminado de 4.0 se calibró hace décadas para discos mecánicos que padecían una alta latencia de búsqueda mecánica. Conservar 4.0 en discos SSD hace que el planificador de consultas de PostgreSQL sobreestime el coste de búsqueda en índices y ejecute erróneamente escaneos secuenciales completos de tablas.

¿Cuál es la diferencia entre maintenance_work_mem y autovacuum_work_mem?▼

maintenance_work_mem establece la memoria asignada a tareas administrativas manuales como CREATE INDEX y VACUUM FULL, configurándose habitualmente entre 1GB y 2GB. Por su parte, autovacuum_work_mem limita de forma específica la memoria de cada proceso worker de autovacuum en segundo plano. Si autovacuum_work_mem se mantiene en -1, cada worker adopta el valor de maintenance_work_mem; con autovacuum_max_workers = 3, tres workers simultáneos consumirían 6GB de RAM, arriesgando el agotamiento del sistema. Definir autovacuum_work_mem de manera explícita (p. ej., 512MB) protege la operatividad de las consultas habituales.

Herramientas y utilidades relacionadas

Todas las herramientas →
Calculadora de Capacidad RAID & ZFSDesarrollo

Calcula la capacidad de almacenamiento útil en TB decimales y TiB binarios para configuraciones RAID 0, 1, 5, 6, 10, 50, 60 y ZFS RAIDZ1/Z2/Z3, con sobrecarga de paridad, riesgo de fallo por URE en reconstrucción, tiempo estimado y visualizador de bahías.

Abrir herramienta→
Calculadora Tamaño de Muestra Test A/BDesarrollo

Calcula el tamaño exacto de muestra para tests A/B, la potencia estadística y la duración de la prueba. Incluye resolución inversa de MDE, métricas continuas, corrección de Bonferroni y SRM.

Abrir herramienta→
Conversor PX a REM y REM a PXDesarrollo

Convierte PX a REM y REM a PX al instante con tamaño base personalizable. Genera tipografía fluida con clamp() en CSS, clases de Tailwind y tablas de conversión.

Abrir herramienta→
Comprobador de Códigos HTTP & RedirectsDesarrollo

Comprueba códigos de estado HTTP, analiza cadenas de redirección e inspecciona cabeceras de respuesta. Diagnostica errores de 1xx a 5xx, normas RFC, impacto en SEO y soluciones.

Abrir herramienta→
Probador Regex & Depurador RegExpDesarrollo

Prueba, depura y optimiza expresiones regulares en tiempo real. Inspecciona coincidencias de patrones, grupos de captura, desglose de tokens y sintaxis de sustitución.

Abrir herramienta→
Calculadora de Subredes IP & CIDRDesarrollo

Calcule máscaras de subred IPv4, rangos de red CIDR, direcciones de host utilizables e IP de broadcast. Incluye inspección binaria bit a bit, planificación VLSM y reglas de VPC en la nube.

Abrir herramienta→