/
Calculadora de Recursos Kubernetes
Categoria

Calculadora Kubernetes & Pod Sizing

Calculadora interativa de recursos Kubernetes (dimensionamento de CPU e memória para pods) com análise e visualização em tempo real no navegador.

Mecanismo QoS
Reservas da Nuvem
Predefinições de Carga
Modo Operacional

Perfilador de Cargas de Trabalho

CPU Base
450m (0.45 cores)
Modelos Rápidos
Memória Base
1,536 MiB (1.50 GiB)
Modelos Rápidos
Estratégia de QoS
Burstable
Razão Limit/Request de CPU2.00x
Buffer de Limite de Memória+25%
Provedor de Nuvem
Máximo de Pods por Nó
CPU do DaemonSet
Memória do DaemonSet
Requests Totais do Pod: 563m / 1,920Mi
6 Total de Pods
Nós Necessários1nósm6i.xlarge
Requests do Pod563m CPU1,920 MiB RAM
Classe QoS AtribuídaBurstableadj: 883
Custo Mensal Estimado$140.16730 Horas por Mês
Capacidade Alocável por Nó
4 vCPU / 16 GiB Raw
Alocação de CPU (Total: 4000m)Alocável: 3670m (91.8%)
Kube-Reserved: 80mDaemonSet Overhead: 250mWorkload Pods: 3378mCapacidade Ociosa (Slack)
kube-reserved (80m)DaemonSet (250m)Workloads de Pods (3378m)Capacidade Ociosa (Slack)
Distribuição de Memória Alocável (Total: 16384 MiB)Alocável: 13022 MiB (79.5%)
Kube-Reserved RAM: 2762MiBDaemonSet RAM: 600MiBWorkload RAM: 11520MiBCapacidade Ociosa (Slack)
kube-reserved (2762 MiB)DaemonSet (600 MiB)Workloads de Pods (11520 MiB)Capacidade Ociosa (Slack)
Diagnóstico de Dimensionamento
GargaloBalanced / Density Aligned
Status do CFSModerate (Burst headroom available)
Comportamento de EvicçãoMedium (Protected up to request ceiling)
Status da Execução da AST
Formato de Exportação: VISUALIZER
Métrica Principal
3.38 Unidade de vCPUs / 11.25 GiB RAM
6 Réplicas Ativas
Eficiência / Capacidade
92.0% Cores / 88.5% Unidade de RAM
Balanced / Density Aligned
Resultado Líquido
$140.16
1 nós de m6i.xlarge

Processamento no Cliente

Cálculo de alto desempenho executado inteiramente na memória do navegador.

Privacidade Sem Envio a Servidores

Todos os dados permanecem estritamente locais, sem nenhuma comunicação com servidores externos.

Exportação Pronta para Produção

Formatos de saída limpos e otimizados, prontos para implantação imediata.

Referência técnica e guia de arquitetura

Calculadora Kubernetes & Pod Sizing — Guia de referência

Calculadora interativa de recursos Kubernetes (dimensionamento de CPU e memória de pods) com análise e visualização em tempo real diretamente no navegador.

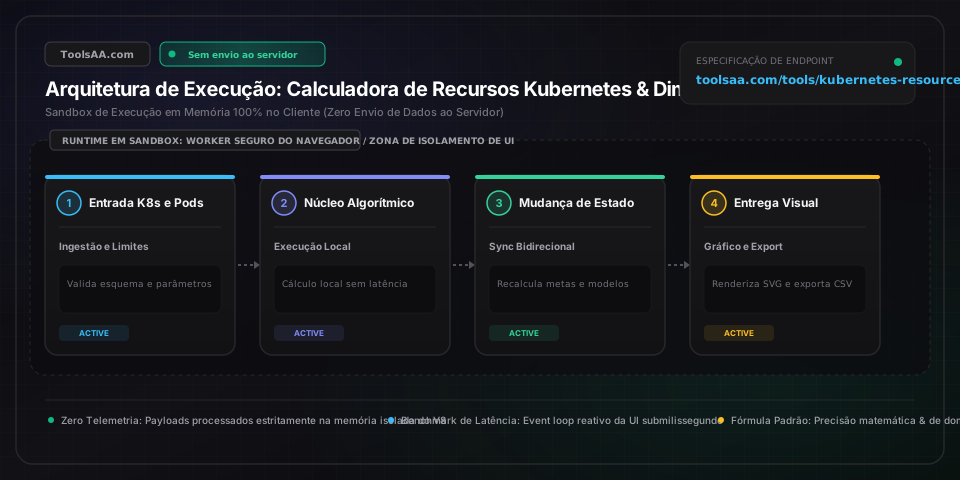
Calculadora Kubernetes & Pod Sizing — Guia de referência — Arquitetura em memória do lado do cliente e fluxo de dados

Parâmetros-chave e controles

Consumo de CPU Base do Pod (P95 em Milicores)Milicores (mCPU) / vCPU decimal

Carga de trabalho sustentada no percentil 95 (P95) de núcleos de CPU amostrada em uma janela de observação de 7 dias via Prometheus ou Datadog sob tráfego estável de produção, desconsiderando anomalias de inicialização a frio (cold start). Avaliada sob períodos de contabilização de cota de 100 ms do Linux Completely Fair Scheduler (CFS).

Padrão: 250m
Margem de Pico e Buffer de Rajada Diurna (%)Porcentagem (%)

Margem de segurança dinâmica calculada como CPU_Solicitada = CPU_Base * (1 + Percentual_Margem / 100). As melhores práticas de Site Reliability Engineering (SRE) em produção estabelecem de 20% a 30% de margem (headroom) para absorver oscilações diurnas de tráfego sem causar expulsão (eviction) de pods ou falhas de agendamento nos nós.

Padrão: 25%
Working Set de Memória Base do Pod (RSS + Cache Ativo)Megabytes (MiB) / Gigabytes (GiB)

Tamanho do conjunto residente ativo (Resident Set Size - RSS) e memória não recuperável derivados da métrica container_memory_working_set_bytes do Kubernetes. Distinto do page cache recuperável, este valor estabelece o limiar basal antes de acionar os controladores de pressão de memória do cgroup v1/v2 do Linux.

Padrão: 512Mi
Classe de QoS Alvo do PodNível de QoS do Kubernetes (Guaranteed | Burstable | BestEffort)

Nível de Qualidade de Serviço (QoS) que governa a pontuação oom_score_adj no kernel Linux. Guaranteed exige cpu.limits == cpu.requests E memory.limits == memory.requests (oom_score_adj: -997 a -998, menor prioridade de expulsão); Burstable exige requests < limits (oom_score_adj dinâmico entre 1000 - 1000 * mem_req / mem_no); BestEffort omite ambos (oom_score_adj: 1000, primeiro a ser encerrado).

Padrão: Burstable
Perfil de Hardware do Nó de Trabalho (Worker Node)Tipo de Instância de Computação (vCPU / GiB de RAM)

Especificação de hardware do servidor bare-metal ou máquina virtual (ex.: AWS m6i.2xlarge com 8 vCPUs e 32 GiB de RAM, ou GCP n2-standard-8). Sujeito a deduções em faixas (piecewise) dos provedores de nuvem: Capacidade_Alocável = Capacidade_Bruta - Kubelet_Reserved - System_Reserved - Eviction_Hard_Threshold (100Mi).

Padrão: 8 vCPU / 32 GiB RAM
Número de Réplicas Horizontais do DeploymentInteiro (Pods / Metas de Escala)

Quantidade alvo de réplicas para alta disponibilidade e redundância de domínio de falha N+1 / N+2 entre zonas de disponibilidade. Determina diretamente as dimensões de empacotamento (bin-packing) nos nós de trabalho: Nos_Necessarios = max(ceil(CPU_Total_Req / CPU_Alocavel), ceil(Mem_Total_Req / Mem_Alocavel), ceil(Total_Replicas / Max_Pods_Efetivo)).

Padrão: 12

Dicas profissionais e melhores práticas

Elimine Gargalos de Latência P99 Omitindo Limites de CPU CFS em Runtimes Multithread

Definir 'resources.limits.cpu' ativa o mecanismo de cota do Completely Fair Scheduler (CFS) do Linux (cpu.cfs_quota_us em uma janela cpu.cfs_period_us de 100 ms). Runtimes multithread (Goroutines em Go, threads de GC na JVM, worker pools em Node.js) escalonam tarefas concorrentemente em todas as vCPUs do nó; se 8 threads executarem por 12,5 ms, consumirão 100 ms de cota em apenas 13 ms de tempo real, forçando o kernel Linux a estrangular (throttle) todo o processo pelos 87 ms restantes da janela. Isso gera picos artificiais de latência no P99 e timeouts em serviços upstream, mesmo com o nó operando a apenas 20% de utilização de CPU. A prática recomendada de SRE para microsserviços críticos em latência é definir requests de CPU generosos (P95 + margem de segurança), omitir limites de CPU (limits) e manter limites estritos de memória para conter memory leaks.

Aplique Curvas Escalonadas por Faixas no Cálculo de Capacidade Alocável no GKE e EKS

Nunca calcule a capacidade do cluster utilizando especificações brutas de hardware. Os provedores de nuvem deduzem a capacidade do sistema usando uma fórmula oficial escalonada por faixas (piecewise): RAM_Reservada = 25% de [0..4 GiB] + 20% de [4..8 GiB] + 10% de [8..16 GiB] + 6% de [16..128 GiB] + 2% de [>128 GiB], acrescida de um limiar imutável de expulsão rígida (hard eviction) de 100 MiB. Em um nó worker de 32 GiB (como o AWS m6i.2xlarge ou GCP n2-standard-8), isso deduz 25%(4) + 20%(4) + 10%(8) + 6%(16) + 0,1 GiB = 1,0 + 0,8 + 0,8 + 0,96 + 0,1 = 3,66 GiB, restando apenas ~28,34 GiB de RAM Alocável (Allocatable). Ignorar essa dedução em algoritmos de empacotamento (bin-packing) resulta em pods travados no estado Pending e preempções imediatas sob pressão de inicialização do nó.

Evite o Esgotamento de IPs por MaxPods do AWS VPC CNI em Nós de Alta Densidade

Com frequência, o dimensionamento de nós do cluster é limitado não pela exaustão de CPU ou memória, mas pelos limites de interface de rede do CNI. No plugin padrão AWS VPC CNI, a quantidade máxima de pods por instância EC2 é governada pelos limites de ENI: MaxPods = (ENIs - 1) * (IPv4_por_ENI - 1) + 2. Uma instância m6i.large (2 vCPUs, 8 GiB) suporta apenas 3 ENIs com 10 IPs cada, limitando rigidamente a densidade a 29 pods, independentemente de quão leves sejam seus contêineres. Ao calcular a quantidade de nós via Nos_Necessarios = max(ceil(CPU_Total_Req / CPU_Alocavel), ceil(Mem_Total_Req / Mem_Alocavel), ceil(Total_Replicas / Max_Pods_Efetivo)), desconsiderar o teto de MaxPods deixará os nós subutilizados em poder computacional, enquanto as réplicas restantes falham em ser agendadas.

Use QoS Guaranteed com oom_score_adj Fixo para Proteger Bancos de Dados Stateful

Sob pressão de memória, o Out-Of-Memory (OOM) Killer do kernel Linux avalia cada processo através de seu /proc/[pid]/oom_score. O Kubernetes traduz as classes de QoS dos pods em valores de oom_score_adj: pods da classe Guaranteed (cpu.limits == cpu.requests E memory.limits == memory.requests) recebem -997 ou -998, tornando-se praticamente imunes ao encerramento abrupto, a menos que o próprio kernel esgote a memória crítica do sistema. Pods Burstable recebem pontuações dinâmicas entre 2 e 999, calculadas como max(floor(1000 * mem_request / node_capacity), 1000 - 1000 * mem_request / node_capacity), enquanto pods BestEffort recebem 1000 (sendo eliminados imediatamente). Configure sempre bancos como PostgreSQL, Redis, Kafka e pods de Ingress Controller como Guaranteed para evitar loops de failover em cascata durante picos de escassez de memória no nó.

Isolamento Criptográfico no Navegador e Determinismo O(n) no Empacotamento de Nós

Para preservar a privacidade de infraestruturas sob o modelo Zero Trust, as simulações de dimensionamento computacional e empacotamento vetorial multidimensional (bin-packing) são executadas estritamente no runtime do navegador com complexidade algorítmica First-Fit-Decreasing O(n). Topologias de recursos do cluster, definições de pods e contagem de réplicas permanecem totalmente isoladas na memória local do cliente, utilizando primitivas CSPRNG nativas da Web Crypto API para entropia visual sem qualquer telemetria no servidor ou logs de egresso, em total conformidade com os requisitos de confidencialidade auditados pelo SOC 2 Tipo II e RFCs pertinentes.
Armadilhas comuns e solução de problemas

⚠️Pods Encerrados com Exit Code 137 (OOMKilled) Embora Métricas da Aplicação Indiquem Memória Abaixo do Limite

O código de saída (Exit Code) 137 indica terminação forçada por sinal SIGKILL (128 + 9). Essa discrepância ocorre porque os runtimes de aplicação (como o heap do Node.js ou a memória de runtime do Go) reportam apenas a memória virtual ou o heap gerenciado, enquanto o controlador de memória cgroup v1/v2 do kernel Linux monitora a métrica container_memory_working_set_bytes, que inclui arquivos mapeados em memória (mmap), page caches de E/S ativos e alocações nativas fora do heap. Quando memory.current excede memory.max (limits.memory), o controlador do cgroup dispara imediatamente o OOM kill sem emitir alertas à aplicação. Resolução: Consulte no Prometheus a métrica 'container_memory_working_set_bytes{pod=...}' em vez de métricas internas do runtime; aumente resources.limits.memory entre 25% e 35% acima do P95 observado do working set, ou otimize o uso de descritores de arquivos mapeados (mmap) e alocações de thread pools nativas na aplicação.

⚠️Aplicações Multithread Apresentam Picos Críticos de Latência P99 Mesmo com Baixo Uso Geral de CPU no Cluster

Trata-se da clássica armadilha de estrangulamento de cota do Completely Fair Scheduler (CFS) do Linux. Quando 'resources.limits.cpu' é definido, o kubelet configura o parâmetro 'cpu.cfs_quota_us' com base em um período de 100.000 µs (100 ms). Aplicações multithread (GC paralelo na JVM Java, agendamento de goroutines no Go com runtime.GOMAXPROCS, servidores web multi-worker) disparam threads concorrentes em todos os núcleos disponíveis do nó host. Se um pod possui um limit de 1000m (1 núcleo = 100 ms de cota) em um nó de 8 núcleos, 8 threads ativas consumirão 100 ms de cota acumulada em apenas 12,5 ms de tempo real, forçando o kernel Linux a pausar todas as threads do contêiner pelos 87,5 ms restantes do ciclo. Resolução: Analise no Prometheus a razão 'container_cpu_cfs_throttled_periods_total / container_cpu_cfs_periods_total'; se o estrangulamento ultrapassar 5%, remova 'resources.limits.cpu' por completo ou aumente o limite para 3x o request, além de alinhar estritamente os pools de threads do runtime (como GOMAXPROCS ou ActiveProcessorCount no Java) com os requests de CPU do pod.

⚠️Réplicas do Deployment Travadas em Pending com '0/N nodes available: Insufficient cpu' Apesar de Nós com Capacidade Ociosa

As decisões de agendamento do kube-scheduler são calculadas estritamente com base nos 'requests' de recursos dos pods, e NÃO no consumo real de CPU em tempo real. Se quatro pods com requests de CPU de 2000m forem alocados em um nó de 8 vCPUs, o nó atinge 100% de comprometimento perante o escalonador, mesmo que os contêineres estejam operando com apenas 5% de uso real. Um quinto pod que solicite 1000m será rejeitado e permanecerá em 'Pending'. Além disso, DaemonSets (como calico-node, aws-node, fluentbit, datadog) consomem capacidade em todos os nós antes que os pods da aplicação possam ser posicionados. Resolução: Execute 'kubectl describe node <nome>' para inspecionar a seção 'Allocated resources'; realize o redimensionamento (rightsizing) reduzindo os requests de CPU para o consumo P95 real em regime estável + 20% de margem, liberando espaço no escalonador para empacotar as cargas de trabalho pendentes sem provisionar nós extras desnecessários na nuvem.

Perguntas frequentes (FAQ)

Como calcular requests e limits de CPU e memória no Kubernetes?▼

Para calcular requests de CPU e memória, identifique o consumo sustentado no percentil 95 (P95) via Prometheus ou Datadog em uma janela de 7 dias. Defina o request com base no P95 acrescido de uma margem de segurança de 20% a 30% (Request = P95 * 1,25) para absorver oscilações diurnas de tráfego sem disparar desalocações pelo escalonador. Para limits de memória, estabeleça um teto de 20% a 30% acima do request para comportar expansões transitórias de heap e buffers de arquivos mapeados (mmap) antes de atingir o limiar memory.max do cgroup. Para limits de CPU, as melhores práticas da indústria para microsserviços sensíveis à latência recomendam configurar limits de 2x a 3x o request ou omiti-los completamente para evitar o estrangulamento de cota do Completely Fair Scheduler (CFS) do Linux, combinando essa estratégia com autoscaling do cluster e limites rígidos de memória.

Qual é a diferença entre as classes de QoS Guaranteed e Burstable no Kubernetes?▼

A classe de QoS Guaranteed exige que os requests e limits de CPU e memória sejam rigorosamente idênticos (cpu.limits == cpu.requests E memory.limits == memory.requests) em todos os contêineres do pod, atribuindo um oom_score_adj de -997 a -998, o que garante imunidade quase total contra encerramentos por falta de memória no nó. A classe Burstable ocorre quando os requests são estritamente menores que os limits ou quando os limits de CPU são omitidos, resultando em um oom_score_adj dinâmico entre 2 e 999. Sob pressão de memória no nó, o kubelet e o Linux OOM Killer encerram primeiro os pods BestEffort (oom_score_adj: 1000), em seguida os pods Burstable que estejam excedendo seus requests de memória, e por último os pods Guaranteed.

Limites de CPU (limits) devem sempre ser definidos em pods Kubernetes de produção?▼

Não. A definição de limits de CPU costuma ser contraproducente para microsserviços multithread. Ao impor 'resources.limits.cpu', o Completely Fair Scheduler do kernel Linux aplica cotas rígidas em milissegundos (cpu.cfs_quota_us) em intervalos de 100 ms. Quando aplicações multithread (Go, Java, pools de workers no Node.js) realizam processamento paralelo em múltiplos núcleos do nó, esgotam a cota atribuída em apenas 10 a 20 ms, fazendo com que o kernel suspenda a execução do contêiner pelos 80 a 90 ms seguintes. Isso provoca picos artificiais de latência no P99 e quedas de conexão, mesmo quando o nó possui 60% de capacidade ociosa. Arquiteturas de produção de alta performance costumam adotar requests de CPU generosos, omitir limites de CPU e aplicar limites rígidos de memória para prevenir quedas por OOM em cascata.

Por que pods no Kubernetes falham com Exit Code 137 OOMKilled?▼

O código de saída 137 indica a finalização do processo pelo sinal SIGKILL do Linux (128 + 9 = 137), disparado pelo Out-Of-Memory Killer. Isso acontece em dois cenários distintos: 1) Violação do limite de cgroup no contêiner, onde container_memory_working_set_bytes ultrapassa o valor de 'resources.limits.memory' e o controlador do cgroup encerra imediatamente o processo infrator; ou 2) Esgotamento de memória física no nó, quando a memória RAM disponível cai abaixo do limiar de expulsão crítica do kubelet (padrão de 100 MiB) e o OOM Killer do sistema elimina os pods com maior oom_score_adj (normalmente pods BestEffort ou Burstable que estejam consumindo acima de seus requests).

Quanto de CPU e memória o Kubernetes reserva para os sistemas operacionais dos nós?▼

Os provedores de nuvem reservam capacidade operacional através de curvas escalonadas para kube-reserved e system-reserved. No AWS EKS e GCP GKE, as reservas de memória seguem uma fórmula oficial em faixas: 25% dos primeiros 4 GiB, 20% dos 4 GiB seguintes (4 a 8 GiB), 10% dos 8 GiB seguintes (8 a 16 GiB), 6% dos 112 GiB subsequentes (16 a 128 GiB) e 2% da memória acima de 128 GiB, complementados por um limiar de expulsão rígida de 100 MiB. Para CPU, as reservas deduzem aproximadamente 6% do primeiro núcleo, 1% do segundo núcleo, 0,5% dos núcleos 3 e 4, e 0,25% dos núcleos excedentes para assegurar a estabilidade do kernel Linux, systemd e do daemon kubelet.

Como calcular a quantidade de nós de trabalho necessários para um cluster Kubernetes?▼

Calcule o total de nós necessários utilizando o empacotamento vetorial multidimensional (bin-packing): Nos_Necessarios = max(ceil(CPU_Total_Req / CPU_Alocavel_No), ceil(Mem_Total_Req / Mem_Alocavel_No), ceil(Total_Replicas / Max_Pods_Efetivo)). Primeiro, deduza as reservas escalonadas da nuvem e os recursos consumidos por DaemonSets da capacidade bruta do hardware para obter a capacidade Alocável (Allocatable) real. Em seguida, some as demandas de requests de todas as réplicas dos pods. Por fim, avalie se o cluster é limitado por CPU, por memória ou por limites de densidade de IPs do CNI (como os limites de ENI do AWS VPC CNI), arredondando para o próximo número inteiro a fim de garantir redundância e alta disponibilidade N+1.

Ferramentas e utilitários relacionados

Todas as ferramentas →
Calculadora de Séries Geométricas (Termo n & Soma)Mathematics

Calcule o enésimo termo, soma parcial finita e soma infinita de qualquer sequência geométrica com diagnóstico de convergência e tabela de termos.

Abrir ferramenta→
Calculadora de Lote Econômico (EOQ)finance

Calcule o lote econômico de compras (EOQ), o tamanho ideal de lote e os custos anuais de posse do estoque. Otimize os custos de pedidos com análise de ponto de reposição e faixas de desconto por volume.

Abrir ferramenta→
Calculadora de Enterrada & Impulsãohealth

Calculadora biomecânica que afere a impulsão vertical exata para enterrar no aro oficial de 3,05 m (10 pés) a partir do alcance em pé, controle da bola, rebaixamento escapular bilateral e estilo de enterrada, calculando tempo de suspensão (hang time), velocidade de saída e potência de pico de Sayers.

Abrir ferramenta→
Temp. Desejada da Massa (DDT) & Águaculinary

Calcule a temperatura exata da água de amassadura com fórmulas DDT de 3 e 4 fatores, proporções de gelo triturado e calibração de atrito da masseira.

Abrir ferramenta→
Calculadora de Cônicas & Gráficosmath

Calculadora e traçador de seções cônicas. Resolva equações gerais e reduzidas de elipse, parábola e hipérbole com focos, diretriz, vértices e resolução passo a passo.

Abrir ferramenta→
Altura de Árvore (Clinômetro & Declive)Utilidade

Calcule a altura total da árvore usando visadas angulares com clinômetro e distância inclinada. Ajuste pela altura dos olhos, declividade do terreno, proporção de copa e zonas de segurança para abate florestal.

Abrir ferramenta→