P99-Latenz-Klippen durch Weglassen von CFS-CPU-Limits bei Multi-Threaded-Runtimes eliminieren
Das Definieren von 'resources.limits.cpu' aktiviert den Quota-Mechanismus des Linux Completely Fair Scheduler (cpu.cfs_quota_us über ein Fenster von 100 ms via cpu.cfs_period_us). Multi-Threaded-Laufzeitumgebungen (Go-Goroutinen, JVM-GC-Threads, Node.js-Worker-Pools) verteilen Rechenlast parallel auf alle vCPUs des Nodes. Wenn 8 Threads für 12,5 ms laufen, verbrauchen sie 100 ms Quota in nur 13 ms Echtzeit. Der Linux-Kernel drosselt (throttled) den gesamten Prozess daraufhin für die verbleibenden 87 ms. Dies erzeugt künstliche P99-Latenzspitzen und Upstream-Timeouts, obwohl der Host-Node bei lediglich 20 % CPU-Auslastung liegt. Die SRE-Best-Practice für latenzkritische Microservices lautet daher: Großzügige CPU-Requests passend zu P95 + Puffer festlegen, CPU-Limits weglassen und strikte Memory-Limits setzen, um vor Memory Leaks zu schützen.
Stufenförmige Berechnungsformeln für Node-Allocatable bei GKE und EKS berücksichtigen
Berechnen Sie die Clusterkapazität niemals anhand unbereinigter Brutto-Hardwarespezifikationen. Cloud-Provider ziehen Systemkapazitäten nach einer offiziellen stufenweisen Formel ab: Reservierter_RAM = 25 % von [0..4 GiB] + 20 % von [4..8 GiB] + 10 % von [8..16 GiB] + 6 % von [16..128 GiB] + 2 % von [>128 GiB], ergänzt um einen unveränderlichen Hard-Eviction-Schwellenwert von 100 MiB. Bei einem 32-GiB-Worker-Node (z. B. AWS m6i.2xlarge oder GCP n2-standard-8) ergibt dies einen Abzug von 25 %(4) + 20 %(4) + 10 %(8) + 6 %(16) + 0,1 GiB = 1,0 + 0,8 + 0,8 + 0,96 + 0,1 = 3,66 GiB. Es verbleiben somit lediglich ~28,34 GiB Allocatable RAM. Wird dies in Bin-Packing-Algorithmen ignoriert, führt dies zu unplatzierten Pods im Status 'Pending' und vorzeitiger Preemption beim Node-Bootvorgang.
IP-Erschöpfung durch MaxPods im AWS VPC CNI bei hochdichter Node-Planung vermeiden
Der Knotenbedarf im Cluster wird häufig nicht durch CPU- oder Speichererschöpfung limitiert, sondern durch Netzwerkschnittstellen-Grenzen des CNI-Plugins. Beim Standard-AWS-VPC-CNI wird die maximale Pod-Anzahl pro EC2-Instanz durch ENI-Limits bestimmt: MaxPods = (ENIs - 1) * (IPv4_pro_ENI - 1) + 2. Eine m6i.large-Instanz (2 vCPU, 8 GiB) unterstützt beispielsweise nur 3 ENIs mit jeweils 10 IPs, was die Pod-Dichte unabhängig von der Leichtgewichtigkeit der Container strikt auf 29 Pods deckelt. Bei der Berechnung der Worker-Node-Anzahl via Nodes_Needed = max(ceil(Gesamt_CPU_Req / Allocatable_CPU), ceil(Gesamt_Mem_Req / Allocatable_Mem), ceil(Gesamt_Replikas / Effektive_Max_Pods)) führt das Ignorieren dieser MaxPods-Obergrenze dazu, dass Nodes rechentechnisch halb leer bleiben, während verbleibende Replikas mangels freier IPs nicht gescheduled werden können.
Stateful Data-Stores mit Guaranteed-QoS-Pods und fixiertem oom_score_adj absichern
Bei akutem Arbeitsspeichermangel bewertet der Out-Of-Memory (OOM) Killer des Linux-Kernels jeden Prozess anhand seines Werts in /proc/[pid]/oom_score. Kubernetes bildet die Pod-QoS-Klassen direkt auf oom_score_adj ab: Guaranteed-Pods (cpu.limits == cpu.requests UND memory.limits == memory.requests) erhalten den Wert -997 oder -998, was sie praktisch vor einer Eviction schützt, solange der Kernel selbst noch über ausreichend Speicher verfügt. Burstable-Pods erhalten dynamische Scores zwischen 2 und 999, berechnet über max(floor(1000 * mem_request / node_capacity), 1000 - 1000 * mem_request / node_capacity), während BestEffort-Pods fest auf 1000 gesetzt und somit sofort beendet werden. Konfigurieren Sie PostgreSQL-, Redis-, Kafka- und Ingress-Controller-Pods stets als Guaranteed, um kaskadierende Failover-Schleifen bei Speicherengpässen auf Node-Ebene zu verhindern.
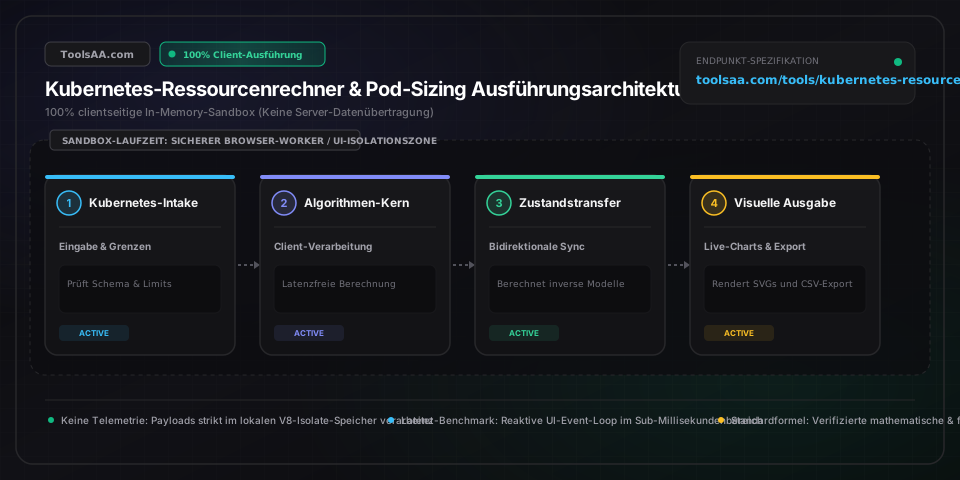
Kryptografisches In-Browser-Sandboxing & deterministisches O(n)-Bin-Packing
Zur Gewährleistung vollständiger Zero-Trust-Datensicherheit laufen Kapazitätsberechnungen und mehrdimensionale Vektor-Bin-Packing-Simulationen strikt lokal in der Browser-Runtime mit O(n)-First-Fit-Decreasing-Komplexität ab. Cluster-Ressourcentopologien, Pod-Definitionen und Replika-Zahlen verbleiben vollständig isoliert im Arbeitsspeicher des Clients. Für Layout-Entropie kommen native CSPRNG-Primitive der Web Crypto API zum Einsatz – ganz ohne serverseitige Telemetrie oder Egress-Logging, in voller Übereinstimmung mit DSGVO-, SOC 2 Type II- und RFC-geprüften Vertraulichkeitsstandards.