Elimina caídas bruscas de latencia P99 omitiendo límites de CPU en entornos multihilo con CFS
Definir 'resources.limits.cpu' activa el mecanismo de cuotas del Completely Fair Scheduler de Linux (cpu.cfs_quota_us en una ventana de cpu.cfs_period_us de 100 ms). Los entornos de ejecución multihilo (gorutinas de Go, hilos de recolección de basura de la JVM, pools de workers de Node.js) programan trabajo de forma concurrente en todas las vCPU del nodo; si 8 hilos se ejecutan durante 12,5 ms, consumen 100 ms de cuota acumulada en apenas 13 ms de tiempo real, obligando al kernel de Linux a limitar (throttle) todo el proceso durante los 87 ms restantes del periodo. Esto genera picos artificiales de latencia P99 y tiempos de espera agotados (timeouts) aguas arriba, a pesar de que el nodo anfitrión opere a un 20 % de uso de CPU. La mejor práctica de SRE para microservicios críticos en latencia es configurar solicitudes (requests) de CPU generosas que cubran el P95 más el margen de seguridad, omitir los límites de CPU y mantener límites estrictos de memoria para proteger contra fugas de memoria.
Aplica curvas escalonadas por tramos para calcular la capacidad asignable en nodos GKE/EKS
Nunca calcules la capacidad del clúster basándote en las especificaciones brutas de hardware. Los proveedores cloud deducen capacidad del sistema mediante la fórmula oficial por tramos: RAM_Reservada = 25 % de [0..4 GiB] + 20 % de [4..8 GiB] + 10 % de [8..16 GiB] + 6 % de [16..128 GiB] + 2 % de [>128 GiB], complementado con un umbral de desalojo crítico (hard eviction threshold) inmutable de 100 MiB. En un nodo de trabajo de 32 GiB (ej. AWS m6i.2xlarge o GCP n2-standard-8), esto deduce 25%(4) + 20%(4) + 10%(8) + 6%(16) + 0,1 GiB = 1,0 + 0,8 + 0,8 + 0,96 + 0,1 = 3,66 GiB, dejando únicamente ~28,34 GiB de RAM asignable (Allocatable). Omitir este cálculo en los algoritmos de bin-packing provoca pods pendientes sin programar y desalojos inmediatos ante la presión de arranque de los nodos.
Evita el agotamiento de IP por MaxPods de AWS VPC CNI en nodos de alta densidad
Los requisitos de nodos en un clúster suelen verse limitados no por el agotamiento de CPU o memoria, sino por los límites de las interfaces de red del CNI. Con el plugin predeterminado AWS VPC CNI, la cantidad máxima de pods por instancia EC2 se rige por los límites de ENI: MaxPods = (ENI - 1) * (IPv4_por_ENI - 1) + 2. Una instancia m6i.large (2 vCPU, 8 GiB) solo admite 3 ENI con 10 IP cada una, imponiendo un límite estricto de densidad de 29 pods por ligero que sea el contenedor. Al calcular el número de nodos de trabajo mediante Nodos_Necesarios = max(ceil(Total_CPU_Req / Allocatable_CPU), ceil(Total_Mem_Req / Allocatable_Mem), ceil(Total_Replicas / Effective_Max_Pods)), si no se tiene en cuenta este techo de MaxPods efectivo, los nodos quedarán a mitad de capacidad de cómputo mientras las réplicas restantes quedan bloqueadas sin poder programarse.
Aprovecha pods con QoS Guaranteed y oom_score_adj fijo para proteger almacenes de datos persistentes
Bajo presión de memoria, el Out-Of-Memory (OOM) Killer del kernel de Linux evalúa cada proceso a través de su /proc/[pid]/oom_score. Kubernetes traduce las clases de calidad de servicio (QoS) de los pods en un valor de oom_score_adj: los pods Guaranteed (cpu.limits == cpu.requests Y memory.limits == memory.requests) reciben -997 o -998, lo que los inmuniza prácticamente contra el desalojo a menos que el propio kernel agote su memoria crítica. Los pods Burstable reciben puntuaciones dinámicas entre 2 y 999 calculadas como max(floor(1000 * mem_request / node_capacity), 1000 - 1000 * mem_request / node_capacity), mientras que los pods BestEffort se fijan en 1000 (eliminados de inmediato). Configura siempre pods de PostgreSQL, Redis, Kafka y controladores de Ingress con QoS Guaranteed para evitar bucles de conmutación por error en cascada durante situaciones de inanición de memoria en el nodo.
Aislamiento criptográfico en navegador y determinismo de bin-packing O(n)
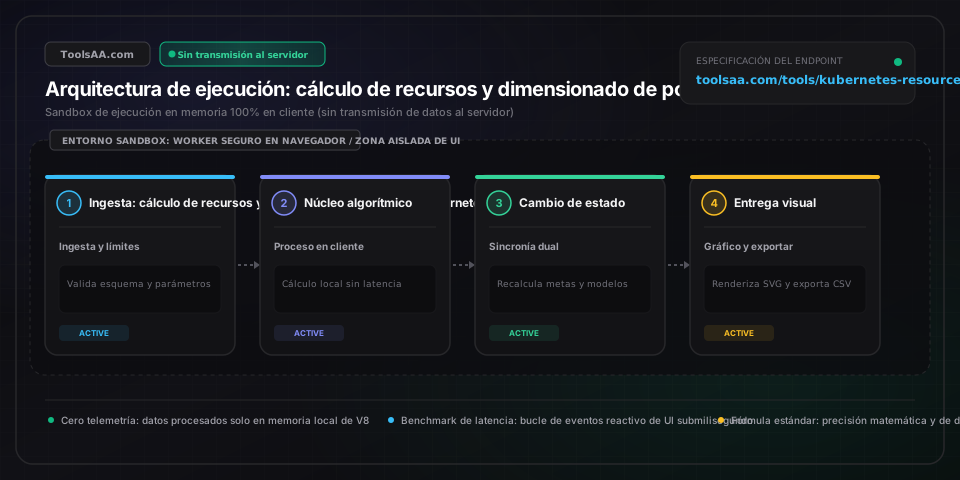
Para garantizar la privacidad de infraestructura bajo modelos de confianza cero (Zero Trust), las simulaciones de dimensionamiento de cómputo y empaquetado vectorial multidimensional (bin-packing) se ejecutan estrictamente dentro del entorno del navegador del cliente con una complejidad algorítmica First-Fit-Decreasing O(n). Las topologías de recursos del clúster, definiciones de pods y recuentos de réplicas permanecen totalmente aisladas en la memoria del cliente, utilizando primitivas CSPRNG nativas de la Web Crypto API para generar entropía visual sin telemetría de servidor ni registro de tráfico saliente (egress), cumpliendo íntegramente con los estándares de confidencialidad auditados bajo SOC 2 Tipo II y normativas RFC.