Chi-Quadrat-Test & p-Wert-Rechner

Chi-Quadrat-Test & p-Wert-Rechner

Berechnen Sie Chi-Quadrat-Prüfgröße, p-Wert, erwartete Häufigkeiten und Cramérs V für 2x2- bis 10x10-Kontingenztafeln sowie Anpassungstests in Echtzeit.

Schnellvorlagen
Signifikanzniveau (α)
Kreuztabelle & Häufigkeitsmatrix
Zeilen
2
Spalten
2
ZeilenbeschriftungGesamt
1000
1000
Gesamt28517152000
Gesamtstichprobe2000
Cochran erfüllt
Inverser Chi-Quadrat-Rechner
Inverse Berechnung

Ermitteln Sie p-Werte oder kritische Chi-Quadrat-Schwellenwerte direkt aus Prüfgröße und Freiheitsgraden.

Simulierter Skalierungsfaktor1.0x
0.2x1.0x (Aktuelle Skalierung)5.0x
Projiziertes Chi-Quadrat (χ²)8.29
Projizierter p-Wert0.0040
Benötigte Fallzahl 0.05:928 TeilnehmerBasierend auf aktuellen Proportionen
Erforderliche Fallzahl für 80 % Power1846 TeilnehmerStandard-Richtwert für Teststärke: 80 %
Cohens w0.064(Vernachlässigbare Effektstärke)
Geschätzte Teststärke (Power)82.1%
Chi-Quadrat-Prüfgröße (χ²)8.2860Kritischer Schwellenwert 3.841
p-Wert0.0040Schwellenwert 0.05
Freiheitsgrade (df)1(r-1)×(c-1)
Cramérs V0.0644Schwacher Zusammenhang
Statistisch signifikantes Ergebnis
Der p-Wert liegt unter dem Signifikanzniveau (p < α). Die Nullhypothese wird verworfen; es besteht ein statistisch signifikanter Zusammenhang.
Chi-Quadrat-Dichteverteilung
AblehnungsbereichBeobachtet
χ²_crit = 3.84χ² = 8.290471114
Heatmap standardisierter Residuen
Chancenverhältnis (Odds Ratio)0.690Konfidenzintervall (KI): [0.54 - 0.89]
Relatives Risiko (RR)0.727Konfidenzintervall (KI): [0.58 - 0.90]
Absolute Risikoreduktion (ARR)4.5%Number Needed to Treat (NNT): ~22
Exakter Fisher-Test0.0048Exakter Fisher-Test empfohlen (bei erwarteter Zellhäufigkeit < 5)
KohorteConvertedBounced
Control Page (A)
Beobachtet (O):120
Erwartet (E):142.5
z-Wert:-2.88
χ²-Beitrag:43%
Beobachtet (O):880
Erwartet (E):857.5
z-Wert:2.88
χ²-Beitrag:7%
Variant Page (B)
Beobachtet (O):165
Erwartet (E):142.5
z-Wert:2.88
χ²-Beitrag:43%
Beobachtet (O):835
Erwartet (E):857.5
z-Wert:-2.88
χ²-Beitrag:7%
Über ErwartungswertDarunter: Erwartete Häufigkeit (E)Neutral
Chi-Quadrat-Statistik (χ²)

Summe der quadrierten Abweichungen zwischen beobachteten und theoretisch erwarteten Häufigkeiten.

Cochran-Kriterium (Zellhäufigkeit)

Alle erwarteten Zellhäufigkeiten betragen mindestens 5. Die mathematischen Testvoraussetzungen sind erfüllt.

P-Wert & statistische Signifikanz

Wahrscheinlichkeit, bei Gültigkeit der Nullhypothese eine mindestens ebenso extreme Prüfgröße zu erhalten.

Methodischer Hinweis & Haftungsausschluss

Alle statistischen Berechnungen dienen Informations- und Analysezwecken. Für wissenschaftliche Publikationen oder klinische Entscheidungen sollten Verteilungsvoraussetzungen und Stichprobenumfänge methodisch validiert werden.

Clientseitige Verarbeitung

Hochleistungsberechnung direkt im Arbeitsspeicher des Browsers ausgeführt.

Kein Server-Upload

Sämtliche Daten verbleiben ausschließlich lokal ohne externe Datenübertragung.

Produktionsreifer Export

Saubere, optimierte Ausgabeformate für die unmittelbare Weiterverarbeitung.
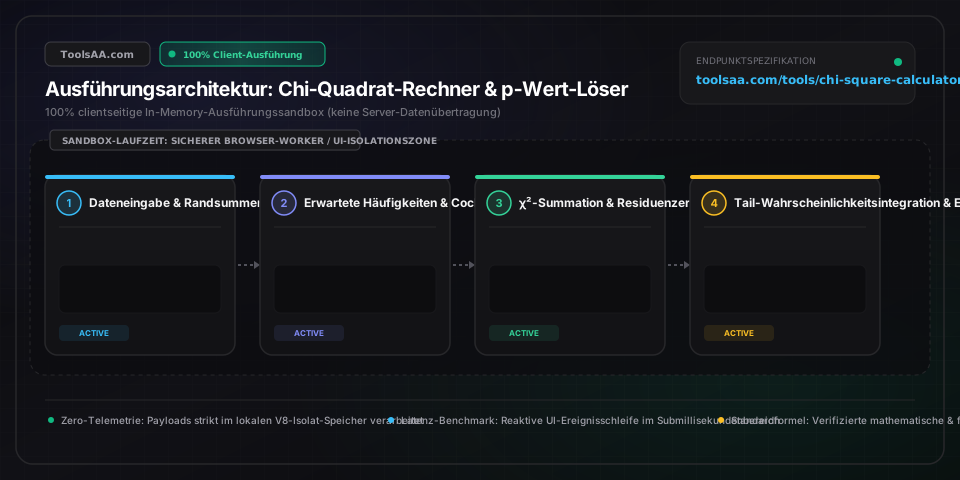
Technische Referenz & Architektur-Leitfaden

Chi-Quadrat-Test Rechner & p-Wert — Referenzhandbuch

Berechnen Sie Chi-Quadrat-Prüfgröße, p-Wert, erwartete Häufigkeiten und Cramérs V für 2x2- bis 10x10-Kontingenztafeln sowie Anpassungstests präzise und sofort.

Chi-Quadrat-Test Rechner & p-Wert — Referenzhandbuch — Client-seitige In-Memory-Architektur und Datenfluss

Wichtige Parameter & Einstellungen

Beobachtete Zellhäufigkeiten (O_ij)Empirische absolute Häufigkeiten (Ganzzahlen ≥ 0)

Empirisch erfasste Fallzahlen je Kategorie. Zur Wahrung der statistischen Validität müssen die Eingaben ungewichtete nicht-negative Ganzzahlen sein; die Eingabe von Prozentwerten, Anteilen oder Mittelwerten verzerrt die Prüfgröße und macht Standardfehlerberechnungen ungültig.

Standard: Nicht-negative Ganzzahlen (z. B. 25, 40)
Signifikanzniveau (Alpha, α)Entscheidungsschwelle / Irrtumswahrscheinlichkeit (0 bis 1)

Die vorab festgelegte Toleranz für den Fehler 1. Art beim Verwerfen der Nullhypothese der Unabhängigkeit. Der wissenschaftliche Standard liegt bei α = 0,05 (5 % Irrtumsrisiko), während klinische Studien oft strenge α = 0,01 (1 %) fordern und explorative Screenings mit α = 0,10 arbeiten.

Standard: 0,05
Freiheitsgrade (df)Unabhängige Variationsdimensionen (Ganzzahl > 0)

Anzahl der frei variierbaren Zellhäufigkeiten bei fest vorgegebenen Zeilen- und Spaltenrandsummen. Berechnet als (r - 1) × (c - 1) für eine r × c-Kontingenztafel oder (k - 1) für einen 1 × k-Anpassungstest. Höhere Freiheitsgrade verschieben den kritischen Chi-Quadrat-Schwellenwert nach oben.

Standard: (r - 1) × (c - 1)
Erwartete Zellhäufigkeiten (E_ij)Theoretische Referenzhäufigkeiten (Reelle Zahlen > 0)

Theoretische Häufigkeiten unter Annahme stochastischer Unabhängigkeit: E_ij = (Zeilensumme × Spaltensumme) / Gesamtstichprobenumfang (N). Nach dem Cochran-Kriterium müssen mindestens 80 % der Zellen ein E_ij ≥ 5 aufweisen und keine Zelle darf ein E_ij < 1 besitzen.

Standard: ≥ 5 gemäß Cochran-Kriterium

Profi-Tipps & Best Practices

Scheinsignifikanzen bei großen Stichproben (N > 10.000) vermeiden

Chi-Quadrat-p-Werte konvergieren bei wachsendem Stichprobenumfang gegen null; ab 10.000 Probanden führt selbst ein irrelevanter Präferenzunterschied von 0,2 % zu p < 0,001. Beurteilen Sie stets Cramérs V parallel zum p-Wert: Ein V unter 0,10 belegt eine vernachlässigbare praktische Relevanz trotz überwältigender statistischer Signifikanz.

Absolute Häufigkeiten: Niemals Prozentwerte eingeben

Das Eintragen gerundeter Prozentwerte (wie 45 % und 55 %) anstelle exakter Fallzahlen zerstört den Nenner der Chi-Quadrat-Formel vollständig. Die Prüfgröße ist skalenabhängig von der Gesamtstichprobe N; Prozentangaben reduzieren N künstlich auf 100, wodurch tatsächlich signifikante Befunde bei Tausenden Befragten fälschlicherweise als insignifikant ausgewiesen werden.

Zelltreiber mit adjustierten Residuen isolieren

Ein global signifikanter p-Wert (p < 0,05) bestätigt lediglich, dass eine Abhängigkeit vorliegt, verrät jedoch nicht, welche Kategorie dafür verantwortlich ist. Prüfen Sie die adjustierten standardisierten Residuen nach Haberman (z_adj): Jede Zelle mit |z| > 1,96 (bzw. |z| > 2,58 bei α = 0,01) weist einen statistisch signifikanten Überschuss oder ein Defizit auf, das Ihr Gesamtergebnis treibt.

Wann der exakte Fisher-Test dem Pearson-Test vorzuziehen ist

In 2x2-Vierfeldertafeln mit N < 40 oder wenn eine erwartete Häufigkeit unter 5 fällt, verlieren der Pearson-Chi-Quadrat-Test und die Yates-Korrektur ihre mathematische Zuverlässigkeit. Weichen Sie auf den exakten Fisher-Test aus, der exakte hypergeometrische Wahrscheinlichkeiten ohne stetige Approximationsfehler ermittelt.

Häufige Fehlerquellen & Fehlerbehebung

⚠️Verletzung des Cochran-Kriteriums: Über 20 % der erwarteten Zellhäufigkeiten liegen unter 5

Zu kleine erwartete Häufigkeiten blähen die Chi-Quadrat-Prüfgröße künstlich auf und erzeugen Scheinsignifikanzen. Werten Sie bei 2x2-Tafeln direkt den exakten Fisher-Test aus. Bei größeren Tafeln (3x3, 4x4) sollten Sie logisch zusammenhängende oder klinisch verwandte Kategorien zusammenfassen (z. B. 'selten' und 'nie' fusionieren), um Zellen zu bündeln und E_ij ≥ 5 in mindestens 80 % der Zellen zu gewährleisten.

⚠️Division durch Null oder undefinierte Prüfgröße: Zeilen- oder Spaltenrandsumme ist null

Eine Zeile oder Spalte, deren Zellen allesamt null sind, erzeugt eine Randsumme von null, wodurch E_ij = 0 wird und eine mathematische Division durch Null entsteht. Entfernen Sie die vollständig leere Kategoriezeile oder -spalte aus der Kontingenztafel oder überprüfen Sie Ihre Dateneingabe auf Übertragungsfehler.

⚠️Signifikante Abweichung zwischen Pearson-χ² und dem Yates-korrigierten p-Wert

Die Stetigkeitskorrektur nach Yates zieht 0,5 von jeder absoluten Abweichung (|O - E| - 0,5) ab, um diskrete Zähldaten an die stetige Chi-Quadrat-Verteilung in 2x2-Tafeln anzugleichen. Dies verringert χ² bewusst und liefert einen konservativeren, höheren p-Wert. Bei kleinen Stichproben (N < 100) sollten Sie Yates oder dem exakten Fisher-Test vertrauen; bei großen klinischen Kohorten (N > 200) ist das unkorrigierte Pearson-χ² der anerkannte Standard.

Häufig gestellte Fragen (FAQ)

Wie berechnet man die Chi-Quadrat-Prüfgröße und den p-Wert aus einer Kontingenztafel?▼

Die Berechnung erfolgt in 5 Schritten: 1) Zeilen- und Spaltensummen der beobachteten Werte addieren, um die Randsummen sowie den Gesamtstichprobenumfang N zu erhalten; 2) Erwartete Häufigkeiten je Zelle über E_ij = (Zeilensumme × Spaltensumme) / N bestimmen; 3) Für jede Zelle (O_ij - E_ij)² / E_ij berechnen und alle Werte zur Prüfgröße χ² aufsummieren; 4) Freiheitsgrade über df = (Zeilen - 1) × (Spalten - 1) ermitteln; 5) Den p-Wert über das obere Integral der Chi-Quadrat-Dichtefunktion bestimmen: p = P(X² ≥ χ² | df). Ist p ≤ 0,05, liegt ein statistisch signifikanter Zusammenhang vor.

Welche Richtwerte gelten für Cramérs V zur Bestimmung der praktischen Effektstärke?▼

Die Interpretation von Cramérs V orientiert sich an den Freiheitsgraden df* = min(r - 1, c - 1). Bei klassischen 2x2-Vierfeldertafeln (df* = 1) entspricht V = 0,10 einem schwachen, V = 0,30 einem mittleren und V ≥ 0,50 einem starken Effekt. Bei größeren Tabellen mit df* = 2 (z. B. 3x3-Tafeln) verschieben sich die Schwellenwerte auf 0,07 (schwach), 0,21 (mittel) und 0,35 (stark), da sich die Varianz auf mehr Zellen verteilt und die Maßzahl naturgemäß geringer ausfällt.

Was ist der Unterschied zwischen einem Chi-Quadrat-Unabhängigkeitstest und einem Anpassungstest?▼

Der Chi-Quadrat-Unabhängigkeitstest analysiert bivariate Daten in einer zweidimensionalen Kontingenztafel (r × c), um zu prüfen, ob zwei kategoriale Variablen voneinander abhängen (df = (r - 1) × (c - 1)). Der Chi-Quadrat-Anpassungstest (Goodness-of-Fit) prüft dagegen eine einzelne univariate Variable über k Kategorien (1 × k), um festzustellen, ob die beobachteten Häufigkeiten einer theoretisch erwarteten Verteilung (wie einer Gleichverteilung über Wochentage oder Mendelschen Spaltungsverhältnissen) entsprechen (df = k - 1).

Wann sollte die Yates-Stetigkeitskorrektur bei einer 2x2-Tafel angewendet werden?▼

Die Yates-Stetigkeitskorrektur wird bei 2x2-Vierfeldertafeln mit moderaten Stichprobengrößen (zwischen 40 und 200) empfohlen, wenn diskrete Binomialverteilungen durch die stetige Chi-Quadrat-Kurve angenähert werden. Durch den Abzug von 0,5 von |O - E| verhindert Yates eine Überschätzung der Signifikanz (Alpha-Fehler). Bei sehr kleinen Stichproben (N < 40 oder E_ij < 5) ist der exakte Fisher-Test überlegen, während Yates bei großen Stichproben (N > 200) überkorrigiert und unnötig ist.

Was ist zu tun, wenn die erwarteten Zellhäufigkeiten unter 5 fallen?▼

Wenn mehr als 20 % der Zellen einer Kontingenztafel erwartete Häufigkeiten unter 5 aufweisen (Verletzung des Cochran-Kriteriums), wird die asymptotische Chi-Quadrat-Näherung ungenau. Bei 2x2-Tafeln wechselt man direkt zum exakten Fisher-Test, der exakte hypergeometrische Wahrscheinlichkeiten berechnet. Bei größeren Mehrfeldertafeln (z. B. 3x4) fasst man benachbarte, inhaltlich verwandte Kategorien zusammen (z. B. 'stimme überhaupt nicht zu' mit 'stimme nicht zu'), um die Zellbesetzungen über die 5er-Schwelle zu heben.

Wie identifizieren adjustierte standardisierte Residuen die signifikanten Zelltreiber?▼

Adjustierte standardisierte Residuen (Haberman-z-Werte) ermitteln die spezifischen Kategorien, die für ein signifikantes Gesamtergebnis verantwortlich sind, indem (O_ij - E_ij) durch den wahren asymptotischen Standardfehler geteilt wird: z = (O_ij - E_ij) / √[E_ij(1 - R_i/N)(1 - C_j/N)]. Da Habermans z standardnormalverteilt ist (N(0,1)), zeigt jede Zelle mit |z| > 1,96 eine statistisch signifikante Abweichung bei α = 0,05 und bei |z| > 2,58 eine Signifikanz bei α = 0,01.

Verwandte Tools & Hilfsprogramme

Alle Tools →