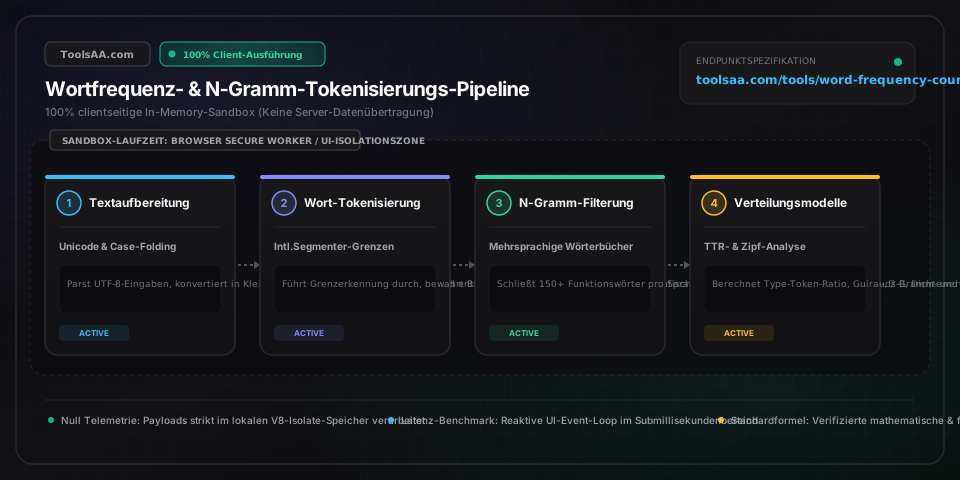
Worthäufigkeit zählen, Keyword-Dichte analysieren und 1-Gram- bis 3-Gram-Phrasen prüfen. Stoppwörter filtern, Wortwiederholungen aufdecken und Berichte exportieren.
Zählen Sie die Wortfrequenz, analysieren Sie die Keyword-Dichte und prüfen Sie 1-Gramm- bis 3-Gramm-Phrasen in Echtzeit. Filtern Sie Stoppwörter, erkennen Sie Wortwiederholungen und exportieren Sie CSV-Berichte.
Schließt hochfrequente funktionale Füllwörter (Artikel, Präpositionen, Konjunktionen, Hilfsverben) aus, um den inhaltstragenden semantischen Kernwortschatz zu isolieren. Typische deutsche Stoppwortlisten filtern 150 bis 250 grammatikalische Hilfswörter heraus, die im Schnitt 40 % bis 50 % des alltäglichen Textvolumens ausmachen.
Analysiert zusammenhängende Wortfolgen, um wiederkehrende Mehrwortausdrücke zu identifizieren. Ein 1-Gramm erfasst Einzelwörter, ein 2-Gramm (Bigramm) analysiert Wortpaare wie Adjektiv-Substantiv-Kombinationen, und ein 3-Gramm (Trigramm) deckt feste Redewendungen sowie formelhafte Textbausteine im Manuskript auf.
Misst den Wortschatzreichtum durch das Verhältnis der einzigartigen Wörter (Types) zur Gesamtzahl aller laufenden Wörter (Tokens). Ausgewogene, fesselnde Sachtexte und fundierte Abhandlungen weisen eine Quote zwischen 0,40 und 0,65 auf; Werte unter 0,35 deuten auf monotone Wiederholungen hin, während Werte über 0,75 für stark verdichtete Fachsprache stehen.
Berechnet den prozentualen Anteil eines primären Fokus-Keywords im Verhältnis zur Gesamtwortzahl des Textes. Der redaktionelle und suchmaschinenoptimierte Idealbereich liegt zwischen 1,0 % und 2,5 %; Werte über 3,0 % wirken unnatürlich und bergen das Risiko algorithmischer Abstrafungen wegen Keyword-Stuffings.
Menschliche Sprache folgt natürlicherweise dem Zipfschen Gesetz: Das zweithäufigste Wort kommt etwa halb so oft vor wie das häufigste, das dritthäufigste ein Drittel so oft. Durchbricht ein thematisches Fachwort diesen natürlichen Abfall und drängt sich neben gängigen grammatikalischen Bindewörtern unter die Top 3, wirkt der Text auf Lesende hölzern, erzwungen und repetitiv.
Die gemessene Wortschatzvielfalt sinkt mathematisch bedingt mit zunehmender Textlänge, da sich unverzichtbare Verbindungswörter ständig wiederholen, während neue Kernbegriffe abflachen. Vergleichen Sie bei Texten über 1.000 Wörtern entweder standardisierte Textabschnitte von je 400 Wörtern oder nutzen Sie wurzelbereinigte Kennzahlen, um ausführliche, tiefgehende Fachkapitel nicht ungerechtfertigt abzuwerten.
Entfernen Sie Hilfswörter niemals vor der Analyse von 2-Grammen oder 3-Grammen, da sonst unnatürliche Wortfetzen wie 'Training Marathon Zielzeit' statt 'Training für die Marathon-Zielzeit' entstehen. Extrahieren Sie Phrasenmuster stets zuerst aus dem ungefilterten Volltext und sortieren Sie erst danach Kombinationen aus, die ausschließlich aus reinen grammatikalischen Füllwörtern bestehen.
Suchmaschinen wie Google fassen flektierte Wortformen und Komposita (z. B. 'gesunder Snack', 'gesunde Snacks', 'Snacking') über Lemmatisierung zu einer einheitlichen thematischen Entität zusammen. Streuen Sie natürliche Synonyme und grammatikalische Variationen über den gesamten Text, anstatt exakt denselben Begriff monoton zu wiederholen – so bleibt die kumulierte Themendichte stabil im optimalen Bereich von 1,5 % bis 2,5 %.
Deutsche Komposita mit Bindestrich (wie 'Low-Carb-Diät') oder Abkürzungen mit Apostroph werden von zu aggressiven Bereinigungsfiltern oft zerstückelt. Eine präzise linguistische Wortgrenzenerkennung behält solche Fügungen als zusammenhängende Lexeme bei, damit Phrasenzählungen exakt der menschlichen Lesewahrnehmung entsprechen.
Wenn alltägliche Pronomen und Verben (wie 'sie', 'unser', 'werden', 'sein') die oberen Ränge der Frequenztabelle dominieren, prüfen Sie, ob die Stoppwort-Filterung aktiviert ist. Tragen Sie projektspezifische Wiederholungen (wie 'Abschnitt', 'Klick' oder 'Kapitel') einfach in die benutzerdefinierte Ausschlussliste ein.
Sehr kurze Textpassagen bieten keine ausreichende Stichprobengröße für statistische Wortschatzanalysen und erzeugen scheinbar exzellente TTR-Werte von über 0,85. Nutzen Sie Textproben von mindestens 250 bis 400 Wörtern, um ein verlässliches Bild des tatsächlichen sprachlichen Ausdrucksvermögens zu erhalten.
Die Keyword-Dichte wird berechnet, indem die absolute Häufigkeit eines Begriffs durch die Gesamtwortzahl des Dokuments geteilt und mit 100 multipliziert wird: Dichte = (Anzahl des Zielbegriffs / Gesamtwortzahl) * 100 %. Beispiel: Enthält ein Fachartikel 800 Wörter und ein Fokus-Keyword kommt 16-mal vor, beträgt die exakte Keyword-Dichte (16 / 800) * 100 = 2,0 %.
Ein gesunder, bewährter Richtwert für primäre Fokus-Keywords im deutschsprachigen Raum liegt zwischen 1,0 % und 2,5 %. Diese Spanne signalisiert Suchmaschinen eine klare thematische Relevanz, ohne Qualitätsfilter zu aktivieren. Dichten von über 3,0 % bis 3,5 % bergen gemäß den Google Search Essentials das Risiko einer Einstufung als unnatürliches Keyword-Stuffing.
Die klassische Wortfrequenz zählt isolierte Einzelwörter unabhängig von ihrem grammatikalischen Kontext. Die N-Gramm-Frequenz erfasst hingegen zusammenhängende Wortfolgen: Ein 1-Gramm ist ein Einzelwort, ein 2-Gramm (Bigramm) eine zweigliedrige Fügung wie 'gesunde Ernährung' und ein 3-Gramm (Trigramm) ein dreigliedriger Ausdruck wie 'Schutz der Privatsphäre'. N-Gramme machen Floskeln, Redewendungen und Mehrwortbegriffe sichtbar.
Die Type-Token-Ratio (TTR) ist das Standardmaß für den lexikalischen Reichtum eines Textes und berechnet sich als Verhältnis der unterschiedlichen Wörter (Types) zur Gesamtwortzahl (Tokens): TTR = Einzigartige Wörter / Gesamtwortzahl. Für Publikationen, Aufsätze und Sachartikel zwischen 400 und 1.000 Wörtern gilt ein TTR-Wert zwischen 0,45 und 0,65 als ausgewogen und ansprechend. Werte unter 0,40 deuten auf monotone Formulierungen hin, während Werte über 0,70 für einen anspruchsvollen, nuancierten Wortschatz stehen.
Das Zipfsche Gesetz beschreibt die universelle linguistische Gesetzmäßigkeit, nach der die Häufigkeit eines Wortes umgekehrt proportional zu seinem Rang in der Häufigkeitsliste ist (Häufigkeit proportional zu 1 / Rang). In Standardtexten macht das häufigste Wort ('der' bzw. 'die/das') etwa 6 % bis 7 % aller Wörter aus, das zweithäufigste rund 3,5 % und das dritthäufigste etwa 2,5 %. Diese Verteilung dient als objektiver Maßstab, um unnatürlich platziertes Keyword-Spamming mathematisch nachzuweisen.
Ermitteln Sie die Lesezeit für stilles Lesen und Vortragsdauer bei anpassbaren WPM-Raten mit Zeichenzählung und Flesch-Lesbarkeitsbewertung. 100% privat.
Vergleichen Sie Quellcode, JSON und Dokumente nebeneinander oder in einheitlicher Ansicht mit zeichengenauer Differenzanzeige und Leerzeichen-Filterung.
Konvertieren Sie Text und Code-Variablen blitzschnell zwischen camelCase, PascalCase, snake_case, kebab-case, CONSTANT_CASE und 15 Namenskonventionen.
Präzise Textanalyse-Engine zur Ermittlung von Wörtern, Zeichen mit/ohne Leerzeichen, Sätzen, Absätzen, Lese- und Sprechdauer sowie Keyword-Dichte.
Wandeln Sie Artikeltitel und Sonderzeichen in saubere, URL-sichere SEO-Slugs mit anpassbaren Trennzeichen, Kleinschreibung und Transliteration um.
Erstellen Sie Retro-ASCII-Textbanner, Terminal-Rahmen-Header und mehrschriftige Code-Kommentarblöcke mit anpassbaren Schriftstilen, Rahmenzeichen und kopierbarem Text.