Frecuencia de Palabras & Densidad SEO

Frecuencia de Palabras & Densidad SEO

Calcula la frecuencia de palabras, analiza la densidad de keywords y examina n-gramas de 1 a 3 términos. Filtra palabras vacías (stopwords), detecta repeticiones y exporta informes en CSV.

Casos prácticos:
Texto de entrada
2.5%
Longitud mínima de término
Palabras vacías personalizadas
Palabras: 82Caracteres: 631Líneas: 1Oraciones: 5
Tiempo de lectura: 25 s
Total de palabras6782 Tokens brutos
Palabras únicas54Palabras distintas
Ratio Tipo-Token (TTR)80.6%Razón Tipo-Token (TTR)
Longitud media de palabra7.2Caracteres por token
Términos más repetidos
Umbral máximo aconsejado ≤ 2.5%
#1keyword
5 apariciones
7.46%
#2search
5 apariciones
7.46%
#3density
3 apariciones
4.48%
#4engine
2 apariciones
2.99%
#5target
2 apariciones
2.99%
#6topic
2 apariciones
2.99%
#7algorithmic
1 apariciones
1.49%
#8article
1 apariciones
1.49%
#9authoritative
1 apariciones
1.49%
#10balanced
1 apariciones
1.49%
Evaluación del tono: Excelente riqueza léxica
Estado del motor analítico
Total de palabras67
Palabras únicas54
Tasa de diversidad léxica80.6%
Referencia técnica y guía de arquitectura

Frecuencia de Palabras & Densidad SEO — Guía de referencia

Calcula la frecuencia de palabras, analiza la densidad de palabras clave e inspecciona n-gramas al instante. Filtra palabras vacías, detecta repeticiones y exporta en CSV.

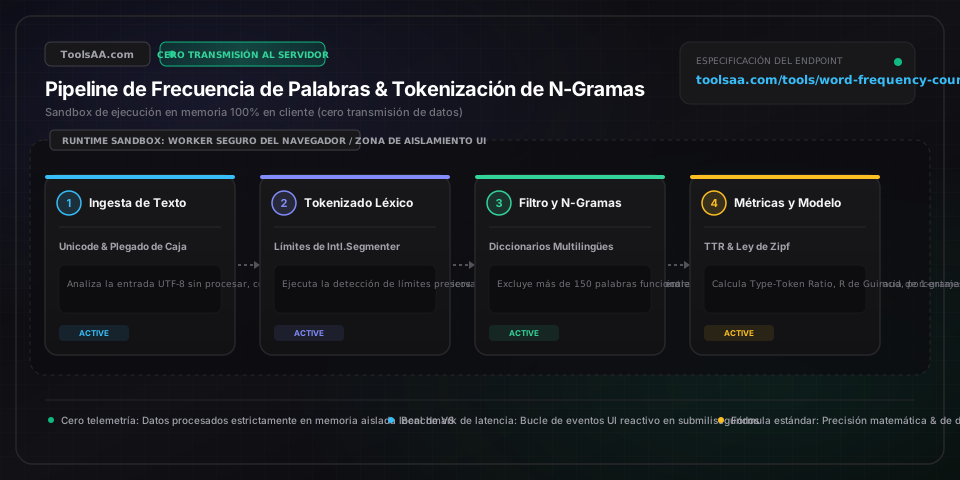
Frecuencia de Palabras & Densidad SEO — Guía de referencia — Arquitectura en memoria del lado del cliente y flujo de datos

Parámetros clave y controles

Filtro de palabras vacías (Stopwords)perfil de exclusión léxica y gramatical

Excluye palabras funcionales de alta frecuencia (artículos, preposiciones, conjunciones y verbos auxiliares) para aislar el vocabulario semántico real. Las listas estándar eliminan entre 150 y 200 conectores gramaticales, que suelen representar entre el 40 % y el 50 % del volumen de un texto cotidiano.

Por defecto: Español (175 palabras vacías)
Ventana de colocación de N-gramasagrupación de secuencias de palabras

Examina cadenas continuas de varias palabras para detectar frases recurrentes. Un 1-grama analiza términos individuales, un 2-grama o bigrama resalta pares como modificadores descriptivos y un 3-grama o trigrama detecta modismos y muletillas habituales a lo largo del borrador.

Por defecto: 1-Grama (Palabras individuales)
Umbral de Riqueza Léxica (TTR)índice de diversidad léxica

Mide la variedad del vocabulario dividiendo los términos léxicos únicos entre el número total de palabras del texto. En ensayos académicos y textos divulgativos equilibrados, la proporción oscila entre 0,40 y 0,65; valores inferiores a 0,35 denotan reiteración léxica, mientras que marcas superiores a 0,75 reflejan una prosa sumamente técnica y condensada.

Por defecto: 0,50 (Divulgación estándar)
Límite de densidad de palabras clave SEOporcentaje objetivo de aparición

Calcula el porcentaje exacto que representa una frase clave en relación con la extensión total del contenido. El estándar editorial recomendado se sitúa entre el 1,0 % y el 2,5 %; superar el 3,0 % genera una lectura forzada y artificial, activando alertas por repetición antinatural en los motores de búsqueda.

Por defecto: 2,5 % Densidad máxima

Consejos profesionales y mejores prácticas

Ley de Zipf como referencia lingüística

El lenguaje humano sigue de forma natural la ley de Zipf: la segunda palabra más común aparece aproximadamente la mitad de veces que la primera, y la tercera, un tercio. Si un término temático principal rompe esta curva de caída natural y se cuela en las tres primeras posiciones junto a artículos o preposiciones, el texto transmitirá rigidez y artificialidad a los lectores.

Distorsión del TTR por extensión textual

La diversidad léxica disminuye de manera natural a medida que el artículo se extiende, ya que los conectores se repiten mientras que los conceptos nuevos se estabilizan. Al evaluar publicaciones extensas de más de 1.000 palabras, compara la riqueza en bloques uniformes de 400 palabras o utiliza fórmulas ajustadas a la raíz para no penalizar capítulos rigurosos y profundos.

Preservación de conectores en secuencias de N-gramas

Evita eliminar las palabras vacías antes de extraer frases de dos o tres términos, ya que generarías combinaciones artificiales como «entrenamiento maratón ritmo» en lugar de «entrenamiento para un maratón». Lo óptimo es registrar las secuencias sobre el texto original íntegro y descartar a posteriori únicamente aquellas compuestas de forma exclusiva por nexos gramaticales.

Lematización y agrupación temática en buscadores

Los rastreadores de motores de búsqueda agrupan automáticamente variaciones como «merienda saludable», «meriendas saludables» y «merendar sano» en una única entidad temática. Distribuye sinónimos e inflexiones de manera orgánica en lugar de repetir la misma frase exacta, manteniendo la presencia global del tema cómodamente entre el 1,5 % y el 2,5 %.

Problemas comunes y soluciones

⚠️Palabras compuestas con guion o apóstrofos divididas en fragmentos sueltos

Términos como «físico-químico» o giros como «d'Or» pueden fragmentarse si se aplica una limpieza de puntuación excesivamente agresiva. La segmentación basada en límites lingüísticos estándar conserva estos compuestos como unidades léxicas indivisibles para que el conteo refleje la lectura humana real.

⚠️Pronombres comunes y verbos auxiliares saturando los términos clave

Si pronombres cotidianos (como «ellos», «nuestro» o «este») dominan las primeras posiciones del recuento, comprueba que el filtro de palabras vacías esté activo. Para eliminar muletillas o términos específicos de tu proyecto (como «sección», «clic» o «capítulo»), agrégalos a la lista de exclusiones personalizadas.

⚠️Borradores breves de menos de 100 palabras con diversidad léxica engañosa

Los fragmentos cortos carecen de la masa crítica necesaria para un cálculo estadístico fiable de la riqueza léxica, arrojando valores artificialmente altos por encima de 0,85. Amplía la muestra a un mínimo de 250 palabras para obtener una métrica representativa de la verdadera variedad de tu vocabulario.

Preguntas frecuentes (FAQ)

¿Cómo se calcula la frecuencia de palabras y la densidad de palabras clave?▼

La densidad de palabras clave se calcula dividiendo el número de apariciones de un término específico entre el total de palabras del documento y multiplicando el resultado por 100: Densidad = (Apariciones de la palabra / Total de palabras) * 100. Por ejemplo, en un artículo de 800 palabras donde un término clave aparece 16 veces, la densidad exacta es (16 / 800) * 100 = 2,0 %.

¿Cuál es el porcentaje recomendado de densidad de palabras clave para SEO?▼

Una densidad óptima para los términos de búsqueda principales se sitúa entre el 1,0 % y el 2,5 %. Mantenerse en este rango demuestra relevancia temática sin activar filtros de calidad algorítmicos. Superar el 3,0 % o 3,5 % conlleva el riesgo de penalizaciones por sobreoptimización artificial o relleno de palabras clave (keyword stuffing) según las directrices de Google Search Essentials.

¿Cuál es la diferencia entre frecuencia de palabras y frecuencia de n-gramas?▼

La frecuencia de palabras contabiliza términos individuales aislados sin considerar el contexto inmediato, mientras que la frecuencia de n-gramas mide secuencias continuas de varias palabras. Un 1-grama registra vocablos sueltos, un 2-grama rastrea combinaciones de dos palabras como «zapatillas running» y un 3-grama analiza expresiones de tres términos como «frecuencia cardíaca máxima», permitiendo identificar frases recurrentes y muletillas editoriales.

¿Qué es la proporción Type-Token (TTR) y cuál es un valor adecuado?▼

La proporción Type-Token (TTR o Type-Token Ratio) mide la riqueza léxica dividiendo la cantidad de palabras únicas (types) entre el número total de palabras (tokens): TTR = Palabras únicas / Total de palabras. En artículos divulgativos, ensayos y textos formativos de entre 400 y 1.000 palabras, un valor equilibrado oscila entre 0,45 y 0,65; resultados inferiores a 0,40 reflejan reiteración léxica, mientras que cifras superiores a 0,70 demuestran un vocabulario amplio y variado.

¿Cómo se aplica la ley de Zipf a la frecuencia de palabras en un texto?▼

La ley de Zipf es un principio lingüístico universal que establece que la frecuencia de aparición de una palabra es inversamente proporcional a su posición en la tabla de frecuencias (frecuencia proporcional a 1 / rango). En un escrito convencional, la palabra más común representa cerca del 7 % del total, la segunda alrededor del 3,5 % y la tercera un 2,8 %, sirviendo como punto de referencia objetivo para detectar redacciones forzadas o inserciones artificiales de palabras clave.

Herramientas y utilidades relacionadas

Todas las herramientas →