Analysez la fréquence des termes, la densité de mots-clés et les n-grammes de 1 à 3 mots en temps réel. Filtrez les mots vides, repérez les sur-optimisations et exportez en CSV.
Mesurez la fréquence des mots, analysez la densité lexicale et inspectez les n-grammes (1 à 3 mots). Filtrez les mots vides, repérez les répétitions et exportez vos rapports CSV.
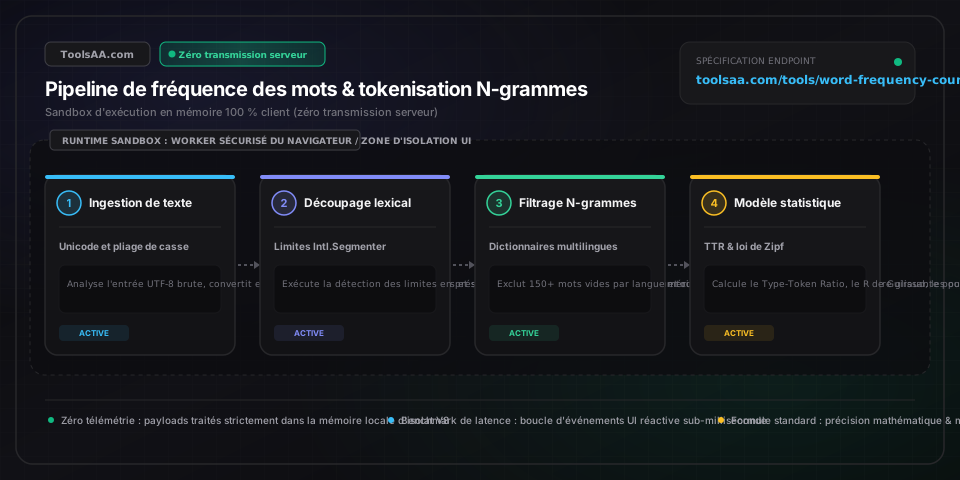
Exclut les mots-outils et termes fonctionnels à haute fréquence (articles, prépositions, conjonctions, auxiliaires) afin d'isoler le lexique sémantique utile. Une liste standard élimine 150 à 200 mots de liaison, représentant habituellement 40 % à 50 % du volume d'un texte courant.
Analyse les suites continues de termes pour détecter les expressions récurrentes. Un 1-gramme isole les mots uniques, un 2-gramme (bigramme) identifie les associations de deux mots, et un 3-gramme (trigramme) repère les locutions figées et les tournures répétitives de votre rédaction.
Évalue la richesse du vocabulaire en divisant le nombre de lemmes uniques par le volume global de mots. Un article équilibré ou un essai fluide se situe généralement entre 0,40 et 0,65 ; un score inférieur à 0,35 traduit un style répétitif, tandis qu'une valeur supérieure à 0,75 indique une prose dense et très spécialisée.
Calcule la part exacte occupée par une expression cible par rapport à la longueur totale du texte. La norme éditoriale préconise un ratio compris entre 1,0 % et 2,5 % ; dépasser 3,0 % rend la lecture artificielle et expose votre contenu aux pénalités algorithmiques de Google pour sur-optimisation.
Le discours humain obéit naturellement à la loi de Zipf : le deuxième mot le plus récurrent apparaît environ deux fois moins souvent que le premier, et le troisième trois fois moins souvent. Si un terme sémantique majeur brise cette décroissance et s'impose dans le trio de tête aux côtés des mots-outils courants, votre texte paraîtra rigide, forcé et déplaisant pour le lecteur.
L'indice de diversité lexicale diminue mécaniquement à mesure qu'un texte s'allonge, car les mots de liaison se répètent inévitablement tandis que le réservoir de nouveaux concepts se stabilise. Pour évaluer un dossier ou un article de plus de 1 000 mots, comparez des tranches homogènes de 400 mots ou employez un indice racinaire (Root TTR) afin de ne pas pénaliser les rédactions exhaustives.
Ne supprimez jamais les mots de liaison avant d'extraire des bigrammes ou des trigrammes, sous peine de générer des locutions artificielles comme « entraînement marathon allure » au lieu d'« allure d'entraînement marathon ». Capturez d'abord les séquences sur le texte brut original, puis filtrez les segments composés exclusivement de mots vides.
Les robots d'indexation associent automatiquement les variantes morphologiques comme « collation saine », « collations saines » ou « goûter équilibré » à une entité thématique unique. Diversifiez vos synonymes au lieu de marteler une expression identique mot pour mot, en conservant une empreinte thématique globale comprise entre 1,5 % et 2,5 %.
Les élisions courantes (comme « aujourd'hui », « l'arbre », « c'est ») ou les adjectifs composés (« bien-être », « court-circuit ») peuvent être fragmentés par une segmentation de ponctuation trop agressive. Notre moteur intègre une détection de frontière lexicale francophone qui préserve ces unités textuelles pour refléter le décompte réel perçu par le lecteur.
Si des termes fonctionnels (tels que « nous », « leur », « être », « avoir ») monopolisent le haut du classement, assurez-vous que le filtre de mots vides est bien actif. Pour les tics de langage ou les répétitions propres à votre thématique (comme « section », « cliquez », « chapitre »), ajoutez-les directement à votre liste d'exclusion personnalisée.
Un échantillon trop restreint ne fournit pas la matière statistique nécessaire pour calculer la variété lexicale, affichant souvent des scores trompeurs supérieurs à 0,85. Analysez un extrait d'au moins 250 mots pour obtenir une vision fidèle et représentative de la richesse de votre écriture.
La densité d'un mot-clé se calcule en divisant le nombre d'occurrences du mot cible par le nombre total de mots du document, puis en multipliant par 100 : Densité = (Occurrences du mot / Nombre total de mots) × 100 %. Par exemple, dans un texte de 800 mots où une expression clé apparaît 16 fois, la densité exacte est de (16 / 800) × 100 = 2,0 %.
Une densité optimale pour une requête principale se situe entre 1,0 % et 2,5 %. Cette fourchette garantit une pertinence thématique solide sans déclencher les filtres antispam des moteurs de recherche, alors qu'une concentration supérieure à 3,0 % ou 3,5 % expose la page à des pénalités selon les consignes Google Search Essentials pour bourrage de mots-clés (keyword stuffing).
La fréquence de mots comptabilise des termes isolés sans tenir compte de leur contexte immédiat, tandis que la fréquence de n-grammes analyse des séquences contiguës de plusieurs mots. Un 1-gramme mesure un mot unique, un 2-gramme recense des binômes comme « chaussures de running », et un 3-gramme suit des expressions complètes comme « rythme cardiaque maximal », mettant en lumière les tics d'écriture et les tournures clés.
Le ratio Type-Token (TTR) mesure la richesse lexicale en divisant le nombre de mots uniques (types) par le nombre total de mots (tokens) : TTR = Mots uniques / Mots totaux. Pour les articles de presse, blogs et mémoires comptant entre 400 et 1 000 mots, un score équilibré oscille entre 0,45 et 0,65 ; en dessous de 0,40, le style souffre de redondances, tandis qu'au-dessus de 0,70, il dénote un vocabulaire particulièrement riche et varié.
La loi de Zipf est un principe linguistique fondamental stipulant que la fréquence d'apparition d'un mot est inversement proportionnelle à son rang dans l'ordre des fréquences (fréquence ∝ 1 / rang). Dans un texte standard, le terme le plus fréquent représente environ 7 % du volume, le deuxième ~3,5 %, et le troisième ~2,8 %, offrant un étalon objectif pour déceler une surcharge artificielle ou une suroptimisation lexicale.
Estimez le temps de lecture silencieuse et la durée de discours oral selon votre vitesse (MPM) avec décompte de mots et score de lisibilité de Flesch.
Comparez du code source, des données JSON et du texte en mode côte à côte ou unifié avec surbrillance précise des caractères et gestion des espaces.
Convertissez instantanément du texte et des variables de code entre camelCase, PascalCase, snake_case, kebab-case, CONSTANT_CASE et 15 conventions de nommage.
Moteur d'analyse textuelle haute précision calculant le nombre de mots, caractères avec/sans espaces, phrases, paragraphes, durée de lecture et densité de mots-clés.
Convertissez vos titres et textes accentués en slugs d'URL propres et sécurisés pour le SEO avec séparateurs sur mesure et translitération Unicode.
Générez des bannières texte ASCII rétro, des en-têtes de terminal encadrés et des blocs de commentaires de code avec des styles de police personnalisables, des bordures et du texte copiable.