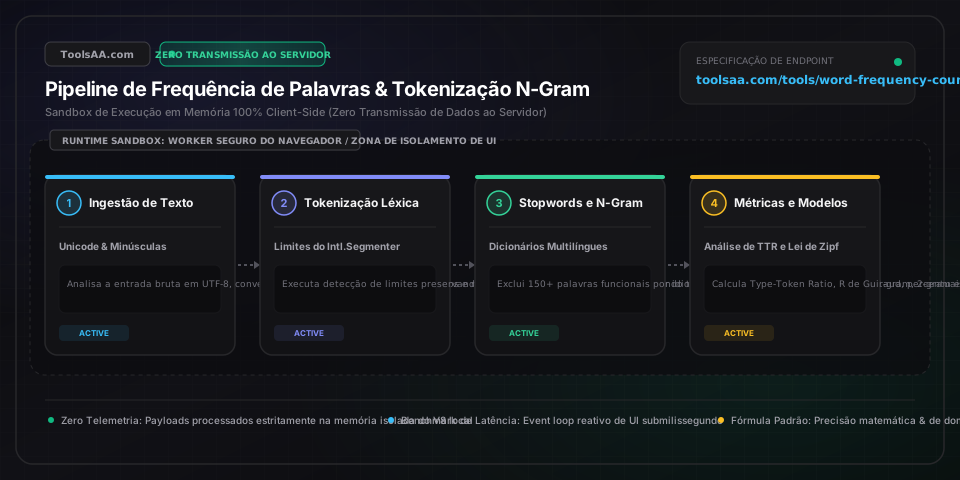
Conte a frequência de palavras, analise a densidade de palavras-chave e n-gramas em tempo real. Filtre stop words, evite repetições e exporte relatórios em CSV.
Conte a frequência de palavras, analise a densidade de palavras-chave e inspecione frases de 1-gram a 3-gram instantaneamente. Filtre stopwords, detecte termos repetitivos e exporte relatórios em CSV.
Exclui palavras funcionais de alta frequência (artigos, preposições, conjunções e verbos auxiliares) para isolar o vocabulário semântico real. Listas padrão de stopwords em português eliminam de 150 a 200 conectivos gramaticais, que costumam representar de 40% a 50% do volume total de um texto cotidiano.
Examina sequências contínuas de termos para revelar frases repetidas. Um 1-gram monitora vocábulos isolados, um 2-gram destaca pares como modificadores descritivos e um 3-gram identifica expressões idiomáticas recorrentes e clichês ao longo do seu rascunho.
Mede a variedade de vocabulário dividindo os termos únicos pelo número total de palavras do texto. Redações e artigos informativos equilibrados mantêm uma pontuação entre 0,40 e 0,65; valores abaixo de 0,35 indicam redação redundante, enquanto índices acima de 0,75 refletem prosa técnica densa e especializada.
Calcula a participação percentual exata do termo de foco principal em relação à extensão total do documento. O padrão editorial recomendado para SEO varia de 1,0% a 2,5%; ultrapassar 3,0% torna a leitura robótica e arrisca penalidades algorítmicas por repetição artificial.
A fala e a escrita humana seguem naturalmente a Lei de Zipf, na qual a segunda palavra mais frequente surge aproximadamente com metade da frequência da primeira, e a terceira com um terço. Se uma palavra conceitual chave quebrar essa curva natural de decaimento e invadir as três primeiras posições junto a conectivos comuns, seu artigo soará travado e maçante para os leitores.
A pontuação de diversidade de vocabulário cai naturalmente à medida que o texto se estende, pois os conectivos gramaticais se repetem enquanto novos conceitos se estabilizam. Ao avaliar ensaios longos com mais de 1.000 palavras, compare a diversidade em blocos consistentes de 400 palavras ou adote fórmulas ajustadas por raiz para não penalizar capítulos aprofundados.
Nunca remova palavras de ligação antes de analisar combinações de duas ou três palavras; caso contrário, você gerará fragmentos artificiais como 'treino maratona ritmo' em vez de 'treino para uma maratona'. Colete primeiro os padrões de frases do texto original inalterado e só então descarte agrupamentos formados unicamente por termos funcionais.
Os rastreadores de busca agrupam variações lexicais como 'lanche saudável', 'lanches saudáveis' e 'alimentação saudável' em uma única entidade semântica. Distribua sinônimos naturais ao longo do conteúdo em vez de repetir a mesma frase idêntica, garantindo que a presença temática cumulativa permaneça com segurança na faixa de 1,5% a 2,5%.
Expressões com apóstrofo e termos compostos com hífen (como 'bem-estar' ou 'guarda-chuva') podem ser fragmentados por limpadores de pontuação excessivamente agressivos. A detecção adequada de fronteiras linguísticas preserva esses compostos unidos como termos únicos, mantendo a contagem fiel à percepção real do leitor.
Se pronomes do dia a dia (como 'eles', 'nosso', 'isso') dominarem o topo da tabela de frequência, certifique-se de que a Filtragem de Stopwords está ativada. Para termos repetitivos específicos do seu projeto (como 'seção', 'clique' ou 'capítulo'), adicione-os à lista de exclusão personalizada.
Amostras muito breves não fornecem volume estatístico suficiente para o cálculo de variedade vocabular, gerando índices enganosos acima de 0,85. Amplie o texto para pelo menos 250 palavras a fim de obter um reflexo fidedigno da verdadeira riqueza do seu vocabulário.
A densidade de palavras-chave é obtida dividindo a quantidade de vezes que a palavra-chave aparece pelo número total de palavras do documento e multiplicando por 100: Densidade = (Contagem do Termo / Total de Palavras) * 100%. Por exemplo, em um artigo de 800 palavras no qual a expressão foco aparece 16 vezes, a densidade exata é (16 / 800) * 100 = 2,0%.
A faixa ideal para termos de busca primários situa-se entre 1,0% e 2,5%. Manter a densidade nesse intervalo sinaliza forte relevância temática sem acionar filtros de qualidade, enquanto percentuais superiores a 3,0% ou 3,5% correm sério risco de punição pelas diretrizes do Google Search Essentials por prática abusiva de repetição (keyword stuffing).
A frequência de palavras contabiliza termos individuais isolados, sem considerar o contexto imediato, enquanto a frequência de n-grams quantifica sequências contínuas de múltiplos termos. Um 1-gram mede palavras avulsas, um 2-gram analisa combinações de dois termos como 'tênis de corrida' e um 3-gram rastreia expressões de três termos como 'frequência cardíaca máxima', identificando vícios de linguagem e temas centrais.
A Razão Tipo-Token (Type-Token Ratio ou TTR) mensura a variedade vocabular dividindo o número de palavras únicas (tipos) pelo total de palavras corridas (tokens): TTR = Palavras Únicas / Total de Palavras. Para publicações gerais, artigos acadêmicos e redações entre 400 e 1.000 palavras, um índice saudável situa-se entre 0,45 e 0,65; índices abaixo de 0,40 indicam vocabulário repetitivo, enquanto valores acima de 0,70 evidenciam uma redação rica e expressiva.
A Lei de Zipf é um princípio linguístico fundamental que estabelece que a frequência de uma palavra é inversamente proporcional à sua classificação no ranking de ocorrências (a frequência é proporcional a 1 / posição no ranking). Em textos naturais em português, o vocábulo mais frequente (como 'de' ou 'o') representa cerca de 6% a 7% de todas as palavras, o segundo ('a' ou 'que') cerca de 3,5%, e o terceiro cerca de 2,5%, servindo como padrão matemático para identificar inserções forçadas ou artificiais de palavras-chave.
Estime o tempo de leitura silenciosa e a duração de discursos com base em palavras por minuto (PPM), contagem de caracteres e índice de legibilidade Flesch.
Compare códigos-fonte, JSON e textos lado a lado ou em visualização unificada com destaque de caracteres alterados e filtros de espaçamento.
Converta variáveis de código e textos entre camelCase, PascalCase, snake_case, kebab-case, CONSTANT_CASE e 15 padrões de nomenclatura instantaneamente.
Motor analítico de texto que calcula palavras, caracteres com/sem espaços, frases, parágrafos, tempo de leitura/fala e densidade de palavras-chave.
Converta títulos, acentos e textos multilíngues em slugs limpos e amigáveis para SEO com delimitadores personalizados e transliteração automática.
Gere banners de texto ASCII retrô, cabeçalhos de terminal em caixa e blocos de comentários de código com estilos de fonte personalizáveis, caracteres de borda e texto copiável.