Calculateur Régression Linéaire & R²
Haute précision

Calculateur Régression Linéaire & R²

Calculateur interactif de régression linéaire (méthode des moindres carrés et R²) avec analyse et visualisation en temps réel 100 % côté client.

Confidentialité 100 % côté client
Traitement côté client
Exemples prédéfinis

Données d'entrée

12 Nombre de points valides

Format attendu : un point par ligne sous la forme X, Y (ex. : 12.5, 45.2) ou collez directement des colonnes depuis Excel ou un fichier CSV.

Model Intercept:
Niveau de confiance:
12 Nombre de points validesSS_xx: 943.00
Équation de régression:ŷ = 1.2856x - 150.8889
R²: 0.9982r: 0.9991sₑ: 0.5242
54.663.372.080.889.598.2159.7166.4173.1179.9186.6193.3Height (cm)Weight (kg)
Force de la corrélation:Très forte corrélationClick anywhere inside the chart area to set prediction X
Degrés de liberté: 10F-Stat: 5672.30
Coefficient R²
99.82%
R² ajusté: 0.9981
Coefficient r de Pearson
0.9991
Pente positive
Erreur type des résidus
0.5242
Échantillon (n): 12 Observations

Traitement côté client

Calcul haute performance exécuté intégralement dans la mémoire du navigateur.

Zéro transfert serveur

Toutes les données restent strictement locales, sans aucune transmission vers des serveurs tiers.

Export prêt pour la production

Formats de sortie propres et optimisés, prêts pour vos intégrations immédiates.

Outil d'analyse statistique basé sur la méthode des moindres carrés ordinaires (OLS). Vérifiez l'adéquation de vos données avant toute décision en production.
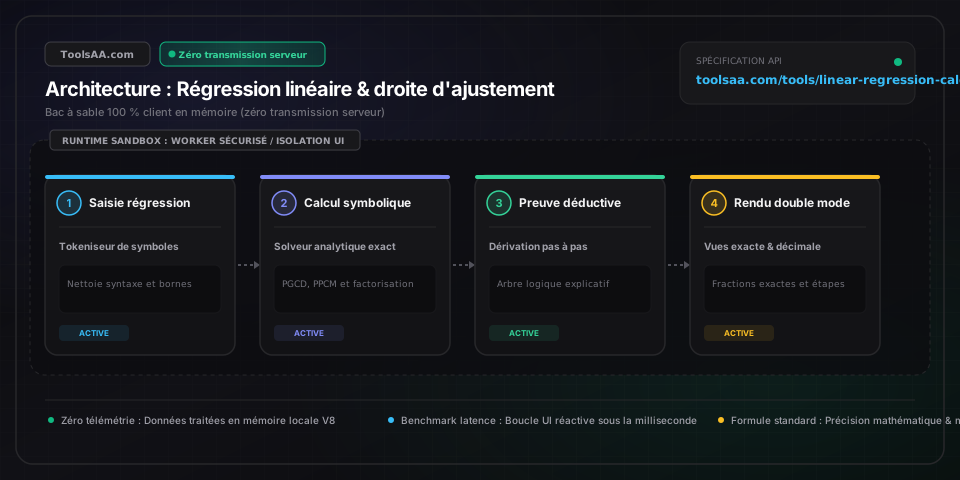
Référence technique et guide d'architecture

Régression linéaire & calcul R² — Guide de référence

Calculateur interactif de régression linéaire (droite des moindres carrés et R²) avec analyse et visualisation en temps réel côté client sans transfert de données.

Régression linéaire & calcul R² — Guide de référence — Architecture en mémoire côté client et flux de données

Paramètres clés et contrôles

observations_bivariees_apparieesPaires de coordonnées cartésiennes (X, Y)

Observations appariées de la variable explicative indépendante (X) et du critère dépendant (Y), évaluées via un algorithme d'accumulation en une seule passe de type Welford garantissant une complexité temporelle déterministe en O(n) et un espace mémoire auxiliaire en O(1). Conformément à la norme IEEE 754 en virgule flottante double précision 64 bits, les valeurs doivent rester finies (magnitude absolue < 1,7976931348623157e+308). La somme des carrés des écarts SSxx = Σ(xᵢ - x̄)² doit être strictement supérieure à l'epsilon machine (SSxx > 1e-15) pour un échantillon n ≥ 3, afin d'éviter toute divergence de matrice singulière et toute exception d'exécution de division par zéro.

Par défaut : (10, 25), (20, 38), (30, 52), (40, 68), (50, 84)
seuil_signification_alphaNiveau de signification du test [0,001 ; 0,20]

Seuil critique de signification bilatéral α déterminant l'intervalle de confiance (1 - α) pour la pente de régression β₁ et la réponse moyenne de la population. Selon les standards empiriques ISO/CEI et NIST, la valeur α = 0,05 étalonne l'intervalle de confiance à 95 % avec la valeur critique de la loi de Student t_(0,025, n-2). Pour les analyses confirmatoires exigeant un contrôle strict de l'erreur de type I (faux positifs), α est paramétré à 0,01 (IC à 99 %) ou ajusté par correction globale de Bonferroni.

Par défaut : 0.05
cible_interpolation_predictionScalaire Float64 en domaine continu

Coordonnée de la variable indépendante cible X₀ évaluée pour l'estimation ponctuelle conditionnelle ŷ₀ = b₀ + b₁X₀ et les bandes de prédiction individuelle. Statistiquement circonscrite à l'enveloppe convexe empirique observée [min(X), max(X)] ; toute extrapolation hors domaine engendre une erreur de spécification structurelle critique, car l'erreur type de prédiction SE_pred = Se · √(1 + 1/n + (X₀ - x̄)² / SSxx) croît quadratiquement par rapport au centroïde moyen x̄.

Par défaut : 35.0
seuil_influence_levierMétrique de distance de Cook [0,0 ; +∞)

Critère diagnostique d'influence Di identifiant les points de levier extrêmes qui déséquilibrent de manière disproportionnée l'hyperplan orthogonal des moindres carrés ordinaires (MCO / OLS). Délimité par le seuil usuel de Cook-Weisberg Di > 4/n (ou le seuil absolu Di > 1,0) conjugué aux résidus studentisés supprimés |rᵢ| > 3,0. Les points signalés révèlent un fort effet de levier sur la diagonale de la matrice chapeau h_ii > 2p/n, altérant la stabilité des paramètres estimés.

Par défaut : 4 / n

Conseils de pro et bonnes pratiques

Éliminer l'annulation numérique par centrage sur la moyenne

Le calcul de la somme des carrés bivariée via l'identité théorique SSxx = Σx² - (Σx)² / n provoque une annulation catastrophique en virgule flottante IEEE 754 double précision lorsque les coordonnées sont élevées avec une faible dispersion (comme des horodatages Unix où (Σx)² / n coïncide avec Σx² sur 14 chiffres de mantisse). ToolsAA applique l'accumulation d'écarts en passe unique de Welford centrée sur la moyenne x̄ (x' = x - x̄), garantissant une covariance d'estimateur nulle Cov(b₀, b₁) = 0, supprimant la troncature numérique jusqu'à l'epsilon machine et assurant une complexité en O(n) sans allocation de mémoire auxiliaire.

Un R² élevé masque la non-linéarité sans test de Breusch-Pagan

Un coefficient de détermination R² supérieur à 0,95 ne suffit pas à valider l'adéquation d'un modèle de régression par moindres carrés ordinaires (MCO). Comme l'illustre le quartet d'Anscombe, une forte courbure quadratique ou un point d'influence isolé peuvent produire un R² artificiellement élevé malgré une spécification erronée. Un diagnostic résiduel rigoureux exige de vérifier l'homoscédasticité (variance constante des erreurs pour toutes les valeurs ajustées ŷ) : si le nuage des résidus présente une forme en entonnoir ou si le test de Breusch-Pagan donne p < 0,05, l'erreur type Se et le test t sur la pente sont biaisés, imposant une transformation de puissance de Box-Cox ou les moindres carrés pondérés (WLS).

Distinguer l'intervalle de confiance moyen de la prédiction individuelle

Confondre intervalle de confiance et intervalle de prédiction constitue une erreur d'interprétation fréquente. L'erreur type de l'intervalle de confiance SE_conf = Se · √(1/n + (X₀ - x̄)² / SSxx) quantifie uniquement l'incertitude sur l'espérance conditionnelle moyenne de la population E[Y|X₀]. À l'inverse, prédire une observation individuelle future Y₀ impose d'intégrer la variance résiduelle irréductible du processus stochastique ε ~ N(0, σ²), donnant SE_pred = Se · √(1 + 1/n + (X₀ - x̄)² / SSxx). En raison du terme unitaire (+1) sous le radical, l'intervalle de prédiction est systématiquement plus large que l'intervalle de confiance pour une même valeur X₀.

Exécution sandboxée zéro confiance garantissant la conformité RGPD

Les séries temporelles financières, indicateurs biomédicaux et données de référence soumis à ce moteur sont traités exclusivement dans le bac à sable isolé du moteur JavaScript V8 de votre navigateur, sans aucun transit réseau. Les calculs s'appuient sur l'API Web Crypto pour le contrôle d'intégrité par hachage SHA-256 déterministe, sans requêtes serveur. Cette architecture zéro confiance côté client assure une conformité intégrale avec les exigences du RGPD (règlement général sur la protection des données) et du standard HIPAA, tout en maintenant des temps d'exécution sous la milliseconde.

Pièges courants et dépannage

⚠️Exception de matrice singulière et division par zéro (pente égale à NaN ou indéfinie)

Cette erreur se produit lorsque toutes les coordonnées explicatives X saisies sont identiques (par exemple X = [12, 12, 12, 12]), ce qui annule la somme des carrés au dénominateur SSxx = Σ(xᵢ - x̄)² = 0,0. Selon la méthode des moindres carrés ordinaires, la pente m = SSxy / SSxx correspond alors à une droite verticale indéterminée de pente infinie. Assurez-vous que la série explicative contienne au minimum deux valeurs distinctes de telle sorte que la variance Var(X) > 1e-15.

⚠️L'intervalle de prédiction s'effondre ou affiche la même largeur que l'intervalle de confiance

Ce défaut survient lorsque la formule statistique omet la composante de variance irréductible (le terme 1,0) sous le radical dans l'erreur type de prédiction. Vérifiez que le calcul applique bien SE_pred = Se · √(1 + 1/n + (X₀ - x̄)² / SSxx) et non la formule de la réponse moyenne SE_conf. Au niveau du centroïde X₀ = x̄, SE_pred doit être égal à Se · √(1 + 1/n), ce qui est strictement supérieur à Se · √(1/n).

⚠️Distorsion sévère de la pente et R² surévalué sous l'effet de points aberrants à fort levier

Puisque la méthode des moindres carrés ordinaires minimise la somme des erreurs quadratiques euclidiennes Σeᵢ², les observations atypiques éloignées jouent le rôle de points d'appui à fort bras de levier (diagonale de matrice chapeau h_ii > 2p/n) qui attirent artificiellement la droite de régression. Examinez la distance de Cook : dès que Di > 4/n ou que le résidu studentisé |rᵢ| > 3,0, isolez ou désactivez temporairement l'observation discordante afin d'évaluer des coefficients de régression tronqués plus robustes.

Foire aux questions (FAQ)

Comment calculer une régression linéaire simple à la main ?▼

Pour calculer manuellement une régression linéaire simple : 1) Calculez les moyennes d'échantillon x̄ = Σx / n et ȳ = Σy / n. 2) Calculez la somme des carrés SSxx = Σx² - (Σx)² / n et la somme des produits croisés SSxy = Σxy - (Σx)(Σy) / n. 3) Déterminez la pente m = SSxy / SSxx. 4) Calculez l'ordonnée à l'origine b = ȳ - m(x̄). 5) Établissez l'équation de prédiction ŷ = mx + b. Ce calculateur prend en charge l'ensemble de ces étapes intermédiaires avec une haute précision numérique.

Quelle est la différence entre le coefficient de corrélation r et le R² ?▼

Le coefficient r de Pearson évalue la force et le sens de la relation linéaire entre deux variables, sur une échelle de -1 (corrélation linéaire négative parfaite) à +1 (corrélation positive parfaite). Le coefficient de détermination R² correspond au carré de r (R² = r²) et est compris entre 0 et 1 (soit 0 % à 100 %). Il exprime la part de variance de la variable dépendante (Y) expliquée par le modèle de régression à partir de la variable indépendante (X).

Que représentent la pente et l'ordonnée à l'origine en régression linéaire ?▼

La pente (notée m ou β₁) représente la variation moyenne attendue de Y pour chaque augmentation d'une unité de X. Par exemple, une pente de 2,5 indique que Y augmente en moyenne de 2,5 unités lorsque X augmente de 1. L'ordonnée à l'origine (notée b ou β₀) correspond à la valeur théorique de Y lorsque X vaut zéro. Si elle est indispensable pour ancrer mathématiquement la droite, elle n'a de signification concrète que si la valeur X = 0 est physiquement ou économiquement plausible dans le domaine d'observation.

Quelle est la différence entre intervalle de confiance et intervalle de prédiction ?▼

L'intervalle de confiance estime l'incertitude entourant l'espérance moyenne de la population pour une valeur X donnée. L'intervalle de prédiction estime quant à lui la plage dans laquelle se situera une observation individuelle future isolée. Puisqu'une mesure individuelle cumule à la fois l'incertitude sur les coefficients du modèle et l'aléa résiduel irréductible (erreur ε), l'intervalle de prédiction est systématiquement plus large que l'intervalle de confiance pour une même valeur X.

Comment les valeurs aberrantes affectent-elles la droite des moindres carrés ?▼

La méthode des moindres carrés ordinaires (MCO) minimisant la somme des résidus au carré, elle surpénalise les écarts importants. Une valeur aberrante présentant un fort effet de levier (valeur X extrême) peut basculer la droite de régression et fausser radicalement la pente comme le R². Ce calculateur isole ces points critiques grâce à la distance de Cook et aux résidus standardisés, vous permettant de tester la robustesse du modèle en les désactivant d'un simple clic.

Dans quels cas ne faut-il pas utiliser un modèle de régression linéaire ?▼

La régression linéaire simple doit être évitée lorsque : 1) La relation sous-jacente est non linéaire (courbe exponentielle, parabolique ou palier de saturation). 2) Les résidus présentent une hétéroscédasticité (dispersion en entonnoir à mesure que X augmente). 3) Les observations sont autocorrélées dans le temps au lieu d'être indépendantes. 4) Des effets de regroupement ou grappes structurelles existent dans l'échantillon. Il convient alors d'opter pour une régression polynomiale, des transformations logarithmiques ou des modèles non linéaires.

Outils et utilitaires connexes

Tous les outils →