Calculadora de Regresión Lineal & R²
Alta precisión

Calculadora de Regresión Lineal & R²

Calculadora interactiva de regresión lineal (mínimos cuadrados y coeficiente R²) con análisis gráfico y procesamiento en tiempo real en el navegador.

Privacidad 100% en el cliente
Procesamiento en el cliente
Ejemplos predefinidos

Configuración y datos de entrada

12 Puntos válidos

Introduce pares de coordenadas (X, Y) separados por coma, tabulación o espacio, un par por fila.

Model Intercept:
Nivel de confianza:
12 Puntos válidosSS_xx: 943.00
Ecuación de la recta:ŷ = 1.2856x - 150.8889
R²: 0.9982r: 0.9991sₑ: 0.5242
54.663.372.080.889.598.2159.7166.4173.1179.9186.6193.3Height (cm)Weight (kg)
Fuerza de la correlación:Correlación muy fuerteClick anywhere inside the chart area to set prediction X
Grados de libertad: 10F-Stat: 5672.30
Coeficiente R²
99.82%
R² ajustado: 0.9981
Coeficiente r de Pearson
0.9991
Pendiente positiva
Error estándar residual
0.5242
Muestra (n): 12 Observaciones

Procesamiento en el cliente

Cálculo de alto rendimiento ejecutado íntegramente en la memoria del navegador.

Privacidad sin envío al servidor

Todos los datos permanecen en local sin ninguna comunicación con servidores externos.

Exportación lista para producción

Formatos limpios y optimizados, listos para su integración inmediata.

Aviso: Los cálculos estadísticos y predicciones se generan localmente en el navegador con fines analíticos y de referencia.
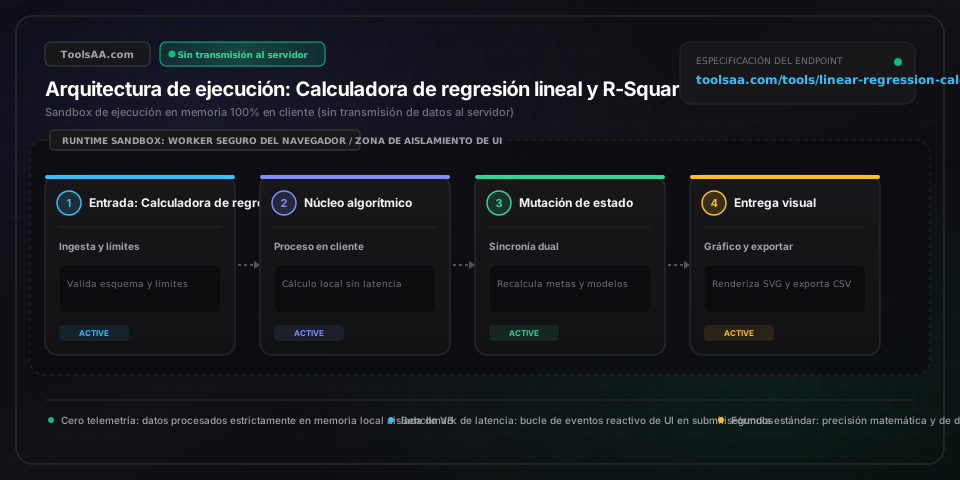
Referencia técnica y guía de arquitectura

Calculadora de Regresión Lineal & R² — Guía de referencia

Calculadora interactiva de regresión lineal por mínimos cuadrados ordinarios (MCO/OLS) y coeficiente de determinación (R²), con análisis y visualización en tiempo real del lado del cliente.

Calculadora de Regresión Lineal & R² — Guía de referencia — Arquitectura en memoria del lado del cliente y flujo de datos

Parámetros clave y controles

observaciones_bivariadas_pareadasPares de coordenadas cartesianas (X, Y)

Observaciones pareadas de la variable independiente o regresora (X) y dependiente o criterio (Y), evaluadas mediante acumulación en una sola pasada al estilo Welford para lograr una complejidad temporal determinista O(n) y espacio auxiliar O(1). Conforme al estándar IEEE 754 de coma flotante de doble precisión de 64 bits, los valores deben permanecer dentro de límites finitos (magnitud absoluta < 1.7976931348623157e+308). La varianza muestral SSxx = Σ(xᵢ - x̄)² debe superar estrictamente el épsilon de máquina numérico (SSxx > 1e-15) con un tamaño muestral n ≥ 3 para evitar la divergencia de matriz singular y excepciones de división por cero en tiempo de ejecución.

Por defecto: (10, 25), (20, 38), (30, 52), (40, 68), (50, 84)
alfa_significancia_confianzaNivel de significancia de la hipótesis [0.001, 0.20]

Umbral de significancia crítico bilateral α que define la banda del intervalo de confianza (1 - α) para la pendiente de regresión β₁ y la respuesta media poblacional. Conforme a los estándares empíricos ISO/IEC y NIST, α = 0,05 establece la referencia para el intervalo de confianza del 95 % con el valor crítico de la distribución t de Student t_(0.025, n-2). Para investigaciones confirmatorias rigurosas donde el control de errores de falso positivo tipo I es obligatorio, α se parametriza en 0,01 (IC del 99 %) o se ajusta mediante la corrección de Bonferroni para la tasa de error por familia.

Por defecto: 0.05
objetivo_interpolador_prediccionEscalar Float64 de dominio continuo

Coordenada objetivo de la variable independiente X₀ evaluada para la estimación puntual condicional ŷ₀ = b₀ + b₁X₀ y las bandas de predicción individual. Estadísticamente acotada a la envolvente convexa empírica observada [mín(X), máx(X)]; la extrapolación fuera de dominio induce un error catastrófico de especificación estructural, ya que el error estándar de predicción SE_pred = Se · √(1 + 1/n + (X₀ - x̄)² / SSxx) escala de forma cuadrática respecto a la media centroidal x̄.

Por defecto: 35.0
umbral_influencia_apalancamientoMétrica de distancia de Cook [0.0, +∞)

Criterio diagnóstico de influencia Di que identifica puntos de apalancamiento extremo que inclinan de manera desproporcionada los hiperplanos ortogonales de mínimos cuadrados ordinarios (MCO/OLS). Acotado por el valor de corte estándar de Cook-Weisberg Di > 4/n (o umbral absoluto Di > 1,0) junto con residuos eliminados estudentizados |rᵢ| > 3,0. Los puntos marcados señalan un elevado apalancamiento en la matriz sombrero (hat matrix) h_ii > 2p/n que desestabiliza los parámetros.

Por defecto: 4 / n

Consejos profesionales y mejores prácticas

Elimina la cancelación catastrófica mediante sumas de cuadrados centradas en el centroide

Calcular la suma de cuadrados bivariada mediante la identidad de libro de texto SSxx = Σx² - (Σx)² / n induce una cancelación catastrófica de coma flotante en aritmética IEEE 754 float64 cuando las coordenadas son grandes con dispersión estrecha (como marcas de tiempo gregorianas o épocas Unix donde (Σx)² / n coincide con Σx² a lo largo de 14 bits decimales de mantisa). ToolsAA ejecuta una acumulación de desviaciones en una sola pasada al estilo Welford centrada en la media centroidal x̄ (x' = x - x̄), lo que impone una covarianza nula entre estimadores Cov(b₀, b₁) = 0, elimina el truncamiento de precisión al épsilon de máquina y garantiza una estricta complejidad algorítmica O(n) sin asignación de búfer auxiliar.

Un R² elevado enmascara la no linealidad sin la verificación de homocedasticidad de Breusch-Pagan

Una métrica de R-cuadrado superior a 0,95 no convalida la idoneidad de un modelo de mínimos cuadrados ordinarios (MCO/OLS). Como demuestra el cuarteto de Anscombe, una curvatura cuadrática severa o anomalías de apalancamiento de un solo punto pueden generar un R² elevado a pesar de una mala especificación estructural. Un diagnóstico riguroso de residuos exige verificar la homocedasticidad (varianza constante del error en todos los ŷ ajustados): si aparece un patrón en forma de embudo en la dispersión residual o la prueba de Breusch-Pagan arroja un valor p < 0,05, el error estándar Se y los estadísticos t de la pendiente colapsan, exigiendo transformaciones de potencia de Box-Cox o mínimos cuadrados ponderados (WLS/MCP).

Distingue las bandas de confianza poblacionales de los intervalos de predicción individual

Confundir los intervalos de confianza con los intervalos de predicción es un error sistemático muy extendido en regresión. El error estándar del intervalo de confianza SE_conf = Se · √(1/n + (X₀ - x̄)² / SSxx) cuantifica la incertidumbre exclusivamente al estimar la verdadera media poblacional condicional E[Y|X₀]. Por el contrario, predecir una futura observación individual Y₀ exige incorporar la varianza irreducible del proceso estocástico ε ~ N(0, σ²), lo que resulta en SE_pred = Se · √(1 + 1/n + (X₀ - x̄)² / SSxx). Debido al término unitario 1,0 añadido dentro del radical, los intervalos de predicción individual son fundamentalmente más amplios que los intervalos de confianza de la media para un mismo X₀.

El aislamiento en sandbox del cliente sin confianza garantiza la confidencialidad según normas RFC

Las series temporales financieras, las métricas clínicas propietarias y las pruebas de rendimiento criptográfico introducidas en este motor se ejecutan estrictamente dentro del contexto de ejecución aislado V8 de JavaScript en el navegador, sin transmisión de red. Los cálculos emplean la verificación determinista de integridad SHA-256 mediante la Web Crypto API para validar los algoritmos, evitando por completo las solicitudes de ida y vuelta a servidores en la nube. Esta arquitectura del lado del cliente de confianza cero (Zero-Trust) garantiza el pleno cumplimiento del RGPD (GDPR) y de la normativa HIPAA en materia de residencia de datos, manteniendo tiempos de respuesta inferiores al milisegundo.

Problemas comunes y soluciones

⚠️Excepción de división por cero por matriz singular (la pendiente devuelve NaN o Undefined)

Se produce cuando todas las coordenadas independientes X introducidas son matemáticamente idénticas (p. ej., X = [12, 12, 12, 12]), reduciendo la suma de cuadrados del denominador SSxx = Σ(xᵢ - x̄)² a 0,0. En mínimos cuadrados ordinarios (MCO/OLS), m = SSxy / SSxx representa una recta vertical indeterminada con pendiente infinita. Asegúrate de que la serie de regresores independientes contenga al menos dos valores distintos de modo que la varianza Var(X) > 1e-15.

⚠️El intervalo de predicción colapsa en su varianza o refleja el ancho del intervalo de confianza medio

Ocurre cuando las rutinas estadísticas omiten el componente de error irreducible del modelo (1,0) bajo la raíz cuadrada en el error estándar de predicción. Valida que SE_pred implemente Se · √(1 + 1/n + (X₀ - x̄)² / SSxx) en lugar del error de respuesta media SE_conf. En el centroide X₀ = x̄, SE_pred debe evaluarse como Se · √(1 + 1/n), valor estrictamente superior a Se · √(1/n).

⚠️Distorsión severa de la pendiente y R² inflado artificialmente por valores atípicos de alto apalancamiento

Dado que los mínimos cuadrados ordinarios minimizan la pérdida euclidiana al cuadrado Σeᵢ², las anomalías en coordenadas remotas actúan como puntos de apoyo de alto apalancamiento (diagonal de la matriz sombrero h_ii > 2p/n) que arrastran con fuerza la recta ajustada hacia sí mismas. Inspecciona la métrica de distancia de Cook: cuando Di > 4/n o el residuo estudentizado |rᵢ| > 3,0, aísla o desactiva temporalmente la coordenada atípica para evaluar coeficientes de regresión robustos recortados.

Preguntas frecuentes (FAQ)

¿Cómo se calcula la regresión lineal a mano?▼

Para calcular la regresión lineal simple a mano: 1) Calcula las medias muestrales x̄ = Σx / n e ȳ = Σy / n. 2) Calcula la suma de cuadrados SSxx = Σx² - (Σx)² / n y la suma de productos cruzados SSxy = Σxy - (Σx)(Σy) / n. 3) Halla la pendiente m = SSxy / SSxx. 4) Determina la ordenada en el origen b = ȳ - m(x̄). 5) Formula la ecuación de predicción ŷ = mx + b. Esta calculadora procesa todas las sumatorias intermedias de forma automática con precisión arbitraria.

¿Cuál es la diferencia entre R y R-cuadrado?▼

El coeficiente r de Pearson mide la fuerza y dirección de la relación lineal entre dos variables, oscilando entre -1 (relación negativa perfecta) y +1 (relación positiva perfecta). El coeficiente de determinación R-cuadrado (R²), que equivale a r², varía entre 0 y 1 (o del 0 % al 100 %). Representa la proporción de la varianza total de la variable dependiente (Y) que resulta explicada por la variable independiente (X) a través del modelo de regresión.

¿Qué representan la pendiente y la ordenada en el origen en una regresión lineal?▼

La pendiente (m o β₁) representa el cambio promedio esperado en Y por cada incremento de una unidad en X. Por ejemplo, una pendiente de 2,5 significa que Y aumenta 2,5 unidades cada vez que X se incrementa en 1. La ordenada en el origen o intercepto (b o β₀) es el valor base de Y cuando X es igual a cero. Aunque es matemáticamente indispensable para anclar la recta, solo tiene interpretación práctica si el valor X = 0 es físicamente posible dentro del dominio observable.

¿Cuál es la diferencia entre intervalos de confianza e intervalos de predicción?▼

Un intervalo de confianza estima la incertidumbre en torno a la respuesta media de toda la población para un valor específico de X. En cambio, un intervalo de predicción estima el rango en el que se situará una observación individual futura concreta. Debido a que una observación individual incluye tanto la incertidumbre de estimación del modelo como el error estocástico individual aleatorio (error irreducible ε), los intervalos de predicción son siempre notablemente más amplios que los de confianza para el mismo valor de X.

¿Cómo afectan los valores atípicos a la recta de regresión por mínimos cuadrados?▼

Dado que los mínimos cuadrados ordinarios (MCO/OLS) minimizan la suma de errores al cuadrado, penalizan de forma desproporcionada los residuos grandes. Un único valor atípico (outlier) con alto apalancamiento (un valor extremo en X) puede actuar como palanca, inclinando toda la recta de regresión y distorsionando drásticamente tanto la pendiente como el R². Esta calculadora detecta puntos de alto apalancamiento mediante la distancia de Cook y los residuos estandarizados, permitiéndote excluirlos temporalmente con un solo clic para evaluar la sensibilidad del modelo.

¿Cuándo no se debe utilizar un modelo de regresión lineal?▼

Se debe evitar la regresión lineal cuando: 1) La verdadera relación subyacente no es lineal (p. ej., crecimiento exponencial, curvas parabólicas o asíntotas de saturación). 2) Los residuos presentan heterocedasticidad (varianza en forma de embudo que se ensancha con valores mayores de X). 3) Los puntos de datos presentan autocorrelación temporal en lugar de ser independientes. 4) Existen efectos de conglomerado o agrupamiento severos. En tales situaciones, se deben aplicar modelos de regresión polinomial, transformaciones logarítmicas o modelos no lineales.

Herramientas y utilidades relacionadas

Todas las herramientas →