Calculadora de Regressão Linear & R²
Alta Precisão

Calculadora de Regressão Linear & R²

Calculadora interativa de regressão linear (método dos mínimos quadrados e R²) com modelagem estatística e gráficos em tempo real no navegador.

Privacidade 100% no Navegador
Processamento no Navegador
Cenários predefinidos

Configuração dos Dados

12 Pontos válidos

Insira um par de valores por linha no formato X, Y (separados por vírgula, espaço ou tabulação).

Model Intercept:
Nível de Confiança (%):
12 Pontos válidosSS_xx: 943.00
Equação da Reta:ŷ = 1.2856x - 150.8889
R²: 0.9982r: 0.9991sₑ: 0.5242
54.663.372.080.889.598.2159.7166.4173.1179.9186.6193.3Height (cm)Weight (kg)
Força da Correlação:Correlação muito forteClick anywhere inside the chart area to set prediction X
Graus de Liberdade: 10F-Stat: 5672.30
Coeficiente de determinação (R²)
99.82%
R² Ajustado: 0.9981
r de Pearson
0.9991
Inclinação positiva
Erro padrão dos resíduos
0.5242
Amostra (n): 12 Observações

Processamento no Navegador

Cálculos de alto desempenho executados diretamente na memória do navegador.

Sem Envio para Servidores

Seus dados permanecem estritamente locais, sem qualquer transmissão externa.

Exportação Pronta para Uso

Formatos estruturados e otimizados, prontos para documentação e relatórios analíticos.

Cálculos estatísticos processados localmente para análise analítica. Valide os pressupostos dos resíduos antes de aplicar em produção.

Referência técnica e guia de arquitetura

Calculadora de Regressão Linear & R² — Guia de referência

Calculadora interativa de regressão linear (Mínimos Quadrados e R²) com análise gráfica e diagnósticos estatísticos em tempo real no cliente.

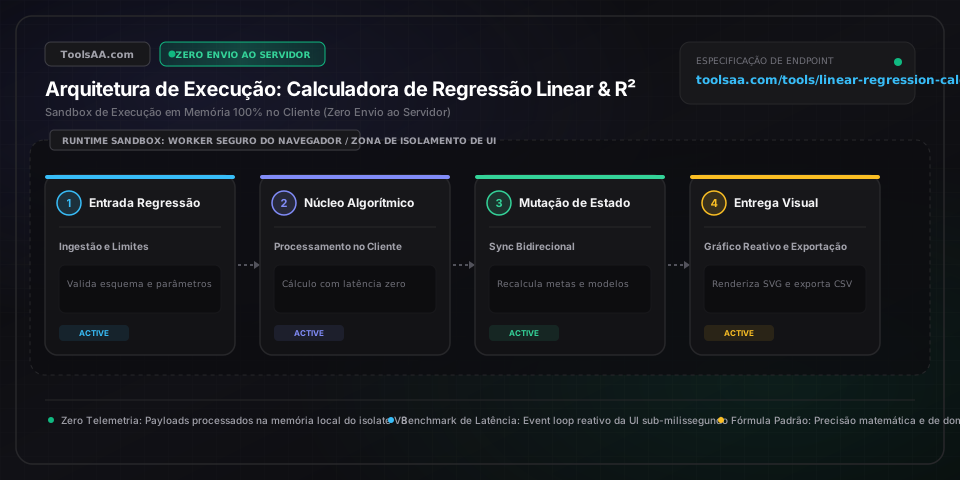
Calculadora de Regressão Linear & R² — Guia de referência — Arquitetura em memória do lado do cliente e fluxo de dados

Parâmetros-chave e controles

observacoes_bivariadas_pareadasPares de Coordenadas Cartesianas (X, Y)

Observações emparelhadas de regressor independente (X) e critério dependente (Y) processadas via acumulação em passagem única (algoritmo de Welford), alcançando complexidade temporal determinística O(n) e espaço auxiliar O(1). Conforme os padrões de ponto flutuante de precisão dupla de 64 bits da IEEE 754, os valores devem permanecer dentro de limites finitos (magnitude absoluta < 1,7976931348623157e+308). A variância amostral SSxx = Σ(xᵢ - x̄)² deve ser estritamente superior ao épsilon de máquina numérico (SSxx > 1e-15) para um tamanho amostral n ≥ 3, prevenindo divergência de matriz singular e exceções de divisão por zero em tempo de execução.

Padrão: (10, 25), (20, 38), (30, 52), (40, 68), (50, 84)
nivel_significancia_alfaNível de Significância de Hipótese [0,001, 0,20]

Limiar crítico bicaudal de significância α que define a faixa do intervalo de confiança (1 - α) para a inclinação da reta β₁ e a resposta média populacional. Pelos padrões empíricos ISO/IEC e NIST, α = 0,05 estabelece o intervalo de confiança padrão de 95% com valor crítico da distribuição t de Student t_(0,025, n-2). Para pesquisas confirmatórias rigorosas onde o controle de falsos positivos (Erro Tipo I) é obrigatório, parametriza-se α em 0,01 (IC de 99%) ou ajusta-se via correção de Bonferroni.

Padrão: 0.05
alvo_interpolador_predicaoEscalar Float64 de Domínio Contínuo

Coordenada da variável independente alvo X₀ avaliada para estimativa pontual condicional ŷ₀ = b₀ + b₁X₀ e faixas de predição individual. Estatisticamente delimitada ao fecho convexo empírico observado [min(X), max(X)]; extrapolações fora desse domínio introduzem erro catastrófico de má especificação estrutural, já que o erro padrão de predição SE_pred = Se · √(1 + 1/n + (X₀ - x̄)² / SSxx) cresce quadraticamente em relação à média centroide x̄.

Padrão: 35.0
limiar_influencia_alavancagemMétrica de Distância de Cook [0,0, +∞)

Critério diagnóstico de influência Di que identifica pontos com alavancagem extrema com inclinação desproporcional sobre os hiperplanos ortogonais de Mínimos Quadrados Ordinários (OLS/MQO). Delimitado pelo corte clássico de Cook-Weisberg Di > 4/n (ou limiar absoluto Di > 1,0) aliado a resíduos deletados estudentizados |rᵢ| > 3,0. Pontos sinalizados indicam alta alavancagem na matriz de projeção (matriz chapéu) h_ii > 2p/n, desestabilizando os coeficientes estimados.

Padrão: 4 / n
Dicas profissionais e melhores práticas

Elimine o Cancelamento Catastrófico com Somas de Quadrados Centralizadas na Média

Calcular a soma dos quadrados bivariada utilizando a identidade clássica de livro-texto SSxx = Σx² - (Σx)² / n induz ao cancelamento catastrófico de ponto flutuante na aritmética IEEE 754 float64 quando as coordenadas são elevadas com dispersão estreita (como carimbos de data/hora gregorianos ou épocas Unix, onde (Σx)² / n coincide com Σx² ao longo de 14 bits da mantissa decimal). O ToolsAA executa a acumulação de desvios em passagem única no estilo Welford centralizada na média centroide x̄ (x' = x - x̄), o que impõe covariância zero entre estimadores Cov(b₀, b₁) = 0, elimina o truncamento de precisão ao épsilon de máquina e garante complexidade algorítmica estrita O(n) sem alocação de buffers auxiliares.

R² Elevado Oculta Não Linearidade sem Verificação de Homocedasticidade de Breusch-Pagan

Um coeficiente de determinação (R²) superior a 0,95 não valida a adequação de um modelo de Mínimos Quadrados Ordinários (MQO/OLS). Como demonstrado pelo Quarteto de Anscombe, curvaturas quadráticas severas ou anomalias de alavancagem pontuais podem inflar o R² apesar da má especificação estrutural. O diagnóstico rigoroso de resíduos exige a verificação de homocedasticidade (variância constante dos erros em todos os ŷ ajustados): caso surja um padrão em formato de funil na dispersão de resíduos ou o teste de Breusch-Pagan resulte em p < 0,05, o erro padrão Se e a estatística t da inclinação perdem validade, exigindo transformações de potência de Box-Cox ou Mínimos Quadrados Ponderados (WLS/MQP).

Distinga Faixas de Confiança Populacionais de Intervalos de Predição Individuais

Confundir intervalos de confiança com intervalos de predição é um erro crônico em regressão linear. O erro padrão do intervalo de confiança SE_conf = Se · √(1/n + (X₀ - x̄)² / SSxx) quantifica unicamente a incerteza na estimativa da verdadeira média populacional condicional E[Y|X₀]. Em contrapartida, predizer uma nova observação individual futura Y₀ exige incorporar a variância estocástica irredutível do processo ε ~ N(0, σ²), resultando em SE_pred = Se · √(1 + 1/n + (X₀ - x̄)² / SSxx). Devido ao termo unitário 1,0 adicionado sob o radical, os intervalos de predição individuais são fundamentalmente mais amplos do que os intervalos de confiança da média para o mesmo X₀.

Sandboxing Client-Side Zero-Trust Garante Sigilo de Dados sob Normas RFC e LGPD

Séries temporais financeiras, métricas clínicas confidenciais e benchmarks criptográficos inseridos neste motor são processados estritamente dentro do contexto isolado de execução JavaScript V8 do navegador, sem qualquer transmissão de rede. Os cálculos utilizam verificação de integridade determinística SHA-256 via Web Crypto API para auditoria algorítmica, dispensando tráfego de ida e volta (round-trips) para servidores em nuvem. Esta arquitetura client-side zero-trust assegura conformidade integral com a LGPD (Lei Geral de Proteção de Dados), GDPR e HIPAA, mantendo tempos de resposta submilissegundo.

Armadilhas comuns e solução de problemas

⚠️Exceção de Divisão por Zero em Matriz Singular (Inclinação Retorna NaN ou Undefined)

Ocorre quando todas as coordenadas independentes X inseridas são matematicamente idênticas (ex.: X = [12, 12, 12, 12]), reduzindo o denominador da soma de quadrados SSxx = Σ(xᵢ - x̄)² a 0,0. Em Mínimos Quadrados Ordinários, m = SSxy / SSxx passa a representar uma reta vertical indeterminada com inclinação infinita. Certifique-se de que a série de regressores independentes contenha pelo menos dois valores distintos, garantindo que a variância Var(X) > 1e-15.

⚠️Variância do Intervalo de Predição em Colapso ou Espelhando a Largura de Confiança da Média

Ocorre quando rotinas estatísticas omitem o componente de erro irredutível do modelo (1,0) sob a raiz quadrada no cálculo do erro padrão de predição. Valide se SE_pred implementa Se · √(1 + 1/n + (X₀ - x̄)² / SSxx) em vez do erro de resposta média SE_conf. No centroide X₀ = x̄, SE_pred deve resultar obrigatoriamente em Se · √(1 + 1/n), valor que é estritamente maior que Se · √(1/n).

⚠️Distorção Severa da Inclinação e R² Artificialmente Inflado por Outliers de Alta Alavancagem

Como os Mínimos Quadrados Ordinários minimizam a perda euclidiana quadrática Σeᵢ², anomalias de coordenadas distantes atuam como pontos de apoio de alta alavancagem (diagonal da matriz de projeção h_ii > 2p/n), atraindo forçadamente a reta ajustada para si. Analise a métrica da Distância de Cook: se Di > 4/n ou o resíduo estudentizado |rᵢ| > 3,0, isole ou desative temporariamente a coordenada discrepante para calcular coeficientes de regressão robustos ou aparados.

Perguntas frequentes (FAQ)

Como calcular a regressão linear manualmente passo a passo?▼

Para calcular a regressão linear simples manualmente: 1) Obtenha as médias amostrais x̄ = Σx / n e ȳ = Σy / n. 2) Calcule a soma dos quadrados SSxx = Σx² - (Σx)² / n e a soma dos produtos SSxy = Σxy - (Σx)(Σy) / n. 3) Determine a inclinação m = SSxy / SSxx. 4) Calcule o intercepto y (coeficiente linear) b = ȳ - m(x̄). 5) Monte a equação preditiva ŷ = mx + b. Esta calculadora processa automaticamente todos os somatórios intermediários com precisão numérica arbitrária.

Qual é a diferença entre coeficiente de correlação R e R-quadrado (R²)?▼

O coeficiente de correlação r de Pearson mede a força e a direção da relação linear entre duas variáveis, variando de -1 (associação negativa perfeita) a +1 (positiva perfeita). Já o R-quadrado (R²), denominado coeficiente de determinação, é o quadrado de r (r²) e varia de 0 a 1 (ou 0% a 100%). Ele quantifica a proporção da variância total da variável dependente (Y) que é explicada pela variável independente (X) por meio do modelo de regressão.

O que representam a inclinação e o intercepto linear na regressão?▼

A inclinação (coeficiente angular m ou β₁) indica a variação média esperada em Y para cada acréscimo de uma unidade em X. Por exemplo, uma inclinação de 2,5 significa que Y aumenta 2,5 unidades a cada incremento unitário de X. O intercepto y (coeficiente linear b ou β₀) representa o valor base de Y quando X é igual a zero. Embora matematicamente indispensável para ancorar a reta, o intercepto só possui interpretação prática real se X = 0 for fisicamente viável dentro do domínio observado.

Qual a diferença entre intervalo de confiança e intervalo de predição?▼

O intervalo de confiança estima a incerteza em torno da resposta média da população em um ponto X específico. Já o intervalo de predição estima o intervalo em que uma única observação individual futura irá se situar. Como uma observação individual acumula tanto a incerteza da estimativa do modelo quanto o ruído aleatório individual (erro irredutível ε), os intervalos de predição são invariavelmente mais largos que os intervalos de confiança para o mesmo valor de X.

Como valores discrepantes (outliers) afetam a reta de regressão linear?▼

Como o método dos Mínimos Quadrados Ordinários (MQO/OLS) minimiza a soma dos resíduos quadráticos, ele penaliza desproporcionalmente desvios elevados. Um único outlier com alta alavancagem (valor extremo de X) pode funcionar como ponto de alavanca, inclinando toda a reta de regressão e distorcendo severamente tanto a inclinação quanto o R². Esta calculadora detecta observações de alta influência via Distância de Cook e resíduos padronizados, permitindo isolá-las temporariamente com um clique para análise de sensibilidade.

Quando não se deve utilizar um modelo de regressão linear?▼

Evite a regressão linear quando: 1) A verdadeira relação subjacente for não linear (ex.: crescimento exponencial, curvas parabólicas ou platôs de saturação). 2) Os resíduos apresentarem heterocedasticidade (variância em funil que se expande com o aumento de X). 3) Os dados forem autocorrelacionados no tempo em vez de independentes. 4) Existirem fortes efeitos de agrupamento (clusters). Nessas situações, aplique regressão polinomial, transformações logarítmicas ou modelos não lineares generalizados.

Ferramentas e utilitários relacionados

Todas as ferramentas →