Lineare Regression & R² Rechner
Hohe Präzision

Lineare Regression & R² Rechner

Interaktiver Rechner für lineare Regression (Methode der kleinsten Quadrate & Bestimmtheitsmaß R²) mit clientseitiger Echtzeitanalyse und grafischer Visualisierung im Browser.

100 % lokaler Datenschutz
Clientseitige Verarbeitung
Beispieldaten

Eingabebereich

12 Gültige Datenpunkte

Wertepaare zeilenweise eingeben (z. B. X, Y getrennt durch Komma, Semikolon oder Tabulator).

Model Intercept:
Konfidenzniveau:
12 Gültige DatenpunkteSS_xx: 943.00
Regressionsgleichung:ŷ = 1.2856x - 150.8889
R²: 0.9982r: 0.9991sₑ: 0.5242
54.663.372.080.889.598.2159.7166.4173.1179.9186.6193.3Height (cm)Weight (kg)
Korrelationsstärke:Sehr starke KorrelationClick anywhere inside the chart area to set prediction X
Freiheitsgrade (df): 10F-Stat: 5672.30
Bestimmtheitsmaß R²
99.82%
Korrigiertes R²: 0.9981
Pearson-Korrelationskoeffizient r
0.9991
Positive Steigung
Standardfehler der Residuen
0.5242
Stichprobe n: 12 Beobachtungen

Clientseitige Verarbeitung

Hochperformante Berechnung, die vollständig im Arbeitsspeicher des Browsers ausgeführt wird.

Zero-Server-Datenschutz

Alle Nutzdaten verbleiben strikt lokal ohne jegliche externe Serverkommunikation.

Produktionsreifer Export

Saubere, optimierte Ausgabeformate – sofort einsatzbereit für Ihre Workflows.

Hinweis: Alle statistischen Berechnungen erfolgen lokal im Browser. Ergebnisse dienen analytischen Zwecken ohne Gewähr für absolute mathematische Fehlerfreiheit.
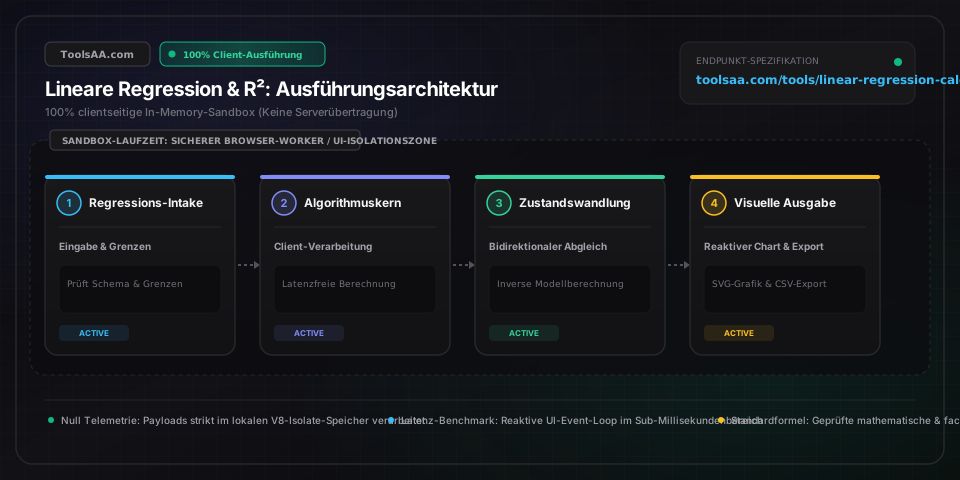
Technische Referenz & Architektur-Leitfaden

Lineare Regression & R² Rechner — Referenzhandbuch

Interaktiver Rechner für lineare Regression (Methode der kleinsten Quadrate & Bestimmtheitsmaß R²) mit clientseitiger Echtzeit-Analyse und grafischer Visualisierung.

Lineare Regression & R² Rechner — Referenzhandbuch — Client-seitige In-Memory-Architektur und Datenfluss

Wichtige Parameter & Einstellungen

gepaarte_bivariate_beobachtungenKartesische Koordinatenpaare (X, Y)

Gepaarte Beobachtungen aus unabhängigem Regressor (X) und abhängigem Kriterium (Y), ausgewertet über eine Welford-Akkumulation im Einzeldurchlauf mit deterministischer O(n)-Laufzeitkomplexität und O(1)-Speicherplatzbedarf. Gemäß IEEE-754-Standards für 64-Bit-Gleitkommazahlen mit doppelter Genauigkeit müssen die Werte innerhalb endlicher Grenzen liegen (Betrag < 1,7976931348623157e+308). Die Stichprobenvarianz SSxx = Σ(xᵢ - x̄)² muss bei einem Stichprobenumfang von n ≥ 3 das numerische Maschinengenauigkeits-Epsilon strikt überschreiten (SSxx > 1e-15), um singuläre Matrixdivergenzen und Laufzeitfehler durch Division durch null zu verhindern.

Standard: (10, 25), (20, 38), (30, 52), (40, 68), (50, 84)
konfidenz_signifikanzniveau_alphaHypothesen-Signifikanzniveau [0,001, 0,20]

Zweiseitiger kritischer Signifikanz-Schwellenwert α zur Festlegung des Konfidenzband-Intervalls (1 - α) für die Regressionssteigung β₁ und den mittleren Erwartungswert der Grundgesamtheit. Gemäß empirischen Standards nach ISO/IEC und DIN/NIST definiert α = 0,05 das 95-%-Konfidenzintervall mit dem kritischen Schwellenwert der Studentschen t-Verteilung t_(0,025; n-2). Für strenge konfirmatorische Analysen mit zwingender Kontrolle von Fehlern 1. Art (Alpha-Fehler) wird α auf 0,01 (99-%-KI) parametrisiert oder mittels familienweiser Bonferroni-Korrektur adjustiert.

Standard: 0,05
prognose_zielwert_x0Stetiger skalarer Float64-Wert

Zielkoordinate der unabhängigen Variablen X₀ zur bedingten Punktschätzung ŷ₀ = b₀ + b₁X₀ sowie für individuelle Prognosebänder. Statistisch auf die beobachtete empirische konvexe Hülle [min(X), max(X)] beschränkt; eine Extrapolation außerhalb des Wertebereichs birgt gravierende strukturelle Fehlspezifikationsfehler, da der Standardfehler der Prognose SE_pred = Se · √(1 + 1/n + (X₀ - x̄)² / SSxx) quadratisch mit der Distanz zum Mittelwertsschwerpunkt x̄ anwächst.

Standard: 35,0
hebelwert_einfluss_schwellenwertCook-Distanz-Metrik [0,0, +∞)

Einflussdiagnostisches Kriterium Dᵢ zur Identifikation extremer Hebelpunkte (Leverage Points), welche die orthogonalen Hyperebenen der Methode der kleinsten Quadrate (OLS) unverhältnismäßig verzerren. Begrenzt durch den gängigen Cook-Weisberg-Schwellenwert Dᵢ > 4/n (oder den absoluten Grenzwert Dᵢ > 1,0) in Kombination mit studentisierten eliminierten Residuen |rᵢ| > 3,0. Markierte Beobachtungen weisen auf eine hohe Hebelwirkung in der Hat-Matrix h_ii > 2p/n hin, welche die Parameterstabilität gefährdet.

Standard: 4 / n

Profi-Tipps & Best Practices

Katastrophale Auslöschung durch zentrierte Quadratsummen eliminieren

Die Berechnung der bivariaten Quadratsumme über die Lehrbuchformel SSxx = Σx² - (Σx)² / n verursacht bei IEEE-754-Float64-Berechnungen eine katastrophale Gleitkomma-Auslöschung (Catastrophic Cancellation), wenn Koordinaten bei geringer Streuung sehr groß sind (z. B. gregorianische Zeitstempel oder Unix-Epochen, bei denen (Σx)² / n mit Σx² über 14 Mantissenbits übereinstimmt). ToolsAA nutzt eine einstufige Welford-Abweichungsakkumulation, zentriert um den Mittelwert x̄ (x' = x - x̄). Dies erzwingt eine Schätzer-Kovarianz von null Cov(b₀, b₁) = 0, verhindert Präzisionsverluste bis hin zum Maschinen-Epsilon und gewährleistet eine strikte O(n)-Komplexität ohne zusätzlichen Pufferspeicher.

Hohes R² verschleiert Nichtlinearität ohne Breusch-Pagan-Homoskedastizitätstest

Ein Bestimmtheitsmaß R² über 0,95 belegt keineswegs die Güte eines OLS-Regressionsmodells. Wie Anscombes Quartett eindrucksvoll veranschaulicht, können ausgeprägte quadratische Krümmungen oder einzelne Hebelpunkte trotz struktureller Fehlspezifikation ein hohes R² vortäuschen. Eine fundierte Residuendiagnostik erfordert den Nachweis von Homoskedastizität (konstante Fehlervarianz über alle geschätzten Werte ŷ): Zeigt das Residuenstreudiagramm ein trichterförmiges Muster oder liefert der Breusch-Pagan-Test p < 0,05, verlieren der Standardfehler Se und die t-Statistik der Steigung ihre Gültigkeit. In solchen Fällen sind Box-Cox-Transformationen oder die gewichtete Methode der kleinsten Quadrate (WLS) zwingend erforderlich.

Konfidenzbänder der Grundgesamtheit von individuellen Prognoseintervallen unterscheiden

Die Verwechslung von Konfidenz- und Prognoseintervallen ist eine häufige Fehlerquelle in der Regressionsanalyse. Der Standardfehler des Konfidenzintervalls SE_conf = Se · √(1/n + (X₀ - x̄)² / SSxx) quantifiziert ausschließlich die Unsicherheit bei der Schätzung des wahren mittleren Erwartungswerts der Grundgesamtheit E[Y|X₀]. Für die Prognose eines künftigen Einzelfalls Y₀ muss hingegen die irreduzible stochastische Prozessvarianz ε ~ N(0, σ²) einbezogen werden: SE_pred = Se · √(1 + 1/n + (X₀ - x̄)² / SSxx). Wegen des zusätzlichen Summanden 1,0 unter der Wurzel sind individuelle Prognoseintervalle bei identischem X₀ grundsätzlich signifikant breiter als die Konfidenzintervalle des Mittelwerts.

Zero-Trust-Client-Sandboxing garantiert Datensouveränität nach DSGVO-Standards

Finanzzeitreihen, vertrauliche klinische Messdaten und kryptografische Benchmarks werden ausschließlich im isolierten JavaScript-V8-Kontext Ihres Browsers verarbeitet – ganz ohne Netzwerkübertragung. Berechnungen nutzen deterministische SHA-256-Prüfsummen der Web Crypto API zur Algorithmenvalidierung, ohne jemals externe Cloud-Server zu kontaktieren. Diese lokale Zero-Trust-Architektur gewährleistet vollständige Datenresidenz und uneingeschränkte Konformität mit der DSGVO (GDPR) sowie internationalen Datenschutzstandards bei Ausführungszeiten im Sub-Millisekundenbereich.

Häufige Fehlerquellen & Fehlerbehebung

⚠️Singuläre Matrix / Division durch null (Steigung gibt NaN oder undefiniert aus)

Tritt auf, wenn alle eingegebenen unabhängigen X-Koordinaten identisch sind (z. B. X = [12, 12, 12, 12]), wodurch die Nenner-Quadratsumme SSxx = Σ(xᵢ - x̄)² exakt 0,0 ergibt. Bei der Methode der kleinsten Quadrate stellt m = SSxy / SSxx dann eine unbestimmte vertikale Gerade mit unendlicher Steigung dar. Stellen Sie sicher, dass die Regressor-Reihe mindestens zwei voneinander verschiedene Werte enthält, sodass die Varianz Var(X) > 1e-15 beträgt.

⚠️Prognoseintervall kollabiert oder gleicht der Breite des Konfidenzintervalls

Wird verursacht, wenn Berechnungsroutinen die irreduzible Fehlervarianz (den Summanden 1,0) unter der Wurzel des Prognosestandardfehlers unterschlagen. Prüfen Sie, ob SE_pred über die Formel Se · √(1 + 1/n + (X₀ - x̄)² / SSxx) berechnet wird und nicht fälschlich dem mittleren Schätzfehler SE_conf entspricht. Im Mittelpunkt X₀ = x̄ muss SE_pred exakt Se · √(1 + 1/n) betragen, was strikt größer ist als Se · √(1/n).

⚠️Verzerrte Regressionssteigung und künstlich aufgeblähtes R² durch Hebel-Ausreißer

Da die Methode der kleinsten Quadrate (OLS) den quadrierten euklidischen Verlust Σeᵢ² minimiert, wirken weit abgelegene Datenpunkte als Hebelpunkte (Diagonalelement der Hat-Matrix h_ii > 2p/n), welche die Ausgleichsgerade massiv anziehen. Prüfen Sie die Cook-Distanz: Liegt Dᵢ > 4/n oder das studentisierte Residuum bei |rᵢ| > 3,0, sollten Sie den Ausreißer isolieren oder versuchsweise deaktivieren, um robuste getrimmte Regressionskoeffizienten zu ermitteln.

Häufig gestellte Fragen (FAQ)

Wie berechnet man eine lineare Regression von Hand?▼

So berechnen Sie eine einfache lineare Regression manuell: 1) Berechnen Sie die arithmetischen Mittelwerte x̄ = Σx / n und ȳ = Σy / n. 2) Bestimmen Sie die Quadratsumme SSxx = Σx² - (Σx)² / n sowie das Produktsummenmaß SSxy = Σxy - (Σx)(Σy) / n. 3) Ermitteln Sie die Steigung m = SSxy / SSxx. 4) Berechnen Sie den Y-Achsenabschnitt b = ȳ - m(x̄). 5) Stellen Sie die Regressionsgleichung ŷ = mx + b auf. Dieser Rechner führt alle Zwischensummen vollautomatisch mit höchster numerischer Präzision aus.

Was ist der Unterschied zwischen Korrelationskoeffizient r und Bestimmtheitsmaß R²?▼

Der Pearson-Korrelationskoeffizient r misst die Stärke und Richtung des linearen Zusammenhangs zweier Variablen im Bereich von -1 (vollständig negativ) bis +1 (vollständig positiv). Das Bestimmtheitsmaß R² (R-Squared) entspricht r² und liegt zwischen 0 und 1 (bzw. 0 % bis 100 %). Es gibt an, welcher prozentuale Anteil der Gesamtvarianz der abhängigen Variablen (Y) durch die unabhängige Variable (X) im Regressionsmodell erklärt wird.

Was bedeuten Steigung und Y-Achsenabschnitt bei einer linearen Regression?▼

Die Steigung (m oder β₁) beziffert die durchschnittliche Änderung von Y, wenn X um eine Einheit steigt. Eine Steigung von 2,5 bedeutet beispielsweise, dass Y im Schnitt um 2,5 Einheiten zunimmt, sobald X um 1 wächst. Der Y-Achsenabschnitt (b oder β₀) markiert den Ausgangswert von Y bei X = 0. Er dient mathematisch als Ankerpunkt der Geraden, ist jedoch in der Praxis nur dann fachlich interpretierbar, wenn X = 0 im empirischen Beobachtungsbereich sinnvoll existieren kann.

Was unterscheidet Konfidenzintervalle von Prognoseintervallen?▼

Ein Konfidenzintervall schätzt die statistische Unsicherheit bezüglich des mittleren Erwartungswerts der gesamten Grundgesamtheit an einer bestimmten Stelle X. Ein Prognoseintervall hingegen bestimmt den Bereich, in dem ein einzelner künftiger Messwert liegen wird. Da eine Einzelbeobachtung neben der Modellunsicherheit auch den rein zufälligen Fehler (irreduzible Streuung ε) enthält, sind Prognoseintervalle für denselben X-Wert stets deutlich breiter als Konfidenzintervalle.

Wie wirken sich Ausreißer auf die Regressionsgerade der kleinsten Quadrate aus?▼

Weil die Methode der kleinsten Quadrate (OLS) die Summe der quadrierten Fehler minimiert, werden große Residuen überproportional stark gewichtet. Ein einzelner Ausreißer mit hoher Hebelwirkung (extremer X-Wert) kann wie eine Brechstange wirken, die Regressionsgerade kippen und sowohl die Steigung als auch das Bestimmtheitsmaß R² drastisch verfälschen. Unser Rechner identifiziert Hebelpunkte anhand der Cook-Distanz und standardisierter Residuen, sodass Sie diese mit einem Klick vorübergehend ausschließen können.

Wann sollte man kein lineares Regressionsmodell anwenden?▼

Verzichten Sie auf lineare Regression, wenn: 1) Der reale Zusammenhang nichtlinear verläuft (z. B. exponentielles Wachstum, Parabelkurven oder Sättigungsgrenzen). 2) Die Residuen Heteroskedastizität aufweisen (trichterförmige Streuung bei wachsendem X). 3) Zeitreihendaten autokorreliert statt voneinander unabhängig sind. 4) Ausgeprägte Cluster- oder Klumpeneffekte vorliegen. In solchen Szenarien sind polynomielle Regressionen, logarithmische Transformationen oder nichtlineare Modelle vorzuziehen.

Verwandte Tools & Hilfsprogramme

Alle Tools →