Text-Deduplizierer
Tier M • Dual-Workbench

Doppelte Zeilen Löschen & Deduplizierer

Text-Deduplizierer zum schnellen Entfernen doppelter Zeilen aus Listen. Leerzeichen bereinigen, Groß-/Kleinschreibung ignorieren, Unikate isolieren und saubere Daten direkt im Browser exportieren.

100% Client-seitig & Sicher
Keine Server-Übertragung
Vorlagen
Roheingabe-Stream0 Zeilen
Deduplizierungs-Strategie
Trennzeichen & Ingestion
Eingabestrom44.4% Bereinigungsrate
EingabestromNFCNormalisierungO(N)O(N) Hash-AbgleichFLTRStrategie-FilterBereinigte Ausgabe
0 Zeilen•218 Zeichen•Umbruchformat: CRLF
Local Sandbox Only
Ausgabe-Verbindungstrennzeichen
0 Zeilen•-0 Entfernte Duplikate•44.4% Bereinigungsrate
Gesparter Speicher: 0 Bytes
Ursprüngliche Zeilen0
Einzigartige Einträge0 (55.6%)
Entfernte Duplikate0 (44.4%)

Client-seitige Verarbeitung

Hochperformante Verarbeitung wird vollständig und lokal im Arbeitsspeicher des Browsers ausgeführt.

100% Datenschutz ohne Server-Upload

Alle Nutzdaten verbleiben strikt lokal auf Ihrem Endgerät – keinerlei externe Server-Kommunikation.

Produktionsbereiter Export

Saubere, optimierte Datenformate – sofort einsatzbereit für Produktion und Workflows.
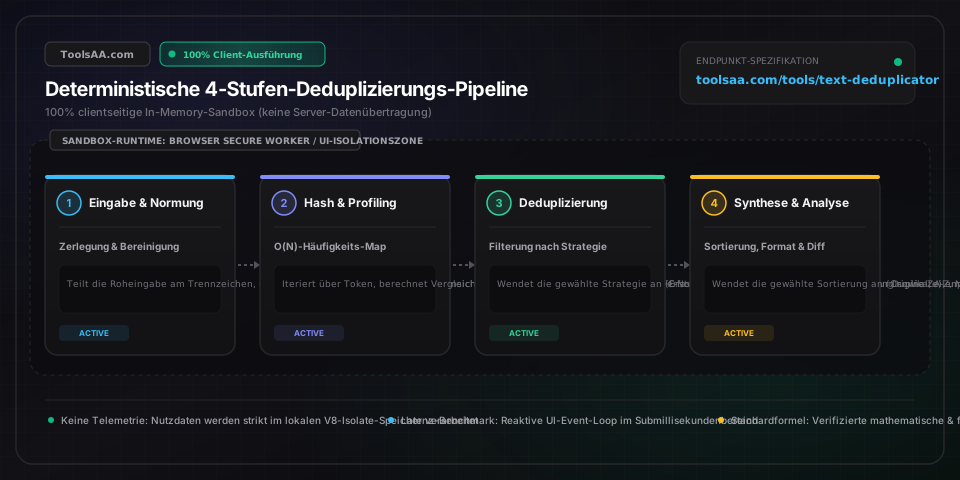
Technische Referenz & Architektur-Leitfaden

Doppelte Zeilen & Duplikate entfernen — Referenzhandbuch

Doppelte Zeilen aus Textlisten online entfernen. Whitespace bereinigen, Groß-/Kleinschreibung ignorieren, Unikate isolieren und saubere Daten sofort im Browser exportieren.

Doppelte Zeilen & Duplikate entfernen — Referenzhandbuch — Client-seitige In-Memory-Architektur und Datenfluss

Wichtige Parameter & Einstellungen

DeduplizierungsstrategieKollisionsauflösungsstrategie

Bestimmt das Verhalten bei identischen Token-Kollisionen. 'Erstes Vorkommen behalten' wahrt die ursprüngliche Eingabesequenz für revisionssichere Audit-Trails. 'Letztes Vorkommen behalten' erfasst den aktuellsten Statusübergang in Zeitreihenprotokollen. 'Nur Unikate' schließt alle Elemente mit einer Häufigkeit ≥ 2 vollständig aus, um nicht duplizierte Ausreißer zu isolieren. 'Nur Duplikate' filtert ausschließlich Zeilen mit einer Häufigkeit ≥ 2 zur Kollisionsprüfung heraus.

Standard: Erstes Vorkommen behalten
Unicode-Normalisierung & Case-FoldingTextnormalisierungsstandard

Wendet die kanonische Unicode-Zerlegung mit anschließender kanonischer Zusammensetzung an (NFC gemäß Unicode Standard Annex #15) kombiniert mit vollständigem Case-Folding (RFC 3454). Unterscheidet vorkomponierte Zeichen von kombinierenden Zeichensequenzen und harmonisiert sprachunabhängige Groß-/Kleinschreibung (wie deutsches 'ß' zu 'ss' oder griechisches Sigma 'ς'/'σ'/'Σ'), um falsch-negative Duplikaterkennungen über heterogene Systeme hinweg zu verhindern.

Standard: Groß-/Kleinschreibung ignorieren (NFC & Case-Folding)
Whitespace- & Zeilenumbruch-BereinigungBereinigungsfilter

Gleicht plattformübergreifende Zeilenumbruch-Diskrepanzen an (Windows CRLF 0x0D 0x0A, Unix LF 0x0A, älteres Mac CR 0x0D). Entfernt führende sowie nachfolgende ASCII-Leerzeichen (0x20) und Tabulatoren (0x09) und filtert geschützte Leerzeichen (U+00A0) sowie breitenlose Leerzeichen (U+200B) heraus. Verhindert, dass optisch identischer Text wegen unsichtbarer Steuerzeichen am Zeilenende die Duplikatprüfung nicht besteht.

Standard: Führende/nachfolgende Leerzeichen trimmen
Reihenfolge & Lexikografische SortierungSortiermodus

Legt die Sortierung nach der Bereinigung fest. 'Eingabereihenfolge beibehalten' wahrt die Chronologie des ersten Erscheinens mit O(N)-Lookup. 'Natürlich alphanumerisch' sortiert numerische Textsegmente nach ihrem realen Zahlenwert (z. B. 'item_2' vor 'item_10' statt standardmäßiger ASCII-0x31-Sortierung). 'Nach Häufigkeit absteigend' ordnet Token nach ihrer Vorkommensdichte für Pareto-Verteilungsanalysen.

Standard: Eingabereihenfolge beibehalten
Trennzeichen- & Token-GrenzparserTokenisierungsgrammatik

Konfiguriert die Begrenzungen zur Segmentierung des Datenstroms. Standard-Zeilenumbrüche trennen Zeilen, während CSV/TSV-Trennzeichen die Extraktion einzelner Spalten per Komma (,) oder Tabulator (\t) ermöglichen. Benutzerdefinierte reguläre Ausdrücke (RegEx) erlauben beliebige mehrstellige Trennmuster ohne manuelle Suchen-und-Ersetzen-Vorverarbeitung.

Standard: Universelle Zeilenumbrüche (\r?\n)

Profi-Tipps & Best Practices

Vorsicht vor unsichtbaren Windows-CRLF-Steuerzeichen beim Einfügen

Beim Kopieren von Text aus Microsoft Excel oder dem Windows-Editor (Notepad) enden Zeilen standardmäßig auf Carriage-Return-Zeichen (\r). Weist eine Zeile \r\n auf und eine optisch identische Zeile aus dem Browser nur \n, bewerten strikte Byte-Vergleiche diese als unterschiedliche Strings. Aktivieren Sie stets 'Leerzeichen trimmen', um nachgelagerte \r-Bytes vor der Duplikaterkennung zu entfernen.

Die Tücke unsichtbarer Nullbreiten-Leerzeichen bei Web-Scrapes (U+200B & U+00A0)

Aus Webseiten extrahierter Text und Rich-Text-Editoren enthalten häufig geschützte Leerzeichen (ASCII 160 / Unicode U+00A0) oder breitenlose Leerzeichen (U+200B). Einfache Trim-Funktionen in herkömmlichen Skripten entfernen meist nur das standardmäßige ASCII-Leerzeichen (0x20). Aktivieren Sie die erweiterte Unicode-Normalisierung, wenn Sie Text aus modernen Web-Apps, Google Tabellen oder CMS-Datenbanken bereinigen.

Deterministische Deduplizierung: Index-Invarianz bei Erhalt der Originalschreibweise

Befindet sich 'Apple' in Zeile 1 und 'apple' in Zeile 50, muss eine Deduplizierung ohne Beachtung der Groß-/Kleinschreibung im Modus 'Erstes Vorkommen behalten' 'Apple' ausgeben, während 'Letztes Vorkommen behalten' 'apple' sichert. Der Algorithmus mappt kleingeschriebene Token im Lookup-Index, referenziert dabei jedoch die ursprüngliche Formatierung, sodass Ihr Dokument nicht unerwünscht vollständig in Kleinbuchstaben konvertiert wird.

Pareto-Verteilung in großen Textlisten (Das 80/20-Duplikate-Phänomen)

In E-Mail-Verteilern, Server-Logs und SEO-Keyword-Dumps machen rund 20 % der einzigartigen Token oft 80 % aller doppelten Vorkommnisse aus. Eine Sortierung nach 'Häufigkeit absteigend' deckt verdächtigen Bot-Traffic (z. B. eine einzelne IP mit 10.000 Zugriffen) oder Massenabfragen sofort auf, ohne dass Sie Daten erst in externe Pivot-Tabellen exportieren müssen.

Häufige Fehlerquellen & Fehlerbehebung

⚠️Optisch identische Textzeilen werden nicht dedupliziert und verbleiben doppelt in der Ausgabe

Prüfen Sie auf nachstehende Leerzeichen, unsichtbare Carriage-Return-Zeichen (\r) aus Windows-/Excel-Dateien oder geschützte Leerzeichen (U+00A0). Aktivieren Sie sowohl 'Leerzeichen trimmen' als auch die 'Unicode-Normalisierung', um unsichtbare Steuerzeichen zu bereinigen.

⚠️Deduplizierung ohne Beachtung der Groß-/Kleinschreibung ändert unerwartet die Schreibweise einzelner Zeilen

Stellen Sie sicher, dass Ihre Deduplizierungsstrategie auf 'Erstes Vorkommen behalten' gesetzt ist, statt einen erzwungenen Kleinbuchstaben-Export zu wählen. Die Engine indiziert Token über Hash-Schlüssel in Kleinschreibung, bewahrt dabei aber die exakte Originalschreibweise der ersten Instanz.

⚠️Alphanumerische IDs mit Nummern sortieren falsch (z. B. steht ID-10 vor ID-2)

Die standardmäßige lexikografische Sortierung vergleicht Zeichencodes sequenziell ('1' < '2') und platziert dadurch '10' vor '2'. Wählen Sie beim Sortierparameter 'Natürlich alphanumerisch', damit zusammenhängende Ziffernfolgen als Ganzzahlen interpretiert werden.

⚠️Die Browser-Oberfläche reagiert träge beim Einfügen von Textdateien mit über 100.000 Zeilen

Deaktivieren Sie den visuellen 'Diff'-Inspektor bei extrem großen Datensätzen ab 50.000 Zeilen. Der eigentliche Deduplizierungsalgorithmus arbeitet mit Hash-Maps in O(N)-Linearzeit, das Rendern komplexer DOM-Elemente für visuelle Vergleiche beansprucht jedoch viel Arbeitsspeicher. Wechseln Sie direkt auf den Reiter 'Bereinigter Text' für verzögerungsfreie Verarbeitung.

Häufig gestellte Fragen (FAQ)

Wie entfernt man doppelte Zeilen aus einer Textdatei unter Beibehaltung der ursprünglichen Reihenfolge?▼

Um doppelte Zeilen ohne Veränderung der Reihenfolge zu löschen, wird das Zeilen-Array sequenziell durchlaufen und ein Hash-Set zur Erfassung bereits verarbeiteter Einträge in linearer O(N)-Zeitkomplexität genutzt. Eine Zeile wird nur dann in die Ausgabe übernommen, wenn ihr normalisierter Schlüssel noch nicht im Set existiert; beim ersten Antreffen wird der Schlüssel registriert. Dies bewahrt die exakte chronologische Reihenfolge der ersten Vorkommnisse – im Gegensatz zum Unix-Befehl 'sort -u', der Zeilen alphabetisch umsortiert.

Was ist der Unterschied zwischen dem Entfernen von Duplikaten und dem Finden von Unikaten?▼

Das Entfernen von Duplikaten reduziert mehrfache Einträge auf genau ein repräsentatives Exemplar (aus [A, B, A, C] wird [A, B, C]). Das Isolieren von Unikaten (Singletons) hingegen schließt alle Zeilen, die mehr als einmal vorkommen, restlos aus und gibt ausschließlich Zeilen zurück, die genau ein einziges Mal existieren (aus [A, B, A, C] wird [B, C]).

Wie behandeln case-sensitive und case-insensitive Deduplizierungen Unicode-Texte?▼

Die Deduplizierung mit Beachtung der Groß-/Kleinschreibung vergleicht exakte UTF-16-Code-Units, sodass 'Berlin' und 'berlin' als völlig unterschiedliche Einträge gelten. Bei Nichtbeachtung der Groß-/Kleinschreibung kommt vollständiges Unicode-Case-Folding zum Einsatz (wie die Wandlung von 'ß' zu 'ss' und der Abgleich akzentuierter Zeichen). Hierbei werden Varianten auf einen kanonischen Vergleichsschlüssel gemappt, während die ursprüngliche Schreibweise des ersten Eintrags unverändert erhalten bleibt.

Wie dedupliziert man Zeilen in großen CSV- oder tabulatorgetrennten Tabellen?▼

Wählen Sie als Trennzeichen universelle Zeilenumbrüche (\n), um vollständige Tabellenzeilen zu bereinigen, oder nutzen Sie Komma (,) bzw. Tabulator (\t), um eindeutige Werte einzelner Spalten zu filtern. Eine Vorab-Bereinigung durch Trimmen von Rändern und das Entfernen von Leerzeilen stellt sicher, dass aus Microsoft Excel oder Google Tabellen exportierte Datensätze mit überflüssigen Leerzeichen oder Windows-Zeilenumbrüchen (\r\n) fehlerfrei bereinigt werden.

Verwandte Tools & Hilfsprogramme

Alle Tools →