Eliminar Duplicados de Texto
Tier M • Doble Espacio de Trabajo

Eliminar Duplicados & Líneas de Texto

Herramienta en el navegador para eliminar líneas duplicadas de listas de texto. Recorta espacios en blanco, ignora mayúsculas, aísla filas únicas y exporta datos limpios al instante.

100% Privado en el Navegador
Sin Envío al Servidor
Plantillas Predefinidas
Lienzo de Entrada de Texto0 Líneas
Estrategia de Deduplicación
Delimitador y Modo de Ingesta
Flujo de Ingesta44.4% Tasa de Reducción
Flujo de IngestaNFCNormalizaciónO(N)Mapa Hash O(N)FLTREstrategia de FiltradoSalida Limpia
0 Líneas•218 Caracteres•Formato de Salto de Línea: CRLF
Local Sandbox Only
Delimitador de Unión de Salida
0 Líneas•-0 Duplicados Eliminados•44.4% Tasa de Reducción
Espacio Ahorrado: 0 Bytes
Registros Originales0
Entradas Únicas0 (55.6%)
Duplicados Eliminados0 (44.4%)

Procesamiento en el Cliente

Cálculo de alto rendimiento ejecutado íntegramente en la memoria del navegador.

Privacidad Total Sin Subidas al Servidor

Todos los datos permanecen estrictamente locales, sin comunicación con servidores externos.

Exportación Lista para Producción

Formatos limpios y optimizados listos para su uso e integración inmediata.
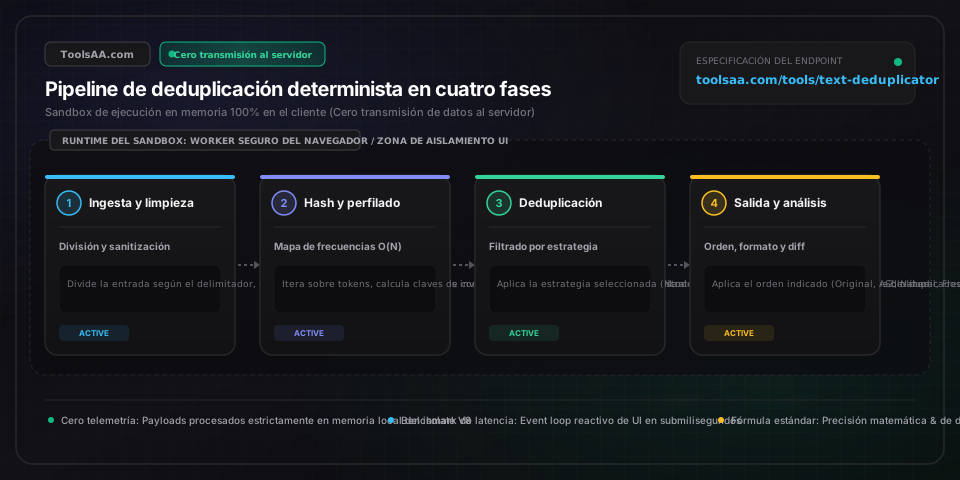
Referencia técnica y guía de arquitectura

Eliminar líneas duplicadas de texto — Guía de referencia

Herramienta para eliminar líneas duplicadas en listas y textos. Limpia espacios, ignora mayúsculas, aísla filas únicas y exporta datos limpios en tu navegador.

Eliminar líneas duplicadas de texto — Guía de referencia — Arquitectura en memoria del lado del cliente y flujo de datos

Parámetros clave y controles

Modo de estrategia de deduplicaciónEstrategia de resolución de colisiones

Determina el criterio ante la colisión de elementos repetidos. «Conservar primero» mantiene la cronología original para registros de auditoría incremental. «Conservar último» captura el estado más reciente en registros temporales (logs). «Solo valores únicos» excluye líneas que aparezcan 2 o más veces para aislar valores atípicos no duplicados. «Solo duplicados» extrae exclusivamente líneas con frecuencia mayor o igual a 2 para auditar redundancias.

Por defecto: Conservar primera aparición
Normalización Unicode y distinción de mayúsculasEstándar de normalización de texto

Aplica descomposición canónica seguida de composición canónica (NFC según Unicode Standard Annex #15) junto con case folding completo (RFC 3454). Distingue caracteres precompuestos de secuencias de combinación y unifica grafías independientes de la configuración regional (como la 'ß' alemana a 'ss' o las variantes de sigma griega 'ς'/'σ'/'Σ'), evitando falsos negativos en sistemas heterogéneos.

Por defecto: No distinguir mayúsculas/minúsculas (NFC Folded)
Saneamiento de espacios en blanco y saltos de líneaFiltro de saneamiento

Normaliza discrepancias de saltos de línea entre plataformas (Windows CRLF 0x0D 0x0A, Unix LF 0x0A, Mac clásico CR 0x0D). Elimina espacios iniciales y finales ASCII (0x20) y tabulaciones (0x09), filtrando además espacios de no separación (U+00A0) y espacios de ancho cero (U+200B). Evita que textos visualmente idénticos no coincidan debido a retornos de carro invisibles.

Por defecto: Recortar espacios iniciales y finales
Ordenación de secuencias y orden lexicográficoCriterio de ordenación

Define la ordenación posterior a la deduplicación. «Conservar orden de entrada» mantiene la cronología de primera aparición con búsqueda O(N). «Alfanumérico natural» aplica ordenación numérica por bloques (p. ej., «ítem_2» antes de «ítem_10» en lugar de la ordenación ASCII 0x31 estándar). «Frecuencia descendente» clasifica las líneas según su densidad de repetición para análisis de Pareto.

Por defecto: Conservar orden de entrada
Delimitador y analizador de límites de tokenGramática de tokenización

Configura los límites de segmentación del flujo de texto. El salto de línea estándar separa renglones, mientras que los delimitadores CSV/TSV permiten extraer columnas por coma (,) o tabulación (\t). Las expresiones regulares personalizadas permiten segmentar por delimitadores multicarácter sin necesidad de buscar y reemplazar manualmente.

Por defecto: Saltos de línea universales (\r?\n)

Consejos profesionales y mejores prácticas

Cuidado con los retornos CRLF invisibles de Windows al pegar desde Excel

Al copiar texto desde Microsoft Excel o Bloc de notas en Windows hacia el navegador, las líneas suelen terminar con el carácter de retorno de carro \r. Si una línea contiene \r\n y otra idéntica copiada desde una web contiene solo \n, una comparación binaria estricta las considerará distintas. Activa siempre «Recortar espacios en blanco» para despojar los bytes \r finales antes de procesar duplicados.

La trampa oculta del espacio de ancho cero en contenidos web (U+200B y U+00A0)

Los textos extraídos de páginas web y editores enriquecidos suelen contener espacios de no separación (ASCII 160 / Unicode U+00A0) o espacios de ancho cero (U+200B). Los métodos de recorte básicos solo eliminan el espacio ASCII convencional (0x20). Asegúrate de activar la normalización Unicode avanzada al deduplicar datos procedentes de páginas web, Google Sheets o bases de datos de CMS.

La deduplicación determinista requiere ignorar mayúsculas sin alterar el formato original

Si tienes «Manzana» en la línea 1 y «manzana» en la línea 50, una deduplicación que ignore mayúsculas en modo «Conservar primero» debe retener «Manzana», mientras que en «Conservar último» debe retener «manzana». El algoritmo indexa claves normalizadas en minúsculas mientras preserva el formato de la primera instancia hallada, evitando transformar todo tu documento a minúsculas.

Distribución de Pareto en listas extensas (la regla 80/20 de los duplicados)

En bases de datos de correos electrónicos, registros de servidor o listas de palabras clave para SEO, aproximadamente el 20 % de los elementos únicos acumula el 80 % de las repeticiones. Ordenar por «Frecuencia descendente» saca a la luz de inmediato anomalías como tráfico de bots (p. ej., una misma IP repetida 10.000 veces) o registros masivos duplicados sin necesidad de crear tablas dinámicas en hojas de cálculo externas.

Problemas comunes y soluciones

⚠️Líneas que parecen idénticas no se deduplican y permanecen repetidas en el resultado

Verifica si existen espacios finales, retornos de carro invisibles \r procedentes de Windows o Excel, o espacios de no separación (U+00A0). Activa tanto «Recortar espacios en blanco» como «Normalización Unicode» para limpiar los caracteres no imprimibles.

⚠️La deduplicación sin distinción de mayúsculas altera inesperadamente el formato del texto

Comprueba que la estrategia de deduplicación esté configurada en «Conservar primera aparición» en lugar de una opción que fuerce la conversión a minúsculas. El motor indexa los elementos usando claves hash en minúsculas pero conserva intactas las mayúsculas de la primera instancia procesada.

⚠️Los identificadores alfanuméricos con números se ordenan incorrectamente (ej. ID-10 antes de ID-2)

La ordenación lexicográfica estándar compara los códigos de caracteres de forma secuencial ('1' < '2'), situando '10' antes de '2'. Cambia el parámetro de orden a «Orden alfanumérico natural» para evaluar numéricamente los fragmentos con valores enteros.

⚠️La interfaz del navegador se ralentiza al pegar archivos de texto con más de 100.000 líneas

Desactiva la vista comparativa de diferencias (Diff Inspector) cuando trabajes con conjuntos de datos masivos que superen las 50.000 líneas. Aunque el algoritmo principal de deduplicación opera en tiempo lineal O(N) con tablas hash, la renderización visual de diferencias en el DOM consume memoria excesiva. Utiliza la pestaña directa «Resultado limpio» para un procesamiento instantáneo.

Preguntas frecuentes (FAQ)

¿Cómo eliminar líneas duplicadas de un archivo de texto manteniendo el orden original?▼

Para eliminar duplicados conservando el orden cronológico original, recorre la lista secuencialmente utilizando una estructura de datos Hash Set para registrar los elementos procesados con una complejidad temporal O(N). Solo se emite una línea si su clave normalizada aún no existe en el conjunto, registrándola en su primera aparición. A diferencia del comando sort -u de Unix, que ordena alfabéticamente, este método preserva con total fidelidad la secuencia de entrada.

¿Cuál es la diferencia entre eliminar duplicados y encontrar líneas únicas?▼

Eliminar duplicados reduce las repeticiones a una única entrada representativa (por ejemplo, [A, B, A, C] pasa a ser [A, B, C]). Por el contrario, encontrar líneas únicas (también denominadas elementos aislados o valores sin repetición) descarta por completo cualquier línea que aparezca más de una vez, devolviendo exclusivamente aquellos elementos cuya frecuencia sea exactamente uno (por ejemplo, [A, B, A, C] devuelve únicamente [B, C]).

¿Cómo gestiona el texto Unicode la deduplicación con y sin distinción de mayúsculas?▼

La deduplicación que distingue mayúsculas realiza una comparación estricta de unidades de código UTF-16, tratando 'Madrid' y 'madrid' como cadenas totalmente distintas. En cambio, la deduplicación insensible a mayúsculas aplica case folding completo según el estándar Unicode (transformando, por ejemplo, la 'ß' alemana en 'ss' y unificando vocales con tildes o acentos diacríticos), asociando las variantes a una clave de comparación canónica mientras preserva el formato tipográfico original de la primera entrada.

¿Cómo eliminar líneas duplicadas en archivos CSV o tablas delimitadas por tabuladores?▼

Configura el delimitador en saltos de línea universales (\n) para deduplicar filas completas de la hoja de cálculo, o selecciona la coma (,) o el tabulador (\t) para extraer valores únicos columna por columna. Aplicar un saneamiento previo mediante el recorte de espacios en blanco y la eliminación de renglones vacíos garantiza que las exportaciones desde Microsoft Excel o Google Sheets que contengan espacios residuales o retornos CRLF (\r\n) se procesen con absoluta precisión.

Herramientas y utilidades relacionadas

Todas las herramientas →