Deduplicador de Texto
Tier M • Dual-Workbench

Deduplicador de Texto & Remover Linhas

Deduplicador de texto para remover linhas duplicadas de listas. Elimine espaços extras, ignore maiúsculas e minúsculas, isole linhas únicas e exporte dados limpos no navegador.

100% Privado no Navegador
Zero Envio para Servidores
Predefinições
Fluxo de Entrada Original0 Linhas
Estratégia de Deduplicação
Delimitador e Modo de Leitura
Entrada Bruta44.4% Taxa de Redução
Entrada BrutaNFCNormalizaçãoO(N)Mapa Hash O(N)FLTRFiltro de EstratégiaSaída Limpa
0 Linhas•218 Caracteres•Formato de Quebra: CRLF
Local Sandbox Only
Delimitador de União na Saída
0 Linhas•-0 Duplicados Eliminados•44.4% Taxa de Redução
Espaço Economizado: 0 Bytes
Registros Originais0
Entradas Únicas0 (55.6%)
Duplicados Eliminados0 (44.4%)

Processamento no Navegador

Processamento de alto desempenho executado inteiramente na memória do navegador.

Privacidade Zero Upload

Todos os dados permanecem estritamente locais, sem comunicação com servidores externos.

Exportação Pronta para Produção

Formatos limpos e otimizados prontos para integração e uso imediato.
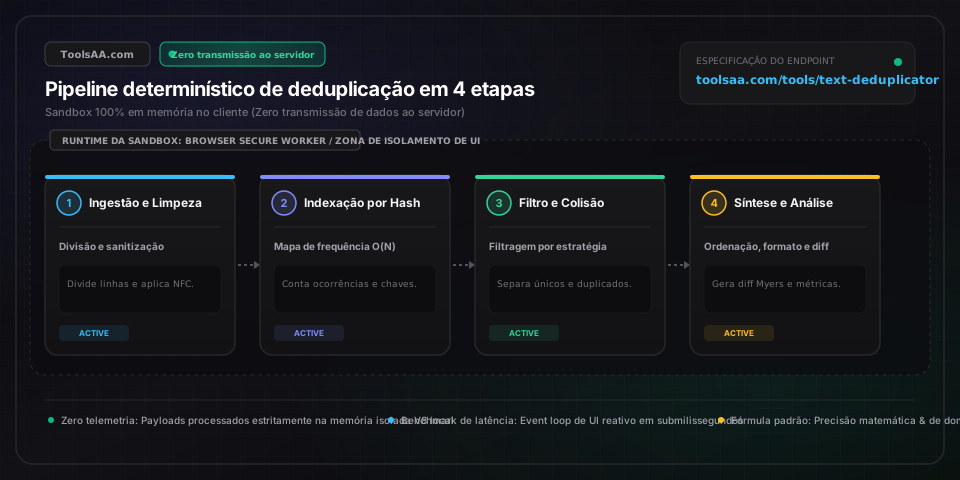
Referência técnica e guia de arquitetura

Remover Linhas Duplicadas & Repetidas — Guia de referência

Deduplicador de texto para remover linhas duplicadas de listas. Remova espaços extras, ignore maiúsculas, isole linhas exclusivas e exporte dados limpos no navegador.

Remover Linhas Duplicadas & Repetidas — Guia de referência — Arquitetura em memória do lado do cliente e fluxo de dados

Parâmetros-chave e controles

Modo de Estratégia de DeduplicaçãoEstratégia de Resolução de Colisões

Determina o tratamento quando tokens recorrentes colidem. 'Manter Primeira' preserva a sequência original de inserção para trilhas de auditoria cumulativas. 'Manter Última' captura as transições de estado mais recentes em logs temporais. 'Apenas Exclusivos' descarta qualquer elemento com 2 ou mais ocorrências para isolar registros únicos. 'Apenas Duplicados' filtra exclusivamente linhas com frequência >= 2 para auditoria de redundâncias.

Padrão: Manter Primeira Ocorrência
Normalização Unicode e Case FoldingPadrão de Normalização de Texto

Aplica Decomposição Canônica seguida de Composição Canônica Unicode (NFC via Anexo #15 do Padrão Unicode) em conjunto com case folding integral (RFC 3454). Diferencia caracteres pré-compostos de sequências combinadas e padroniza maiúsculas e minúsculas de forma independente de localidade (como 'ß' alemão para 'ss' ou o sigma grego 'ς'/'σ'/'Σ'), prevenindo falsos negativos na detecção entre sistemas heterogêneos.

Padrão: Insensível a Maiúsculas (NFC Folded)
Higienização de Espaços e Quebras de LinhaFiltro de Sanitização

Padroniza divergências de quebra de linha entre sistemas operacionais (Windows CRLF 0x0D 0x0A, Unix LF 0x0A e Mac legado CR 0x0D). Elimina espaços em branco ASCII iniciais e finais (0x20) e tabulações (0x09), filtrando também espaços não separáveis (U+00A0) e espaços de largura zero (U+200B). Impede que textos visualmente idênticos falhem na deduplicação devido a quebras de retorno invisíveis.

Padrão: Remover Espaços Iniciais/Finais
Ordenação Sequencial e Ordem LexicográficaDisposição de Ordenação

Define a ordenação após a remoção de duplicatas. 'Preservar Ordem Original' mantém a cronologia de entrada com busca em tempo O(N). 'Alfanumérico Natural' aplica ordenação numérica por blocos (ex.: 'item_2' antes de 'item_10', em vez da ordenação ASCII pura 0x31). 'Frequência Decrescente' classifica os itens por densidade de repetição para análise de distribuição de Pareto.

Padrão: Preservar Ordem Original
Analisador de Delimitadores e Limites de TokenGramática de Tokenização

Configura os limites de segmentação do fluxo de texto. Quebras de linha padrão dividem linhas sequenciais, enquanto delimitadores CSV/TSV permitem isolar colunas por vírgula (,) ou tabulação (\t). Expressões regulares personalizadas possibilitam capturar múltiplos caracteres delimitadores sem a necessidade de substituições manuais prévias.

Padrão: Quebras de Linha Universais (\r?\n)

Dicas profissionais e melhores práticas

Atenção ao Retorno de Carro (CRLF) Invisível do Windows ao Colar Dados

Ao copiar dados do Microsoft Excel ou Bloco de Notas do Windows para o navegador, as linhas frequentemente terminam com o caractere de retorno \r. Se uma linha contém \r\n e outra idêntica colada da web possui apenas \n, a comparação estrita de bytes as considera diferentes. Ative sempre 'Remover Espaços' para eliminar bytes \r finais antes do processamento de duplicatas.

O Risco Oculto do Espaço de Largura Zero em Raspagens da Web (U+200B e U+00A0)

Textos extraídos de páginas web, planilhas do Google Sheets ou editores ricos frequentemente contêm espaços não separáveis (ASCII 160 / Unicode U+00A0) ou espaços de largura zero (U+200B). O trim padrão de scripts simples remove apenas o espaço ASCII comum (0x20). Certifique-se de ativar a normalização Unicode avançada ao deduplicar listas exportadas da internet ou de bancos de dados CMS.

Deduplicação Determinística Exige Invariância de Caixa sem Descaracterizar o Texto

Se você tiver 'Brasil' na linha 1 e 'brasil' na linha 50, a deduplicação sem distinção de maiúsculas no modo 'Manter Primeira' preservará 'Brasil', enquanto 'Manter Última' manterá 'brasil'. O algoritmo indexa os tokens em minúsculas para comparação enquanto armazena a referência original, garantindo que o resultado final mantenha a formatação autêntica sem converter todo o documento para minúsculas.

Distribuição de Pareto em Grandes Listas (A Regra 80/20 de Duplicatas)

Em cadastros de e-mails, logs de servidores e listas de palavras-chave, cerca de 20% dos termos únicos concentram 80% das ocorrências repetidas. Ordenar por 'Frequência Decrescente' revela instantaneamente disparos anômalos de bots (como um mesmo IP repetido 10.000 vezes) ou cadastros repetidos em lote sem exigir a criação de tabelas dinâmicas em planilhas externas.

Armadilhas comuns e solução de problemas

⚠️Linhas aparentemente idênticas não são deduplicadas e continuam repetidas na saída

Verifique se há espaços invisíveis no final da linha, caracteres de retorno \r do Windows/Excel ou espaços não separáveis (U+00A0). Ative 'Remover Espaços' e 'Normalização Unicode' para limpar preenchimentos invisíveis.

⚠️A deduplicação insensível a maiúsculas altera inesperadamente a caixa de itens únicos

Certifique-se de selecionar 'Manter Primeira Ocorrência' em vez de forçar a conversão de caixa. O mecanismo indexa chaves em minúsculas internamente, mas preserva a grafia original do primeiro registro encontrado.

⚠️Identificadores alfanuméricos com números ordenam incorretamente (ex.: ID-10 antes de ID-2)

A ordenação lexicográfica padrão compara códigos de caracteres sequencialmente ('1' < '2'), posicionando '10' antes de '2'. Altere o critério de ordenação para 'Alfanumérico Natural' para interpretar segmentos numéricos pelo seu valor real.

⚠️A interface do navegador fica lenta ao colar arquivos de texto com mais de 100.000 linhas

Desative a inspeção visual de diferenças (Diff) lado a lado em conjuntos de dados superiores a 50.000 linhas. O algoritmo de deduplicação opera em tempo linear O(N) com tabelas hash de alta velocidade, mas a renderização de elementos complexos no DOM consome memória do navegador. Utilize a aba de saída direta para processamento instantâneo.

Perguntas frequentes (FAQ)

Como remover linhas duplicadas de um texto preservando a ordem original?▼

Para remover linhas duplicadas mantendo a cronologia original, percorra a lista sequencialmente utilizando um Hash Set para registrar os itens já processados com complexidade de tempo O(N). Uma linha só é adicionada à saída se sua chave normalizada ainda não existir no conjunto, sendo registrada no primeiro encontro. Diferente do comando Unix 'sort -u' (que força a ordenação alfabética), esse método preserva a ordem exata de entrada.

Qual é a diferença entre remover duplicatas e encontrar linhas exclusivas?▼

Remover duplicatas consolida as repetições em uma única ocorrência representativa (por exemplo, [A, B, A, C] torna-se [A, B, C]). Já encontrar linhas exclusivas (também chamadas de valores únicos ou não repetidos) elimina completamente qualquer linha que tenha ocorrido duas ou mais vezes, retornando apenas os itens que apareceram exatamente uma vez (por exemplo, [A, B, A, C] resulta apenas em [B, C]).

Como a deduplicação com e sem distinção de maiúsculas lida com texto Unicode?▼

A deduplicação com distinção de maiúsculas (case-sensitive) faz a comparação estrita de unidades de código UTF-16, considerando 'São Paulo' e 'são paulo' registros distintos. Já a deduplicação sem distinção (case-insensitive) aplica o desdobramento de caixa Unicode (case folding, como a conversão de 'ß' alemão em 'ss' e a normalização de acentos gráficos), agrupando variações maiúsculas e minúsculas sob uma mesma chave canônica enquanto preserva a grafia da primeira ocorrência encontrada.

Como remover linhas duplicadas em arquivos CSV ou planilhas delimitadas por tabulação?▼

Defina o delimitador como quebra de linha universal (\n) para deduplicar linhas inteiras de planilhas, ou selecione vírgula (,) ou tabulação (\t) para extrair valores únicos de colunas específicas. A pré-filtragem com remoção de espaços em branco e exclusão de linhas vazias garante que exportações do Microsoft Excel ou Google Sheets contendo espaços residuais ou quebras Windows (\r\n) sejam higienizadas com total precisão.

Ferramentas e utilitários relacionados

Todas as ferramentas →