Dédoublonneur de texte
Niveau M • Double atelier

Dédoublonneur de Texte & Lignes

Dédoublonneur de texte pour supprimer les lignes en double de vos listes. Nettoyez les espaces superflus, ignorez la casse, isolez les lignes uniques et exportez vos données instantanément dans votre navigateur.

100 % local & privé
Zéro serveur
Scénarios prédéfinis
Flux d'entrée brut0 Lignes
Stratégie de dédoublonnage
Délimiteur
Ingestion brute44.4% Taux de réduction
Ingestion bruteNFCNormalisationO(N)Moteur de hachage O(N)FLTRStratégie de filtrageSortie épurée
0 Lignes•218 Caractères•Format de fin de ligne: CRLF
Local Sandbox Only
Délimiteur d'assemblage
0 Lignes•-0 Doublons éliminés•44.4% Taux de réduction
Espace économisé: 0 Octets
Enregistrements initiaux0
Entrées uniques0 (55.6%)
Doublons éliminés0 (44.4%)

Traitement côté client

Calcul haute performance exécuté intégralement dans la mémoire du navigateur.

Zéro transfert vers un serveur

Toutes les données restent strictement locales, sans aucune transmission vers des serveurs externes.

Export prêt pour la production

Formats de sortie propres et optimisés, prêts pour une exploitation immédiate.
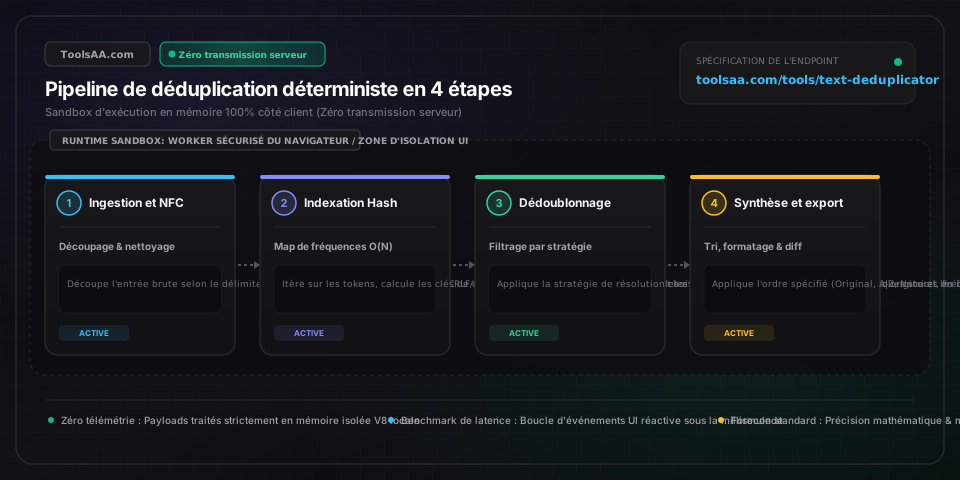
Référence technique et guide d'architecture

Supprimer les Doublons de Texte — Guide de référence

Outil de dédoublonnage pour supprimer les lignes en double de vos listes. Nettoyez les espaces, ignorez la casse, isolez les lignes uniques et exportez vos données directement dans votre navigateur.

Supprimer les Doublons de Texte — Guide de référence — Architecture en mémoire côté client et flux de données

Paramètres clés et contrôles

Mode de stratégie de dédoublonnageStratégie de résolution des collisions

Définit le traitement appliqué lors de la collision de jetons récurrents. « Conserver le premier » préserve la chronologie d'origine des entrées pour les journaux d'audit séquentiels. « Conserver le dernier » retient les transitions d'état les plus récentes dans les journaux temporels. « Valeurs uniques uniquement » exclut tout élément présent au moins 2 fois afin d'isoler les valeurs orphelines non dupliquées. « Doublons uniquement » extrait exclusivement les lignes dont la fréquence est >= 2 pour l'audit des collisions.

Par défaut : Conserver la première occurrence
Normalisation Unicode & casse insensibleNorme de normalisation textuelle

Applique la décomposition canonique suivie de la composition canonique Unicode (NFC selon l'annexe #15 du standard Unicode) ainsi que le pliage complet de la casse (RFC 3454). Distingue les caractères précomposés des séquences de caractères combinants et standardise la casse indépendamment de la région linguistique (comme le « ß » allemand converti en « ss » ou le sigma grec « ς »/« σ »/« Σ »), évitant les faux négatifs lors de la détection de doublons entre systèmes hétérogènes.

Par défaut : Insensible à la casse (pliage NFC)
Nettoyage des espaces & sauts de ligneFiltre d'assainissement

Uniformise les écarts de fin de ligne interplateformes (Windows CRLF 0x0D 0x0A, Unix LF 0x0A, ancien Mac CR 0x0D). Élimine les espaces ASCII (0x20) et tabulations (0x09) en début et fin de ligne, tout en filtrant les espaces insécables (U+00A0) et les espaces sans chasse (U+200B). Empêche deux textes visuellement identiques d'échouer au test de doublon en raison d'un retour chariot invisible.

Par défaut : Supprimer les espaces de début et fin
Tri de séquence & ordre lexicographiqueRègle d'ordonnancement

Définit l'ordonnancement après le dédoublonnage. « Conserver l'ordre initial » maintient la chronologie de la première apparition avec une complexité de recherche en O(N). « Tri alphanumérique naturel » segmente les blocs numériques pour trier logiquement (par exemple « item_2 » avant « item_10 » au lieu du tri standard ASCII 0x31). « Fréquence décroissante » classe les éléments par densité d'occurrences pour l'analyse de distribution de Pareto.

Par défaut : Conserver l'ordre initial
Séparateur & analyseur de délimitationGrammaire de segmentation

Configure les frontières de découpage du flux de données. Le saut de ligne standard sépare les lignes, tandis que les délimiteurs CSV/TSV permettent d'extraire des colonnes par virgule (,) ou tabulation (\t). Les expressions régulières personnalisées autorisent des séparateurs arbitraires multi-caractères sans nécessiter de prétraitement manuel par rechercher-remplacer.

Par défaut : Sauts de ligne universels (\r?\n)

Conseils de pro et bonnes pratiques

Attention au retour chariot CRLF invisible de Windows lors des copier-coller

Lors d'un copier-coller depuis Excel ou le Bloc-notes Windows vers un navigateur, les lignes se terminent souvent par un caractère de retour chariot \r. Si une ligne contient \r\n et qu'une ligne visuellement identique copiée depuis le web ne contient que \n, une comparaison binaire stricte les traitera comme deux chaînes distinctes. Activez systématiquement le nettoyage des espaces pour purger l'octet \r résiduel avant l'indexation des doublons.

Le piège insidieux des espaces sans chasse et insécables du web (U+200B & U+00A0)

Les données extraites du web et des éditeurs de texte enrichi comportent régulièrement des espaces insécables (ASCII 160 / Unicode U+00A0) ou des espaces sans chasse (U+200B). Le nettoyage classique d'un script élémentaire ne supprime bien souvent que l'espace ASCII standard (0x20). Veillez à activer la normalisation Unicode avancée lors du traitement de listes issues de pages web modernes, de Google Sheets ou de bases de données CMS.

Un dédoublonnage déterministe impose l'invariance de casse avant la restitution

Si vous disposez de « Apple » à la ligne 1 et « apple » à la ligne 50, un dédoublonnage insensible à la casse en mode « Conserver le premier » doit retenir « Apple », tandis que le mode « Conserver le dernier » retiendra « apple ». L'algorithme indexe les clés en minuscules dans une table de hachage tout en préservant la référence vers la casse d'origine, évitant ainsi de convertir l'intégralité de votre document en minuscules.

Loi de Pareto dans les grands fichiers texte (la répartition 80/20 des doublons)

Dans les bases d'adresses e-mail, les journaux de serveurs et les exports de mots-clés, environ 20 % des valeurs uniques génèrent 80 % du volume total des doublons. Un tri par « Fréquence décroissante » met instantanément en évidence les requêtes anormales de robots spammeurs (comme une adresse IP répétée 10 000 fois) ou les scrapings massifs sans avoir à exporter vos données vers un tableau croisé dynamique externe.

Pièges courants et dépannage

⚠️Des lignes de texte visuellement identiques ne sont pas dédoublonnées dans le résultat

Vérifiez la présence d'espaces en fin de ligne, de retours chariot \r invisibles provenant de Windows ou d'Excel, ou d'espaces insécables (U+00A0). Activez à la fois le « Nettoyage des espaces » et la « Normalisation Unicode » pour assainir ces caractères masqués.

⚠️Le dédoublonnage insensible à la casse modifie inopinément la casse des éléments conservés

Vérifiez que votre mode de dédoublonnage est configuré sur « Conserver la première occurrence » plutôt que sur une conversion forcée en minuscules. Le moteur indexe les jetons avec des clés de hachage minuscules tout en conservant scrupuleusement la graphie d'origine de la première occurrence rencontrée.

⚠️Les identifiants alphanumériques contenant des chiffres sont mal triés (ex. ID-10 avant ID-2)

Le tri lexicographique classique compare les codes de caractères de manière séquentielle ('1' < '2'), ce qui place '10' avant '2'. Activez l'option « Tri alphanumérique naturel » afin d'interpréter les séquences d'entiers contigus selon leur valeur numérique réelle.

⚠️L'interface du navigateur ralentit lors du collage de fichiers de plus de 100 000 lignes

Désactivez la vue comparative « Inspecteur de différences » pour les volumes massifs dépassant 50 000 lignes. L'algorithme central de dédoublonnage s'exécute en temps linéaire O(N) grâce à des tables de hachage, mais le rendu visuel du diff dans le DOM consomme beaucoup de mémoire. Utilisez directement l'onglet « Résultat nettoyé » pour un traitement instantané.

Foire aux questions (FAQ)

Comment supprimer les lignes en double d'un fichier texte en conservant l'ordre d'origine ?▼

Pour supprimer les doublons tout en préservant l'ordre initial, parcourez le tableau de lignes séquentiellement en utilisant une structure Hash Set pour mémoriser les éléments déjà vus en complexité temporelle O(N). N'insérez une ligne dans la sortie que si sa clé normalisée n'est pas encore enregistrée dans le Set, en l'y ajoutant lors de sa première occurrence. Cette méthode conserve la chronologie exacte d'apparition, à la différence de la commande Unix sort -u qui réordonne les lignes par ordre alphabétique.

Quelle est la différence entre supprimer les doublons et extraire les lignes uniques ?▼

Supprimer les doublons consiste à réduire les répétitions à un exemplaire unique (par exemple [A, B, A, C] devient [A, B, C]). Extraire les lignes uniques (ou singletons) élimine au contraire toute entrée apparaissant deux fois ou plus, pour ne conserver exclusivement que les éléments présents une seule et unique fois (ainsi [A, B, A, C] renvoie uniquement [B, C]).

Comment le dédoublonnage sensible ou insensible à la casse gère-t-il le texte Unicode ?▼

Le dédoublonnage sensible à la casse compare strictement les unités de code UTF-16, traitant « Paris » et « paris » comme deux éléments totalement distincts. Le dédoublonnage insensible à la casse applique le repliement de casse Unicode complet (comme la conversion du « ß » allemand en « ss » et l'uniformisation des caractères accentués), associant majuscules et minuscules à une clé canonique commune tout en conservant la graphie d'origine de la première occurrence.

Comment supprimer les doublons dans un fichier CSV ou un tableau délimité par des tabulations ?▼

Définissez le séparateur sur les sauts de ligne universels (\n) pour dédoublonner des lignes complètes de tableau, ou sélectionnez la virgule (,) ou la tabulation (\t) pour isoler les valeurs uniques d'une seule colonne. Le pré-filtrage par suppression des espaces superflus et des lignes vides garantit que les données exportées depuis Microsoft Excel ou Google Sheets contenant des espaces résiduels ou des retours chariot Windows (\r\n) soient dédoublonnées avec une précision absolue.

Outils et utilitaires connexes

Tous les outils →