/
Calculadora de P-Valor & Testes Z e t

Calculadora de P-Valor & Testes Z e t

Nível de Significância

Calculadora de p-valor para testes Z, t de Student, qui-quadrado e F. Determine a significância uni e bicaudal, valores críticos e metas de testes inversos.

Cenários Clínicos e Estatísticos Rápidos
Região de Decisão e Caudas
2.450
58
0.05
Correção para Múltiplas ComparaçõesAjuste de Bonferroni (α / k) 0.05000
Conclusão da Inferência EstatísticaRejeitar H₀
Evidência Significativa
P-Valor Exato (p)0.01731.73e-2
Estatística de Teste (Z, t, F, χ²)2.450T (58 df)
Fronteira Crítica de Rejeição2.002α = 0.0500
Alfa Nominal (α)0.05k = 1

Interpretação e Veredito do Teste

O valor-p calculado é menor ou igual ao nível de significância nominal (p ≤ α). Rejeita-se a hipótese nula (H₀) em favor da hipótese alternativa (H₁).

IC de 95%[0.490, 4.410]

Intervalo de confiança paramétrico derivado da distribuição do erro padrão amostral.

Direção das Caudas do TesteBicaudal (Bilateral, ≠)

Utilize bicaudal para detectar variações bilaterais (≠) ou unicaudal para direções pré-especificadas (< ou >).

Controle Deslizante Interativo2.45

Nota Metodológica e Boas Práticas Os testes de hipótese fornecem inferências probabilísticas sob premissas amostrais. Um valor-p não mede a probabilidade de a hipótese nula ser verdadeira nem substitui a avaliação do tamanho real do efeito.

Precisão Algébrica64 Bits Float (IEEE 754)
Latência de Resolução< 1 ms Local
Privacidade de Dados100% no Cliente

Processamento no Navegador

Cálculo de alta performance executado integralmente na memória local do navegador.

Zero Envio ao Servidor

Todos os dados permanecem estritamente locais, sem comunicação com servidores externos.

Exportação Pronta para Uso

Formatos padronizados e limpos, prontos para publicação e análise imediata.

Referência técnica e guia de arquitetura

Calculadora de Valor-p & Testes Z e t — Guia de referência

Calculadora de valor-p para testes Z, t de Student, qui-quadrado e F de Fisher. Obtenha significância uni e bicaudal, valores críticos e limites estatísticos.

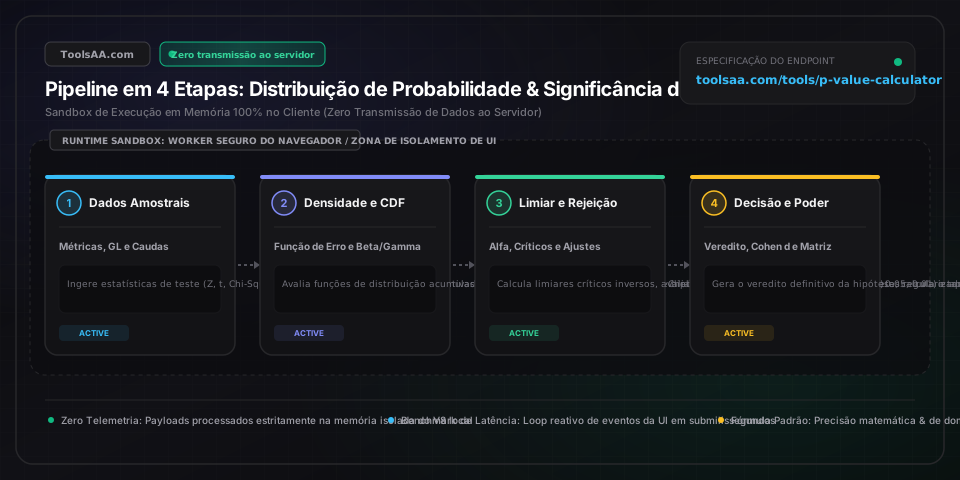
Calculadora de Valor-p & Testes Z e t — Guia de referência — Arquitetura em memória do lado do cliente e fluxo de dados

Parâmetros-chave e controles

Estatística de Teste Padronizada (Escore Z, t, Qui-Quadrado ou F)escore de discrepância padronizado (float real adimensional)

Medida normalizada de afastamento entre os dados amostrais e a hipótese nula H0. Segue uma distribuição normal padrão N(0,1) para testes Z em grandes amostras, t de Student para variância populacional desconhecida com gl = n - 1, qui-quadrado de Pearson para tabelas de contingência/aderência ou razão de variâncias para testes F.

Padrão: 2,450 (Métrica de Desvio Padrão / Escore t)
Graus de Liberdade (gl / df, df1 e df2)restrição de parâmetro discreto (inteiro positivo >= 1)

Número de observações ou valores independentes livres para variar no cômputo estatístico. Para testes t para uma amostra ou pareados, gl = n - 1; para testes t de duas amostras combinadas (pooled), gl = n1 + n2 - 2; para tabelas de contingência, gl = (linhas - 1)(colunas - 1); para ANOVA, gl1 entre grupos = k - 1 e gl2 dentro dos grupos = N - k.

Padrão: 28 (Tamanho Amostral n = 29 como Linha de Base)
Nível de Significância Alfa (α)limite de probabilidade de erro Tipo I (razão de 0,0001 a 0,2000)

Probabilidade máxima tolerada de cometer um erro do Tipo I (rejeitar falsamente uma hipótese nula verdadeira). As convenções científicas padrão fixam α = 0,05 (5% de risco de falso positivo, 95% de confiança), α = 0,01 em ensaios clínicos e farmacêuticos (Anvisa/FDA), ou α = 0,001 para descobertas em genômica e engenharia crítica.

Padrão: 0,050 (Limiar Convencional de 95% de Confiança)
Direcionalidade da Hipótese (Unicaudal vs Bicaudal)enum de hipótese alternativa direcional (À Esquerda, À Direita, Bicaudal)

Determina a cobertura das caudas da distribuição de probabilidades. Testes bicaudais (H1: μ ≠ μ0) avaliam desvios em ambas as direções, alocando α/2 para cada cauda. Testes unicaudais (Cauda Esquerda: H1: μ < μ0, Cauda Direita: H1: μ > μ0) concentram toda a área de rejeição α em uma única cauda, proporcionando maior poder estatístico, porém sendo cegos a variações no sentido oposto.

Padrão: Bicaudal (Padrão Bilateral H1: μ ≠ μ0)
Valor-p Calculado (p-valor)integral da densidade de probabilidade na cauda (razão de 0,00000 a 1,00000)

Probabilidade exata, sob a hipótese nula, de obter uma estatística de teste pelo menos tão extrema quanto o valor amostral observado: p = P(T >= |t_obs| | H0) * 2 para testes bicaudais. Se p < α, os dados fornecem evidência suficiente para rejeitar H0; se p >= α, não há evidência estatística para rejeitar H0.

Padrão: 0,0184 (Estatisticamente Significativo a α = 0,05)
Tamanho de Efeito Padronizado (d de Cohen / r de Pearson / Eta-Quadrado)métrica de magnitude prática (diferença média padronizada)

Mede a magnitude absoluta de um efeito experimental independentemente do tamanho da amostra: d de Cohen = (média1 - média2) / s_combinado. Limiares de referência clássicos: d = 0,20 (pequeno), d = 0,50 (médio), d = 0,80 (grande). Evita confundir valores-p diminutos gerados por grandes volumes amostrais (N massivo) com relevância prática no mundo real.

Padrão: 0,650 (Impacto Prático Médio a Alto)
Dicas profissionais e melhores práticas

Nunca Confunda Significância Estatística (p < 0,05) com Relevância Prática do Efeito

Em amostras massivas (como N = 100.000 em testes A/B no comércio eletrônico ou em produtos digitais), discrepâncias microscópicas e economicamente nulas — como uma oscilação de 0,001% na taxa de conversão — geram p < 0,0001. Um valor-p diminuto atesta apenas que a diferença observada dificilmente ocorreu por acaso amostral, e não que sua magnitude tenha relevância prática. Sempre reporte o d de Cohen, Risco Relativo ou intervalos de confiança na escala natural da métrica em conjunto com o valor-p.

Defina a Direcionalidade Previamente para Evitar o p-Hacking Unicaudal

Modificar um teste de bicaudal para unicaudal após inspecionar os dados reduz o valor-p exatamente pela metade (por exemplo, p = 0,08 torna-se p = 0,04), forçando artificialmente resultados marginais a ingressarem na zona de 'significância estatística'. Órgãos reguladores como Anvisa, FDA e periódicos científicos de alto impacto exigem que testes unicaudais sejam registrados no protocolo inicial da pesquisa, acompanhados de justificativa biológica, física ou empírica rigorosa.

Aplique Correções de Bonferroni ou FDR ao Avaliar Múltiplos Desfechos

Ao realizar múltiplos testes estatísticos simultâneos (como monitorar 20 métricas secundárias em um experimento ou 1.000 marcadores genéticos em estudos GWAS), a taxa global de erro Tipo I se propaga pela fórmula FWER = 1 - (1 - alfa)^k. Em k = 20 testes com alfa = 0,05, a chance de registrar ao menos um falso positivo sobe para 64,2%. Divida o limiar de significância pelo total de comparações (Bonferroni: alfa_ajustado = 0,05 / 20 = 0,0025) ou adote o método de Benjamini-Hochberg para controlar a Taxa de Falsas Descobertas (FDR).

Prefira o Teste t de Welch ao de Student para se Proteger contra a Heterocedasticidade

O teste t clássico de Student para duas amostras presume variâncias populacionais homogêneas (homocedasticidade). Quando os grupos possuem tamanhos desiguais (por exemplo, n1 = 100 e n2 = 30) e as variâncias diferem em mais de 2:1, o teste de Student pode inflar o erro Tipo I em até 15% ou arruinar o poder estatístico. O teste t de Welch, munido da aproximação de Satterthwaite para os graus de liberdade, compensa automaticamente variâncias heterogêneas sem qualquer penalidade caso elas sejam iguais.

Armadilhas comuns e solução de problemas

⚠️O valor-p calculado aparece como 0,0000 ou p < 0,0001 em vez de um decimal exato

Quando as estatísticas de teste atingem valores extremos (como Z > 4,5 ou t > 5,0 com elevado gl), a probabilidade na cauda cai para menos de 0,00001 (probabilidade inferior a 1 em 100.000). As diretrizes da APA e da ABNT preconizam reportar tais valores como 'p < 0,001' ou utilizar notação científica (ex.: 2,34e-6) em vez de arredondar para zero absoluto, uma vez que as caudas das distribuições normal e t são assintóticas e jamais tocam o zero estrito.

⚠️O valor-p unicaudal é superior a 0,500 apesar de uma estatística de teste absoluta elevada

Isso acontece quando a direção do efeito observado na amostra é contrária à formulada na hipótese alternativa direcional (por exemplo, ao testar H1: μ > 0 obtendo-se um escore amostral Z = -2,10). A probabilidade da cauda superior direita passa a ser 1 - P(Z < -2,10) = 0,9821. Quando o resultado contradiz o sentido esperado a priori, a hipótese nula não pode ser rejeitada; é vedado inverter o sinal da hipótese a posteriori para forçar significância.

⚠️O teste de Qui-Quadrado ou teste F apresenta uma opção de cauda incompatível

Diferente das distribuições simétricas normal e t de Student — que aceitam avaliações bilaterais ou unilaterais à esquerda —, os testes de Qui-Quadrado de aderência/contingência e o teste F de Fisher (ANOVA) são testes omnibus estritamente unicaudais à direita. Como desvios quadráticos e razões de variância são limitados inferiormente em zero, discrepâncias extremas posicionam-se unicamente na cauda superior direita. Testes bicaudais não possuem fundamento matemático no qui-quadrado e na ANOVA convencionais.

⚠️Divergência entre o valor-p do teste t de duas amostras e o da inclinação da regressão

Em uma regressão linear simples com variável dummy binária de tratamento, a estatística t do coeficiente angular coincide com o teste t de Student combinado (pooled): t² = F. Caso identifique divergências, certifique-se de que o teste t não foi executado com a correção de Welch (variâncias desiguais) enquanto o modelo MQO (OLS) utilizou homocedasticidade padrão, ou se foram ativados erros padrão robustos (como HC1 ou HC3 de White) na regressão.

Perguntas frequentes (FAQ)

Como calcular o valor-p a partir de um escore Z ou escore t?▼

Para calcular o valor-p, integra-se a função densidade de probabilidade da distribuição a partir da estatística de teste observada até o infinito. Na distribuição normal padrão, utiliza-se a função de distribuição acumulada Φ(z): para um teste bicaudal, p = 2 * (1 - Φ(|z|)). Por exemplo, para Z = 1,96, tem-se Φ(1,96) = 0,9750, resultando em p = 2 * (1 - 0,9750) = 0,0500. Para a distribuição t de Student com gl graus de liberdade, calcula-se a função beta incompleta regularizada: p = I_{gl/(gl + t²)}(gl/2, 1/2).

Qual é considerado um bom valor-p para comprovar significância estatística?▼

Um valor-p inferior a 0,05 (p < 0,05) é a referência científica consagrada para significância estatística, indicando menos de 5% de probabilidade de que os resultados observados decorram apenas de flutuação amostral sob a hipótese nula. Áreas de alta precisão impõem exigências mais estritas: ensaios clínicos regulatórios (Anvisa, FDA, EMA) exigem comumente p < 0,01 ou p < 0,001 com controle de multiplicidade, estudos genômicos de larga escala (GWAS) demandam p < 5 × 10⁻⁸ para mitigar falsos positivos, e a física de partículas exige o critério 5-sigma (p < 3 × 10⁻⁷) para confirmação de descobertas.

Qual é a diferença exata entre um valor-p unicaudal e bicaudal?▼

O valor-p bicaudal avalia se existe efeito em qualquer uma das direções (positivo ou negativo, H1: μ ≠ μ0), dividindo o nível de significância igualmente entre ambas as extremidades da distribuição (α/2 = 0,025 em cada cauda). O valor-p unicaudal investiga uma direção exclusiva definida a priori (H1: μ > μ0 ou H1: μ < μ0), concentrando o alfa total (α = 0,05) em uma única cauda. Para distribuições simétricas Z e t com a mesma estatística de teste no sentido correto, o valor-p bicaudal corresponde exatamente ao dobro do valor-p unicaudal.

Um valor-p alto comprova que a hipótese nula é verdadeira?▼

Não. Um valor-p elevado (p ≥ 0,05) não demonstra que a hipótese nula seja verdadeira; ele apenas evidencia que a amostra coletada não apresentou dados suficientes para rejeitá-la (ausência de evidência não constitui evidência de ausência). Valores-p elevados decorrem frequentemente de baixo poder estatístico ou amostras reduzidas (erro do Tipo II), em que existe uma diferença real na população, mas o tamanho amostral N foi insuficiente para captá-la.

Como encontrar o valor crítico a partir do nível de significância alfa?▼

O valor crítico é obtido aplicando a função inversa da distribuição acumulada (função quantil) correspondente à distribuição e aos graus de liberdade empregados. Na distribuição normal padrão para um teste bicaudal com α = 0,05, avalia-se o quantil 1 - (α / 2) = 0,975: Z* = Φ⁻¹(0,975) = 1,95996 (arredondado para 1,96). Na distribuição t de Student com gl = 20 a α = 0,05 bicaudal, t* = t⁻¹(0,975; 20) = 2,086. Toda estatística amostral que ultrapasse esse patamar crítico resulta em p < α.

Qual é a relação entre o valor-p e os intervalos de confiança de 95%?▼

Um teste de hipótese bicaudal ao nível α = 0,05 é matematicamente equivalente a avaliar se o valor estipulado pela hipótese nula pertence ao intervalo de confiança de 95% (IC = 1 - α). Se o intervalo de confiança de 95% para uma diferença média de tratamento [0,42; 3,18] não contiver o zero (o valor nulo), o valor-p bicaudal será necessariamente inferior a 0,05. Caso o intervalo englobe o zero (por exemplo, [-0,35; 2,10]), o valor-p será impreterivelmente maior ou igual a 0,05.

Ferramentas e utilitários relacionados

Todas as ferramentas →