/
Calculadora Valor P & Test de Hipótesis

Calculadora Valor P & Test de Hipótesis

Suite Estadística de Grado Científico

Calculadora de valor p para contrastes Z, t de Student, Chi-cuadrado y F de Fisher. Calcula significancia unilateral y bilateral, valores críticos y límites de decisión.

Casos de estudio predefinidos
Régimen científico y disciplina
2.450
58
0.05
Número de contrastes múltiples (k)Ajuste de Bonferroni (α / k) 0.05000
Veredicto del contraste de hipótesisRechazar H₀
Evidencia significativa (Rechazar H₀)
Valor p exacto0.01731.73e-2
Puntuación del estadístico de contraste2.450T (58 df)
Límite crítico de rechazo2.002α = 0.0500
Alfa nominal (α no ajustado)0.05k = 1

Interpretación estadística del resultado

Existe evidencia estadística suficiente para rechazar la hipótesis nula (H₀) a favor de la alternativa (H₁). La probabilidad de observar un resultado tan extremo bajo H₀ es menor que el umbral α preestablecido.

IC del 95%[0.490, 4.410]

Intervalo que contiene el parámetro poblacional verdadero con el nivel de confianza especificado.

Dirección del contrasteBilateral (Dos colas, ≠)

Seleccione contraste bilateral si la dirección del efecto no está predefinida; unilateral si se postula una dirección específica.

Control deslizante del estadístico2.45

Aviso de rigor metodológico La significancia estadística (p < 0,05) no garantiza relevancia práctica ni causalidad clínica. Evalúe siempre el tamaño del efecto (d de Cohen), los supuestos de distribución y predefina la hipótesis antes del análisis.

Precisión numérica< 1e-15 (Integración CDF)
Latencia de cálculo< 1 ms en memoria
Estándar de reporteAPA 7.ª ed. / FDA

Cálculo local en el cliente

Cálculos estadísticos de alto rendimiento ejecutados íntegramente en la memoria de su navegador.

Privacidad sin envío al servidor

Todos los datos y contrastes permanecen estrictamente locales con cero transmisión externa.

Exportación lista para publicación

Formatos estructurados y limpios (APA 7, LaTeX, CSV) listos para informes o despliegue inmediato.

Referencia técnica y guía de arquitectura

Calculadora Valor p & Test de Hipótesis — Guía de referencia

Calculadora de valor p para contrastes Z, t de Student, chi-cuadrado y F de Snedecor. Calcula significación unilateral y bilateral, valores críticos y potencia estadística.

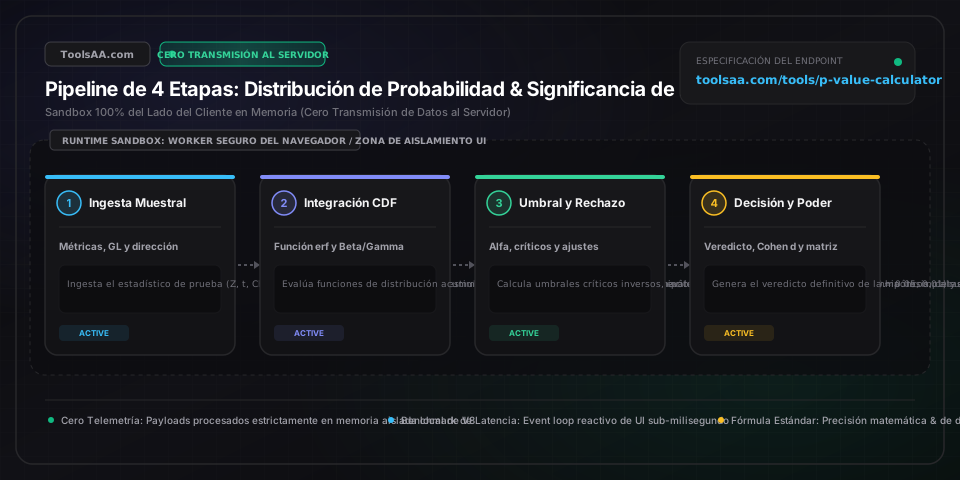
Calculadora Valor p & Test de Hipótesis — Guía de referencia — Arquitectura en memoria del lado del cliente y flujo de datos

Parámetros clave y controles

Estadístico de prueba estandarizado (Puntuación Z, t, Chi-cuadrado o F)puntuación de discrepancia estandarizada (flotante adimensional real)

Medida normalizada de desviación entre los datos muestrales y la hipótesis nula H0. Sigue una distribución normal estándar N(0,1) en pruebas Z de muestras grandes, t de Student para varianza poblacional desconocida con gl = n - 1, suma chi-cuadrado de Pearson para tablas de contingencia y bondad de ajuste, o razón de varianzas en contrastes F.

Por defecto: 2.450 (Métrica de desviación estándar / Puntuación t)
Grados de libertad (gl / df1 y df2)restricción de parámetro discreto (entero positivo >= 1)

Número de valores u observaciones independientes libres de variar en el cálculo estadístico. En pruebas t para una muestra o datos emparejados, gl = n - 1; en pruebas t de dos muestras independientes agrupadas, gl = n1 + n2 - 2; en tablas de contingencia, gl = (filas - 1)(columnas - 1); en ANOVA, gl1 intergrupal = k - 1 y gl2 intragrupal = N - k.

Por defecto: 28 (Línea base para muestra única n = 29)
Nivel de significación alfa (α)límite de probabilidad de error tipo I (proporción 0.0001 - 0.2000)

Probabilidad máxima aceptable de cometer un error tipo I (rechazar falsamente una hipótesis nula verdadera). Las convenciones científicas estándar fijan α = 0,05 (5 % de riesgo de falso positivo, 95 % de confianza), α = 0,01 en ensayos clínicos y farmacológicos, o α = 0,001 en genómica de alta resolución e ingeniería crítica.

Por defecto: 0.050 (Umbral estándar con 95 % de confianza)
Direccionalidad de la hipótesis (Unilateral vs. Bilateral)enumeración de hipótesis alternativa direccional (Izquierda, Derecha, Bilateral)

Determina la cobertura de las colas de la distribución de probabilidad. Los contrastes bilaterales de dos colas (H1: μ ≠ μ0) evalúan desviaciones en ambas direcciones, asignando α/2 a cada cola. Los contrastes unilaterales de una cola (izquierda: H1: μ < μ0, derecha: H1: μ > μ0) concentran toda la región de rechazo α en una sola cola, aportando mayor potencia estadística pero ciegos a efectos en sentido contrario.

Por defecto: Bilateral (Estándar bilateral H1: μ ≠ μ0)
Valor p calculado (p)integral de densidad de probabilidad de cola (proporción 0.00000 a 1.00000)

Probabilidad exacta bajo la hipótesis nula de obtener un estadístico de prueba al menos tan extremo como el valor muestral observado: p = P(T >= |t_obs| | H0) * 2 para contrastes bilaterales. Si p < α, los datos aportan evidencia suficiente para rechazar H0; si p >= α, no existe evidencia suficiente para rechazar H0.

Por defecto: 0.0184 (Estadísticamente significativo con α = 0,05)
Tamaño del efecto estandarizado (d de Cohen / r de Pearson / Eta cuadrado)métrica de magnitud práctica (diferencia de medias estandarizada)

Mide la magnitud absoluta de un efecto experimental de forma independiente al tamaño muestral: d de Cohen = (media1 - media2) / s_agrupada. Umbrales de referencia canónicos: d = 0,20 (pequeño), d = 0,50 (medio), d = 0,80 (grande). Evita confundir valores p minúsculos derivados de un tamaño muestral N masivo con una relevancia práctica real.

Por defecto: 0.650 (Impacto práctico medio-alto)
Consejos profesionales y mejores prácticas

No confundas la significación estadística (p < 0,05) con el tamaño del efecto práctico

Con tamaños de muestra masivos (como N = 100.000 en pruebas A/B de comercio electrónico), diferencias microscópicas e irrelevantes en términos de negocio —como una variación del 0,001 % en la conversión— generan un p < 0,0001. Un valor p diminuto únicamente demuestra que la diferencia observada difícilmente se debe al azar del muestreo, no que su impacto sea sustancial. Informa siempre de la d de Cohen, el riesgo relativo o los intervalos de confianza métricos brutos junto al valor p.

Define la direccionalidad antes del experimento para evitar el p-hacking unilateral

Cambiar de una prueba bilateral a una unilateral tras examinar los datos divide el valor p exactamente por la mitad (por ejemplo, de p = 0,08 a p = 0,04), forzando artificialmente resultados marginales a la categoría de 'significación estadística'. Organismos reguladores como la AEMPS, la EMA o la FDA, así como las revistas científicas de impacto, exigen registrar las hipótesis direccionales a priori con una estricta justificación teórica o experimental.

Aplica correcciones de Bonferroni o FDR al contrastar múltiples variables objetivo

Al ejecutar múltiples contrastes simultáneos (como evaluar 20 métricas en un test A/B o 1.000 variantes genéticas en estudios GWAS), la tasa de error global por familia de hipótesis se dispara según FWER = 1 - (1 - alpha)^k. Con k = 20 pruebas y alpha = 0,05, existe una probabilidad del 64,2 % de detectar al menos un falso positivo. Ajusta el umbral de significación dividiéndolo entre el número de comparaciones (Bonferroni: alpha_ajustado = 0,05 / 20 = 0,0025) o utiliza el procedimiento de tasa de falso descubrimiento (FDR) de Benjamini-Hochberg.

Prioriza la prueba t de Welch frente a la de Student para protegerte de la heterocedasticidad

La prueba t de Student clásica para dos muestras asume varianzas poblacionales homogéneas (homocedasticidad). Si los tamaños muestrales son desiguales (por ejemplo, n1 = 100, n2 = 30) y las varianzas difieren en una proporción superior a 2:1, la t de Student puede inflar la tasa de error tipo I hasta un 15 % o destruir la potencia estadística. La prueba t de Welch con corrección de grados de libertad de Satterthwaite ajusta automáticamente las varianzas dispares sin ninguna penalización de potencia cuando las varianzas son iguales.

Problemas comunes y soluciones

⚠️El valor p calculado se muestra como 0.0000 o p < 0,0001 en lugar de un decimal exacto

Cuando se obtienen estadísticos de prueba extremos (como Z > 4,5 o t > 5,0 con grados de libertad elevados), la probabilidad acumulada en la cola desciende por debajo de 0,00001 (menos de 1 en 100.000). Las directrices de estilo APA exigen reportar estos valores extremos como 'p < .001' o mediante notación científica (ej. 2.34e-6) en lugar de redondear a cero absoluto, ya que las colas asintóticas de las distribuciones normal y t de Student nunca alcanzan estrictamente el cero absoluto.

⚠️El valor p unilateral es superior a 0,500 a pesar de un estadístico de prueba absoluto elevado

Ocurre cuando el efecto muestral observado se encuentra en la dirección opuesta a la hipótesis alternativa direccional planteada (por ejemplo, contrastar H1: μ > 0 habiendo obtenido un estadístico negativo Z = -2,10). La probabilidad en la cola derecha es 1 - P(Z < -2,10) = 0,9821. Si el resultado empírico contradice la dirección formulada a priori, no es posible rechazar la hipótesis nula; nunca inviertas el signo a posteriori para forzar la significación estadística.

⚠️El valor p de la prueba Chi-cuadrado o F muestra opciones de cola inesperadas

A diferencia de las distribuciones simétricas normal y t de Student —que admiten contrastes bilaterales y unilaterales a izquierda o derecha—, la prueba de chi-cuadrado (bondad de ajuste/contingencia) y el contraste F de Fisher en ANOVA son intrínsecamente pruebas globales unilaterales de cola derecha. Debido a que las desviaciones al cuadrado y las razones de varianzas están estrictamente acotadas en cero, los estadísticos de discrepancia extrema se sitúan siempre en la cola superior derecha. Las opciones bilaterales carecen de validez matemática en pruebas estándar de chi-cuadrado y ANOVA.

⚠️Discrepancia entre el valor p de la prueba t para dos muestras y el valor p de la pendiente de regresión

En un modelo de regresión lineal simple con una variable ficticia (dummy) binaria de tratamiento, el estadístico t del coeficiente de la pendiente coincide exactamente con la prueba t de Student agrupada para dos muestras: t^2 = F. Si detectas discrepancias, comprueba si la prueba t aplicó la corrección de Welch (varianzas desiguales) mientras que la regresión MCO estándar asumió homocedasticidad en los residuos, o si se emplearon errores estándar robustos (HC1/HC3).

Preguntas frecuentes (FAQ)

¿Cómo se calcula un valor p a partir de una puntuación Z o una puntuación t?▼

Para calcular un valor p se integra la función de densidad de probabilidad de la distribución del contraste desde el estadístico observado hacia el extremo de la cola. En una distribución normal estándar, se evalúa la función de distribución acumulada Φ(z): para un contraste bilateral, p = 2 * (1 - Φ(|z|)). Por ejemplo, con Z = 1,96, Φ(1,96) = 0,9750, lo que arroja p = 2 * (1 - 0,9750) = 0,0500. Para una distribución t de Student con grados de libertad gl, se calcula mediante la función beta incompleta regularizada: p = I_{gl/(gl + t^2)}(gl/2, 1/2).

¿Qué valor p se considera adecuado para alcanzar significación estadística?▼

Un valor p inferior a 0,05 (p < 0,05) es el estándar de referencia convencional para la significación estadística en la investigación científica, lo que indica una probabilidad inferior al 5 % de que las diferencias observadas se deban al azar bajo la hipótesis nula. No obstante, diversas disciplinas exigen umbrales más rigurosos: los ensayos clínicos farmacológicos exigen con frecuencia p < 0,01 o p < 0,001 con ajustes por multiplicidad; los estudios de asociación del genoma completo (GWAS) imponen p < 5 × 10^-8 para evitar millones de falsos positivos, y la física de partículas exige 5 sigma (p < 3 × 10^-7) para confirmar un descubrimiento.

¿Cuál es la diferencia entre un valor p unilateral y uno bilateral?▼

Un valor p bilateral (dos colas) evalúa si existe un efecto en cualquier dirección (positivo o negativo, H1: μ ≠ μ0) dividiendo el umbral de significación alfa equitativamente entre ambas colas de la distribución (α/2 = 0,025 en cada una). Un valor p unilateral (una cola) comprueba la hipótesis en un único sentido predeterminado (H1: μ > μ0 o H1: μ < μ0), concentrando todo el umbral de significación (α = 0,05) en una sola cola. En distribuciones simétricas Z y t con el mismo estadístico muestral, el valor p bilateral es exactamente el doble del unilateral.

¿Un valor p alto demuestra que la hipótesis nula es verdadera?▼

No. Un valor p elevado (p ≥ 0,05) no demuestra que la hipótesis nula sea cierta; simplemente indica que los datos muestrales disponibles no aportan suficiente evidencia para rechazarla (la ausencia de evidencia no constituye evidencia de ausencia). Con frecuencia, un valor p alto es fruto de una potencia estadística insuficiente o un tamaño muestral reducido (error tipo II), donde existe un efecto real en la población pero el estudio carece del tamaño N necesario para detectarlo.

¿Cómo se obtiene el valor crítico a partir de un nivel de significación alfa?▼

Para hallar el valor crítico a partir de un nivel alfa, se evalúa la función inversa de distribución acumulada (función cuantil) de la distribución seleccionada y sus correspondientes grados de libertad. Para una distribución normal estándar con un contraste bilateral α = 0,05, se calcula el cuantil 1 - (α / 2) = 0,975: Z* = Φ^-1(0,975) = 1,95996 (redondeado a 1,96). Para una distribución t de Student con gl = 20 a dos colas con α = 0,05, t* = t^-1(0,975, 20) = 2,086. Cualquier estadístico de prueba observado que supere este umbral crítico resultará en un p < α.

¿Cuál es la relación entre los valores p y los intervalos de confianza del 95 %?▼

Un contraste de hipótesis bilateral con un nivel de significación α = 0,05 es matemáticamente equivalente a comprobar si el valor nulo de referencia queda contenido dentro del intervalo de confianza del 95 % (IC = 1 - α). Si el intervalo de confianza del 95 % para la diferencia de tratamientos [0,42; 3,18] no contiene el cero (valor nulo), el valor p bilateral será obligatoriamente menor que 0,05. Por el contrario, si el intervalo de confianza del 95 % incluye el cero (por ejemplo, [-0,35; 2,10]), el valor p será obligatoriamente mayor o igual a 0,05.

Herramientas y utilidades relacionadas

Todas las herramientas →