/
p-Wert-Rechner & Hypothesentest

p-Wert-Rechner & Hypothesentest

Wissenschaftlicher Standard

p-Wert-Rechner für Z-, t-, Chi-Quadrat- und F-Tests. Berechnen Sie ein- und zweiseitige Signifikanz, p-Werte, kritische Werte und inverse Testschwellen.

Schnellauswahl & Fallbeispiele
Forschungsdisziplin & Reporting-Standard
2.450
58
0.05
Anzahl multipler Tests (k)Bonferroni-Korrektur (α / k) 0.05000
Statistisches GesamtergebnisH₀ ablehnen (Statistisch signifikant)
Statistisch signifikant (H₀ ablehnen)
Exakter p-Wert0.01731.73e-2
Prüfgrößen-Wert (Teststatistik)2.450T (58 df)
Kritischer Schwellenwert2.002α = 0.0500
Nominales Alpha (α)0.05k = 1

Ergebnisinterpretation & Testentscheidung

Der beobachtete p-Wert liegt unter dem Signifikanzniveau α. Die Nullhypothese H₀ wird verworfen; der beobachtete Unterschied ist statistisch signifikant.

95% Konfidenzintervall[0.490, 4.410]

Zweiseitiges Konfidenzintervall (1 - α) für die geschätzte Parameterdifferenz.

Testrichtung (Ein- vs. Zweiseitig)Zweiseitig (Bilateral: H₁ ≠ 0)

Wählen Sie zweiseitig für ungerichtete Hypothesen oder einseitig bei theoretisch begründeter Wirkungsrichtung.

Interaktiver Prüfwert-Schieberegler2.45

Methodischer & Statistischer Hinweis Statistische Signifikanz (p < α) belegt die Unvereinbarkeit mit der Nullhypothese, impliziert aber nicht automatisch praktische Relevanz. Berücksichtigen Sie stets Effektstärke und Power.

Numerische PräzisionIEEE 754 64-Bit
TestverteilungenZ, t, χ², F (ANOVA)
Latenz & Sicherheit0 ms (100% Lokal)

Client-seitige Verarbeitung

Hochleistungsberechnung, die vollständig im Arbeitsspeicher des Browsers ausgeführt wird.

Kein Server-Upload & Datenschutz

Alle Daten verbleiben strikt lokal – ohne jegliche externe Serverkommunikation.

Produktionsreifer Export

Saubere, optimierte Ausgabeformate, sofort einsatzbereit für Publikation und Analyse.

Technische Referenz & Architektur-Leitfaden

p-Wert Rechner & Hypothesentest — Referenzhandbuch

p-Wert Rechner für Z-, t-, Chi-Quadrat- und F-Tests. Exakte Signifikanz einseitig & zweiseitig, kritische Werte und Hypothesentests online berechnen.

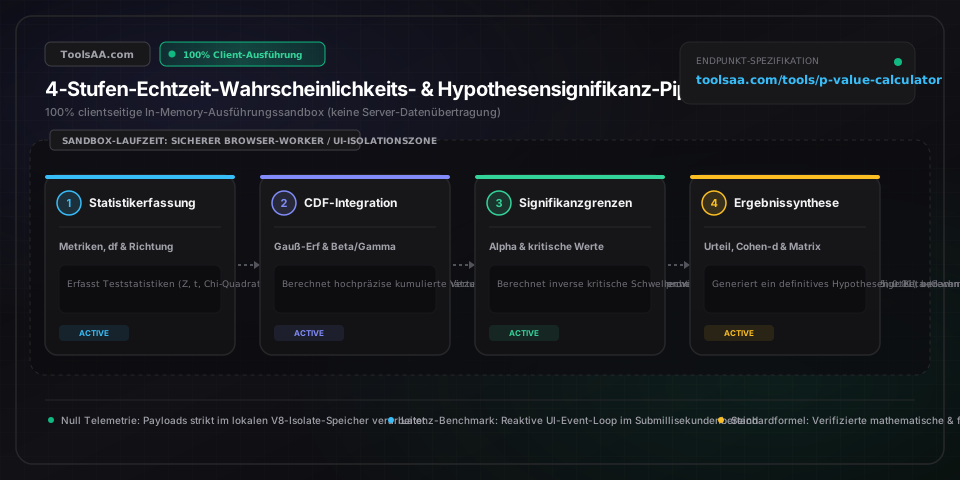
p-Wert Rechner & Hypothesentest — Referenzhandbuch — Client-seitige In-Memory-Architektur und Datenfluss

Wichtige Parameter & Einstellungen

Standardisierte Teststatistik (Z-, t-, Chi-Quadrat- oder F-Wert)Standardisierter Diskrepanzwert (dimensionslose reelle Zahl)

Normiertes Maß für die Abweichung zwischen den Stichprobendaten und der Nullhypothese H₀. Folgt einer Standardnormalverteilung N(0,1) bei Z-Tests für große Stichproben, einer Student-t-Verteilung bei unbekannter Populationsvarianz mit df = n - 1, einer Pearson-Chi-Quadrat-Summe für Kontingenz- und Anpassungstests oder einem Varianzquotienten bei F-Tests.

Standard: 2,450 (Standardabweichungsmetrik / t-Wert)
Freiheitsgrade (df / df1 & df2)Diskrete Parameterbeschränkung (ganze Zahl ≥ 1)

Anzahl der unabhängig frei wählbaren Werte oder Beobachtungen in einer statistischen Schätzung. Bei Ein-Stichproben- oder gepaarten t-Tests gilt df = n - 1; bei Zwei-Stichproben-t-Tests df = n₁ + n₂ - 2; bei Kontingenztafeln df = (Zeilen - 1)(Spalten - 1); bei der Varianzanalyse (ANOVA) gilt zwischen den Gruppen df₁ = k - 1 und innerhalb der Gruppen df₂ = N - k.

Standard: 28 (Stichprobenumfang n = 29 als Ein-Stichproben-Basis)
Signifikanzniveau Alpha (α)Grenze für Fehler-1.-Art-Wahrscheinlichkeit (Verhältnis 0,0001 – 0,2000)

Maximal tolerierte Wahrscheinlichkeit für einen Fehler 1. Art (irrtümliche Ablehnung einer wahren Nullhypothese). Wissenschaftlicher Standard ist α = 0,05 (5 % Risiko für falsch-positive Befunde, 95 % Konfidenz), α = 0,01 bei medizinischen und pharmazeutischen Studien oder α = 0,001 bei Genomforschung und hochpräziser Ingenieuranalytik.

Standard: 0,050 (Standard-Konfidenzschwelle 95 %)
Gerichtetheit der Hypothese (Einseitig vs. Zweiseitig)Enum für gerichtete Alternativhypothese (Linksseitig, Rechtsseitig, Zweiseitig)

Bestimmt die berücksichtigten Ränder der Wahrscheinlichkeitsverteilung. Zweiseitige Tests (H₁: μ ≠ μ₀) prüfen Abweichungen in beide Richtungen und verteilen jeweils α/2 auf beide Verteilungsenden. Einseitige Tests (Linksseitig: H₁: μ < μ₀, Rechtsseitig: H₁: μ > μ₀) legen den gesamten Ablehnungsbereich α in ein einzelnes Ende; dies steigert die statistische Teststärke, ignoriert jedoch gegenteilige Effekte vollständig.

Standard: Zweiseitig (Bilateraler Standard H₁: μ ≠ μ₀)
Berechneter p-Wert (p)Wahrscheinlichkeitsintegral des Verteilungsendes (0,00000 bis 1,00000)

Exakte Wahrscheinlichkeit, unter Annahme der Nullhypothese eine Teststatistik zu erhalten, die mindestens so extrem ist wie der beobachtete Stichprobenwert: p = P(T ≥ |t_obs| | H₀) · 2 bei zweiseitigen Tests. Ist p < α, liefert die Datenlage ausreichende Evidenz zur Ablehnung von H₀; ist p ≥ α, kann H₀ nicht verworfen werden.

Standard: 0,0184 (Statistisch signifikant bei α = 0,05)
Standardisierte Effektstärke (Cohen's d / Pearson r / Eta-Quadrat)Praktische Relevanzmetrik (standardisierte Mittelwertdifferenz)

Misst die absolute Stärke eines experimentellen Effekts unabhängig vom Stichprobenumfang: Cohen's d = (Mittelwert₁ - Mittelwert₂) / s_gepoolt. Übliche Richtwerte nach Cohen: d = 0,20 (kleiner Effekt), d = 0,50 (mittlerer Effekt), d = 0,80 (großer Effekt). Verhindert, dass extrem kleine p-Werte aus riesigen Stichproben N mit praktischer Relevanz verwechselt werden.

Standard: 0,650 (Mittlere bis hohe praktische Relevanz)
Profi-Tipps & Best Practices

Statistische Signifikanz (p < 0,05) niemals mit praktischer Relevanz verwechseln

Bei großen Stichprobenumfängen (z. B. N = 100.000 bei A/B-Tests im E-Commerce) führen selbst mikroskopische, wirtschaftlich irrelevante Unterschiede wie ein Anstieg der Conversion-Rate um 0,001 % zu p < 0,0001. Ein winziger p-Wert belegt lediglich, dass der Unterschied unwahrscheinlich auf reinem Zufallsrauschen beruht – nicht, dass er substanziell ist. Weisen Sie neben dem p-Wert stets Effektstärken wie Cohen's d, das relative Risiko oder Konfidenzintervalle der Rohmetriken aus.

Gerichtetheit vorab festlegen, um einseitiges p-Hacking zu unterbinden

Der nachträgliche Wechsel von einem zweiseitigen zu einem einseitigen Test nach Datensichtung halbiert den p-Wert exakt (z. B. wird aus p = 0,08 plötzlich p = 0,04), was grenzwertige Befunde künstlich unter die Signifikanzgrenze drückt. Aufsichtsbehörden wie die EMA und Fachjournale verlangen daher zwingend die Vorab-Registrierung gerichteter Hypothesen mit fundierter theoretischer oder mechanistischer Begründung.

Bonferroni- oder FDR-Korrektur bei multiplen Hypothesentests anwenden

Werden mehrere statistische Tests parallel gerechnet (z. B. 20 Zielmetriken in einem A/B-Test oder tausende Genvarianten in GWAS-Studien), kumuliert die familienbezogene Fehlerrate gemäß FWER = 1 - (1 - α)^k. Bei k = 20 Tests und α = 0,05 beträgt das Risiko für mindestens einen falsch-positiven Befund bereits 64,2 %. Passen Sie das Signifikanzniveau an (Bonferroni: α_adj = 0,05 / 20 = 0,0025) oder nutzen Sie das Benjamini-Hochberg-Verfahren zur Kontrolle der False Discovery Rate (FDR).

Welch-t-Test gegenüber klassischem Student-t-Test bei Heteroskedastizität bevorzugen

Der klassische Zwei-Stichproben-t-Test nach Student setzt Varianzhomogenität (Homoskedastizität) voraus. Bei ungleichen Gruppengrößen (z. B. n₁ = 100, n₂ = 30) und Varianzen im Verhältnis > 2:1 kann die Fehler-1.-Art-Rate auf über 15 % ansteigen oder die Teststärke drastisch einbrechen. Der Welch-t-Test mit Satterthwaite-Freiheitsgraden korrigiert ungleiche Varianzen automatisch und weist bei gleichen Varianzen keinerlei Nachteile bei der Teststärke auf.

Häufige Fehlerquellen & Fehlerbehebung

⚠️Berechneter p-Wert wird als 0,0000 oder p < 0,0001 statt als exakter Dezimalwert angezeigt

Bei extremen Prüfgrößen (wie Z > 4,5 oder t > 5,0 bei hohen Freiheitsgraden) fällt die Wahrscheinlichkeit im Verteilungsende unter 0,00001 (weniger als 1 zu 100.000). Wissenschaftliche Publikationsstandards (wie APA oder DGPs) schreiben vor, derartige Extremwerte als 'p < 0,001' oder in wissenschaftlicher Notation (z. B. 2,34e-6) auszuweisen, anstatt auf 0 abzurunden, da asymptotische Wahrscheinlichkeitsdichten mathematisch nie exakt Null erreichen.

⚠️Einseitiger p-Wert liegt über 0,500 trotz hohem Betrag der Teststatistik

Dies tritt auf, wenn der beobachtete Stichprobeneffekt der postulierten Alternativhypothese genau entgegengesetzt ist (z. B. Hypothese H₁: μ > 0 bei empirisch negativem Z = -2,10). Die rechtsseitige Wahrscheinlichkeit beträgt 1 - P(Z < -2,10) = 0,9821. Widerspricht das experimentelle Ergebnis der postulierten Richtung, darf die Nullhypothese keinesfalls verworfen werden; ein nachträgliches Umkehren des Vorzeichens zur Rettung der Signifikanz ist wissenschaftlich unzulässig.

⚠️Chi-Quadrat- oder F-Test bietet keine zweiseitige Auswertungsoption

Im Gegensatz zu den symmetrischen Normal- und Student-t-Verteilungen sind der Chi-Quadrat-Anpassungstest und der ANOVA-F-Test nach Fisher methodisch reine rechtsseitige Omnibus-Tests. Da quadrierte Abweichungen und Varianzquotienten nach unten durch Null begrenzt sind, liegen auffällige Abweichungen von der Nullhypothese ausnahmslos im oberen rechten Verteilungsende. Zweiseitige Berechnungen sind für standardmäßige Chi-Quadrat- und F-Tests mathematisch nicht definiert.

⚠️Abweichung zwischen dem p-Wert des Zwei-Stichproben-t-Tests und dem der Regressionssteigung

In einer einfachen linearen Regression mit einer binären Behandlungsvariablen (Dummy) entspricht die t-Statistik des Steigungskoeffizienten exakt dem klassischen Student-t-Test mit gepoolter Varianz (t² = F). Zeigen sich Diskrepanzen, prüfen Sie, ob der t-Test eine Welch-Korrektur (für ungleiche Varianzen) verwendet hat, während die lineare OLS-Regression von Homoskedastizität ausging, oder ob robuste Standardfehler (HC1/HC3) aktiviert waren.

Häufig gestellte Fragen (FAQ)

Wie berechnet man den p-Wert aus einem Z-Wert oder t-Wert?▼

Zur Berechnung des p-Werts wird die Wahrscheinlichkeitsdichtefunktion der Testverteilung von der beobachteten Prüfgröße bis unendlich integriert. Bei der Standardnormalverteilung nutzt man die Verteilungsfunktion Φ(z): Für einen zweiseitigen Test gilt p = 2 · (1 - Φ(|z|)). Bei Z = 1,96 ergibt sich beispielsweise Φ(1,96) = 0,9750 und damit p = 2 · (1 - 0,9750) = 0,0500. Für eine Student-t-Verteilung mit Freiheitsgraden df wird die regularisierte unvollständige Beta-Funktion ausgewertet: p = I_{df/(df + t²)}(df/2, 1/2).

Welcher p-Wert gilt als statistisch signifikant?▼

Ein p-Wert unter 0,05 (p < 0,05) gilt in der wissenschaftlichen Forschung als klassischer Standard für statistische Signifikanz. Er besagt, dass die Wahrscheinlichkeit für das Auftreten der beobachteten Daten unter der Nullhypothese unter 5 % liegt. Bestimmte Fachdisziplinen fordern jedoch strengere Schwellen: Klinische Zulassungsstudien verlangen häufig p < 0,01 oder p < 0,001 mit Adjustierung für multiples Testen, genomweite Assoziationsstudien (GWAS) setzen p < 5 × 10⁻⁸ an, um falsch-positive Treffer zu minimieren, und in der Teilchenphysik gilt die 5-Sigma-Regel (p < 3 × 10⁻⁷).

Was ist der Unterschied zwischen einem einseitigen und einem zweiseitigen p-Wert?▼

Ein zweiseitiger p-Wert prüft, ob ein Unterschied in beliebiger Richtung (positiv oder negativ, H₁: μ ≠ μ₀) vorliegt, indem das Signifikanzniveau α gleichmäßig auf beide Verteilungsenden aufgeteilt wird (jeweils α/2 = 0,025). Ein einseitiger p-Wert testet gezielt auf eine vorab definierte Richtung (H₁: μ > μ₀ oder H₁: μ < μ₀) und konzentriert das gesamte Signifikanzniveau (α = 0,05) auf eine Flanke. Bei symmetrischen Verteilungen (Z und t) ist der zweiseitige p-Wert bei gleicher Prüfgröße exakt doppelt so groß wie der einseitige p-Wert.

Bedeutet ein hoher p-Wert, dass die Nullhypothese wahr ist?▼

Nein, ein hoher p-Wert (p ≥ 0,05) beweist keineswegs, dass die Nullhypothese zutrifft. Er zeigt lediglich, dass die vorliegenden Stichprobendaten keine ausreichende statistische Evidenz liefern, um sie zu verwerfen („Fehlen von Evidenz ist kein Beweis für das Nichtvorhandensein eines Effekts“). Häufig resultiert ein hoher p-Wert aus unzureichender Teststärke (Power) oder zu kleinen Stichproben (Fehler 2. Art), wodurch ein real existierender Populationseffekt statistisch schlicht unentdeckt bleibt.

Wie bestimmt man den kritischen Wert aus dem Signifikanzniveau Alpha?▼

Der kritische Wert wird über die inverse Verteilungsfunktion (Quantilfunktion) der jeweiligen Prüfverteilung unter Berücksichtigung der Freiheitsgrade berechnet. Für eine Standardnormalverteilung bei zweiseitigem α = 0,05 berechnet man das (1 - α/2) = 0,975-Quantil: Z* = Φ⁻¹(0,975) = 1,95996 (gerundet 1,96). Für eine Student-t-Verteilung mit df = 20 bei zweiseitigem α = 0,05 ergibt sich t* = t⁻¹(0,975; 20) = 2,086. Jede empirische Teststatistik, deren Betrag diesen Schwellenwert übersteigt, führt zu p < α.

Wie hängen p-Werte und das 95-%-Konfidenzintervall zusammen?▼

Ein zweiseitiger Hypothesentest auf dem Signifikanzniveau α = 0,05 ist mathematisch äquivalent zur Prüfung, ob der hypothetische Nullwert innerhalb des 95-%-Konfidenzintervalls (KI = 1 - α) liegt. Schließt das 95-%-Konfidenzintervall einer Differenz [0,42; 3,18] die Null nicht ein, ist der zweiseitige p-Wert garantiert kleiner als 0,05. Überdeckt das Konfidenzintervall hingegen die Null (z. B. [-0,35; 2,10]), ist der p-Wert stets größer oder gleich 0,05.

Verwandte Tools & Hilfsprogramme

Alle Tools →