/
Calculateur P-Value & Test d'Hypothèse

Calculateur P-Value & Test d'Hypothèse

Statistiques inférentielles & biostatistique

Calculateur de p-value pour tests Z, t de Student, chi-carré (χ²) et F de Fisher. Déterminez la significativité bilatérale et unilatérale, les valeurs critiques et la taille d'effet.

Préréglages d'études & cas types
Cadre méthodologique & discipline
2.450
58
0.05
Nombre de comparaisons simultanées (k)Correction de Bonferroni (α / k) 0.05000
Conclusion du test d'hypothèseRejet de l'hypothèse nulle (H₀ rejetée)
Statistiquement significatif (Rejet H₀)
P-value exacte (valeur p)0.01731.73e-2
Valeur de la statistique de test2.450T (58 df)
Valeur critique seuil (frontière de rejet)2.002α = 0.0500
Seuil alpha nominal0.05k = 1

Interprétation & décision statistique

La p-value calculée est strictement inférieure au seuil de signification alpha (p < α). Les données fournissent une preuve empirique suffisante pour rejeter l'hypothèse nulle (H₀) au profit de l'hypothèse alternative (H₁).

Intervalle de confiance à 95 %[0.490, 4.410]

Plage de valeurs plausibles pour le paramètre de population au niveau de confiance spécifié (1 - α).

Direction du test d'hypothèseBilatéral (H₁ : paramètre ≠ 0)

Les tests bilatéraux répartissent le risque α sur les deux queues ; les tests unilatéraux concentrent tout le rejet sur une seule queue.

Ajustement continu de la statistique2.45

Note méthodologique & rigueur d'inférence statistique Avertissement : Les calculs de probabilité et de seuil de signification reposent sur des modèles continus idéaux (normalité, indépendance et échantillonnage aléatoire). L'obtention d'une p-value inférieure à 0,05 atteste d'une significativité statistique mais ne garantit pas à elle seule une pertinence clinique ou pratique. Il convient de vérifier systématiquement les hypothèses sous-jacentes (homoscédasticité, distributions résiduelles) et d'évaluer la taille d'effet conjointement aux intervalles de confiance.

Précision de calculNorme IEEE 754 (Double 64 bits)
Distributions continuesLois Z, t de Student, χ² et F de Fisher
Confidentialité locale100 % local (Zéro requête serveur)

Calcul instantané côté client

Calcul haute performance exécuté intégralement dans la mémoire de votre navigateur.

Confidentialité sans transfert serveur

Toutes les données restent strictement locales sans aucune communication avec un serveur externe.

Export prêt pour publication

Formats de synthèse propres et optimisés, prêts pour intégration immédiate en mémoire ou rapport.
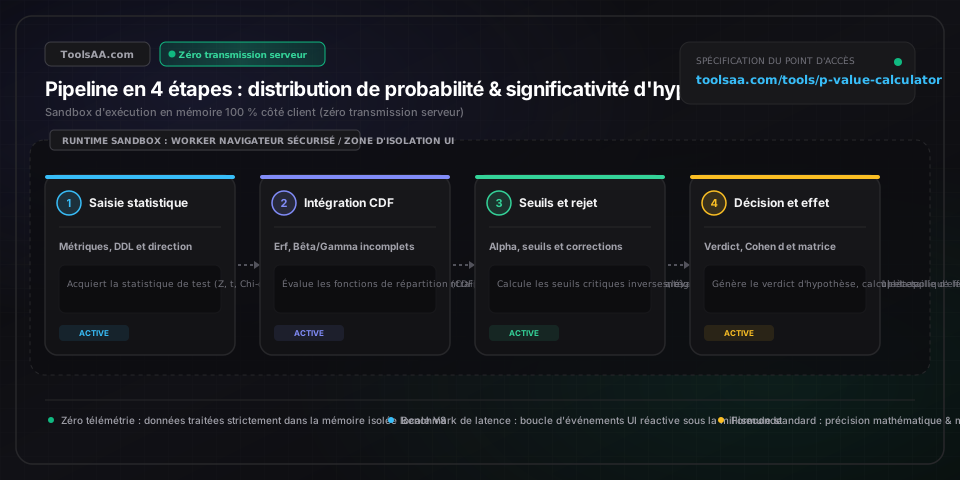
Référence technique et guide d'architecture

Calculateur p-value & Test d'hypothèse — Guide de référence

Calculateur de p-value pour tests Z, t de Student, Chi-carré et test F. Déterminez la significativité unilatérale et bilatérale, les valeurs critiques et la puissance.

Calculateur p-value & Test d'hypothèse — Guide de référence — Architecture en mémoire côté client et flux de données

Paramètres clés et contrôles

Statistique de test standardisée (score Z, t, Chi-carré ou F)score d'écart standardisé (flottant réel sans dimension)

Mesure normalisée de l'écart entre les données de l'échantillon et l'hypothèse nulle H0. Suit une loi normale centrée réduite N(0,1) pour les grands échantillons (test Z), une loi de Student pour une variance inconnue avec ddl = n - 1, une somme du Chi-carré de Pearson pour les tables de contingence ou un rapport de variance pour les tests F (ANOVA).

Par défaut : 2,450 (Métrique d'écart-type / Score t)
Degrés de liberté (ddl / ddl1 & ddl2)contrainte paramétrique discrète (entier positif >= 1)

Nombre de valeurs ou d'observations indépendantes libres de varier dans le calcul statistique. Pour un test t à échantillon unique ou apparié, ddl = n - 1 ; pour un test t à deux échantillons indépendants, ddl = n1 + n2 - 2 ; pour un tableau de contingence, ddl = (lignes - 1)(colonnes - 1) ; pour une ANOVA, ddl1 inter-groupes = k - 1 et ddl2 intra-groupes = N - k.

Par défaut : 28 (Taille d'échantillon n = 29 de référence)
Seuil de significativité Alpha (α)limite de probabilité d'erreur de type I (ratio 0,0001 - 0,2000)

Probabilité maximale acceptable de commettre une erreur de première espèce (rejeter à tort une hypothèse nulle H0 vraie). Les conventions scientifiques standard imposent α = 0,05 (risque de faux positif de 5 %, confiance de 95 %), α = 0,01 dans les essais cliniques et biomédicaux (ANSM/EMA), ou α = 0,001 en génomique et ingénierie de pointe.

Par défaut : 0,050 (Seuil standard à 95 % de confiance)
Directionnalité de l'hypothèse (Unilatérale vs Bilatérale)énumération d'hypothèse alternative directionnelle (Gauche, Droite, Bilatérale)

Détermine la zone de rejet dans les queues de la distribution de probabilité. Les tests bilatéraux (H1 : μ ≠ μ0) évaluent les écarts dans les deux sens en allouant α/2 à chaque extrémité. Les tests unilatéraux (Gauche : H1 : μ < μ0, Droite : H1 : μ > μ0) concentrent la totalité du seuil α dans une seule queue, offrant une plus grande puissance statistique mais restant aveugles aux effets inverses.

Par défaut : Bilatérale (Standard bilatéral H1 : μ ≠ μ0)
P-value calculée (p)intégrale de densité de probabilité de queue (ratio 0,00000 à 1,00000)

Probabilité exacte, sous l'hypothèse nulle H0, d'obtenir une statistique de test au moins aussi extrême que la valeur observée dans l'échantillon : p = P(T >= |t_obs| | H0) * 2 pour un test bilatéral. Si p < α, les données apportent une preuve suffisante pour rejeter H0 ; si p >= α, on ne peut pas rejeter H0.

Par défaut : 0,0184 (Statistiquement significatif à α = 0,05)
Taille d'effet standardisée (d de Cohen / r de Pearson / Eta-carré)métrique d'amplitude pratique (différence moyenne standardisée)

Mesure l'amplitude absolue d'un effet expérimental indépendamment de la taille de l'échantillon : d de Cohen = (moyenne1 - moyenne2) / s_agrégé. Repères conventionnels : d = 0,20 (faible), d = 0,50 (moyen), d = 0,80 (fort). Évite de confondre une p-value minuscule issue d'un effectif massif N avec une réelle importance clinique ou pratique.

Par défaut : 0,650 (Impact pratique modéré à élevé)

Conseils de pro et bonnes pratiques

Ne confondez jamais significativité statistique (p < 0,05) et pertinence pratique de l'effet

Avec des échantillons massifs (par exemple N = 100 000 dans un test A/B e-commerce), une variation microscopique et économiquement négligeable de 0,001 % de taux de conversion peut produire un p < 0,0001. Une faible p-value prouve uniquement que la différence observée est peu susceptible d'être due au hasard d'échantillonnage, non qu'elle a un impact réel. Publiez systématiquement le d de Cohen, le risque relatif ou l'intervalle de confiance des métriques brutes aux côtés de la p-value.

Fixez la directionnalité a priori pour proscrire le p-hacking unilatéral

Basculer d'un test bilatéral à un test unilatéral après avoir examiné les données divise votre p-value exactement par deux (par exemple, p = 0,08 devient p = 0,04), transformant artificiellement un résultat marginal en « succès statistiquement significatif ». Les comités d'éthique, l'ANSM, l'EMA et les revues scientifiques à comité de lecture exigent que toute hypothèse unilatérale soit enregistrée au préalable dans un protocole avec une justification biologique ou physique rigoureuse.

Appliquez une correction de Bonferroni ou FDR lors de tests d'hypothèses multiples

Lors de tests statistiques simultanés (par exemple 20 indicateurs dans un test A/B ou 1 000 variants génétiques dans une étude GWAS), le taux global d'erreur de type I s'envole selon la formule FWER = 1 - (1 - α)^k. À k = 20 tests avec α = 0,05, vous avez 64,2 % de chances de détecter au moins un faux positif. Divisez votre seuil par le nombre de comparaisons (Bonferroni : α_ajusté = 0,05 / 20 = 0,0025) ou appliquez la procédure FDR de Benjamini-Hochberg.

Privilégiez le test t de Welch au test de Student classique face à l'hétéroscédasticité

Le test t de Student classique suppose l'égalité des variances (homoscédasticité). Si les tailles d'échantillons sont inégales (ex. n1 = 100, n2 = 30) et que le ratio des variances dépasse 2:1, le test de Student peut gonfler le taux d'erreur de première espèce jusqu'à 15 % ou effondrer la puissance. Le test t de Welch avec approximation des degrés de liberté de Satterthwaite s'ajuste automatiquement aux variances inégales sans aucune pénalité de puissance si les variances sont égales.

Pièges courants et dépannage

⚠️La p-value calculée affiche 0,0000 ou p < 0,0001 au lieu d'un nombre décimal exact

Lorsque la statistique de test est extrême (comme Z > 4,5 ou t > 5,0 avec un ddl élevé), la probabilité de queue chute sous 0,00001 (moins de 1 sur 100 000). Les normes APA et les standards biomédicaux prescrivent de rapporter ces valeurs sous la forme « p < 0,001 » ou en notation scientifique (ex. 2,34e-6) plutôt que de les arrondir à un zéro absolu, car les queues asymptotiques des lois normales et de Student ne s'annulent jamais strictement.

⚠️La p-value unilatérale dépasse 0,500 malgré une statistique de test élevée en valeur absolue

Cette situation survient lorsque l'effet observé dans votre échantillon est orienté dans le sens opposé à votre hypothèse alternative (par exemple, tester H1 : μ > 0 avec une statistique observée négative Z = -2,10). La probabilité de queue droite est alors 1 - P(Z < -2,10) = 0,9821. Si votre résultat expérimental contredit la direction postulée, l'hypothèse nulle ne peut être rejetée ; il est scientifiquement proscrit d'inverser le signe a posteriori pour sauver la significativité.

⚠️Le test du Chi-carré ou le test F propose une option de queue inattendue

Contrairement aux distributions symétriques normale et de Student qui acceptent des zones de rejet à gauche, à droite ou bilatérales, le test d'adéquation/contingence du Chi-carré et le test F de Fisher (ANOVA) sont fondamentalement des tests globaux unilatéraux à droite. Les écarts au carré et les rapports de variance étant strictement positifs ou nuls, les statistiques extrêmes se situent obligatoirement dans la queue supérieure droite. Une option bilatérale est mathématiquement invalide pour ces tests.

⚠️Écart entre la p-value d'un test t à deux échantillons et celle du coefficient de régression

Dans une régression linéaire simple avec une variable muette binaire (traitement vs contrôle), la statistique t de la pente correspond exactement au test t de Student pour échantillons indépendants : t^2 = F. Si vous constatez un écart, vérifiez si votre test t utilise la correction de Welch (variances inégales) tandis que la régression MCO suppose des résidus homoscédastiques, ou si des erreurs-types robustes (HC1/HC3) ont été injectées dans le modèle de régression.

Foire aux questions (FAQ)

Comment calculer une p-value à partir d'un score Z ou d'un score t ?▼

Pour calculer une p-value, on intègre la fonction de densité de probabilité de la loi concernée depuis la statistique observée jusqu'à l'infini. Pour une loi normale centrée réduite, on utilise la fonction de répartition Φ(z) : pour un test bilatéral, p = 2 * (1 - Φ(|z|)). Par exemple, avec Z = 1,96, Φ(1,96) = 0,9750, d'où p = 2 * (1 - 0,9750) = 0,0500. Pour une loi de Student à ddl degrés de liberté, on évalue la fonction bêta incomplète régularisée : p = I_{ddl / (ddl + t^2)}(ddl/2, 1/2).

Qu'est-ce qu'une bonne p-value pour conclure à la significativité statistique ?▼

Une p-value inférieure à 0,05 (p < 0,05) constitue le seuil conventionnel de référence dans la recherche scientifique, indiquant moins de 5 % de probabilité d'observer de telles données sous l'hypothèse nulle. Toutefois, certains domaines appliquent des exigences plus strictes : les essais cliniques (validés par l'ANSM ou l'EMA) exigent souvent p < 0,01 ou p < 0,001 avec ajustement pour multiplicité, les études d'association pangénomique (GWAS) imposent p < 5 × 10^-8 pour filtrer des millions de faux positifs, et la physique des particules requiert 5 sigmas (p < 3 × 10^-7) pour valider une découverte.

Quelle est la différence entre une p-value unilatérale et bilatérale ?▼

Une p-value bilatérale vérifie si un effet existe dans un sens ou dans l'autre (positif ou négatif, H1 : μ ≠ μ0) en répartissant équitablement le seuil alpha entre les deux queues de distribution (α/2 = 0,025 chacune). Une p-value unilatérale teste une direction prédéterminée (H1 : μ > μ0 ou H1 : μ < μ0) en concentrant la totalité du seuil alpha (α = 0,05) dans une seule queue. Pour les distributions symétriques Z et t avec une même statistique observée, la p-value bilatérale est exactement le double de la p-value unilatérale.

Une p-value élevée signifie-t-elle que l'hypothèse nulle est vraie ?▼

Non, une p-value élevée (p ≥ 0,05) ne prouve absolument pas que l'hypothèse nulle est vraie ; elle indique simplement que l'échantillon observé n'apporte pas de preuves suffisantes pour la rejeter (« l'absence de preuve n'est pas une preuve d'absence »). Une p-value élevée découle fréquemment d'un manque de puissance statistique ou d'un effectif trop restreint (erreur de type II), où un effet réel existe dans la population sans que l'étude n'ait la puissance N nécessaire pour le détecter.

Comment déterminer la valeur critique à partir du niveau alpha ?▼

Pour trouver la valeur critique associée à un seuil alpha, on évalue la fonction quantile (inverse de la fonction de répartition) de la loi choisie pour les degrés de liberté donnés. Pour une loi normale standard avec un test bilatéral à α = 0,05, on calcule le quantile 1 - (α / 2) = 0,975 : Z* = Φ^-1(0,975) = 1,95996 (arrondi à 1,96). Pour une loi de Student à ddl = 20 au seuil bilatéral α = 0,05, t* = t^-1(0,975, 20) = 2,086. Toute statistique de test observée dépassant ce seuil critique conduit à p < α.

Quel est le lien entre les p-values et les intervalles de confiance à 95 % ?▼

Un test d'hypothèse bilatéral au niveau de significativité α = 0,05 est mathématiquement équivalent à vérifier si la valeur postulée sous H0 est incluse dans l'intervalle de confiance à 95 % (IC = 1 - α). Si l'intervalle de confiance à 95 % d'une différence de traitement [0,42 ; 3,18] ne contient pas zéro (la valeur nulle), la p-value bilatérale est obligatoirement inférieure à 0,05. À l'inverse, si l'intervalle englobe zéro (par exemple [-0,35 ; 2,10]), la p-value est obligatoirement supérieure ou égale à 0,05.

Outils et utilitaires connexes

Tous les outils →