Calculadora de Desviación Estándar

Calculadora de Desviación & Varianza

Calcula al instante la desviación estándar muestral y poblacional, varianza, media y margen de error. Limpieza de datos con detección de atípicos y curva normal.

Preajustes:
Panel de control y entrada de datos
30 Puntos numéricos válidos
Régimen de cálculo (Grados de libertad)
Nivel de confianza estadística
Tratamiento de valores atípicos
Multiplicador de Tukey (k × IQR)1.5x IQR
Sensible (1.0 × IQR)Estándar (1.5 × IQR)Extremo (3.0 × IQR)
Corrección de Bessel (n - 1)

La corrección de Bessel divide entre (n - 1) en lugar de n para eliminar el sesgo de subestimación al calcular la varianza poblacional desde una muestra.

En métricas de salud, ritmo de carrera o variabilidad cardíaca, una desviación estándar baja refleja consistencia sólida, mientras que una alta señala fluctuaciones notables.

Desviación estándar muestral (s)n - 1
7.9997
Varianza muestral (s²): 63.9954
Desviación estándar poblacional (σ)N
7.8653
Varianza poblacional (σ²): 61.8622
Media aritmética (x̄)Σx / n
82.9333
Suma (Σx): 2,488 (n = 30)
Error estándar (SE)1.4605
Coeficiente de variación (CV)9.65%
Mediana (Q2)83.5
Rango intercuartílico (IQR)12
Intervalo de confianza de la media (95%)x̄ ± 2.9868 (t* = 2.045)
[79.9465to85.9201]
Asimetría (Skewness)-0.21Approximately Symmetrical
Curtosis (Kurtosis)-0.906Platykurtic (Light tails)
Total de observaciones (n)30
Media aritmética (x̄)82.9333
Desviación estándar muestral (s)7.9997
Error estándar (SE)1.4605
Mediana (Q2)83.5
Margen de error (±E)±2.9868
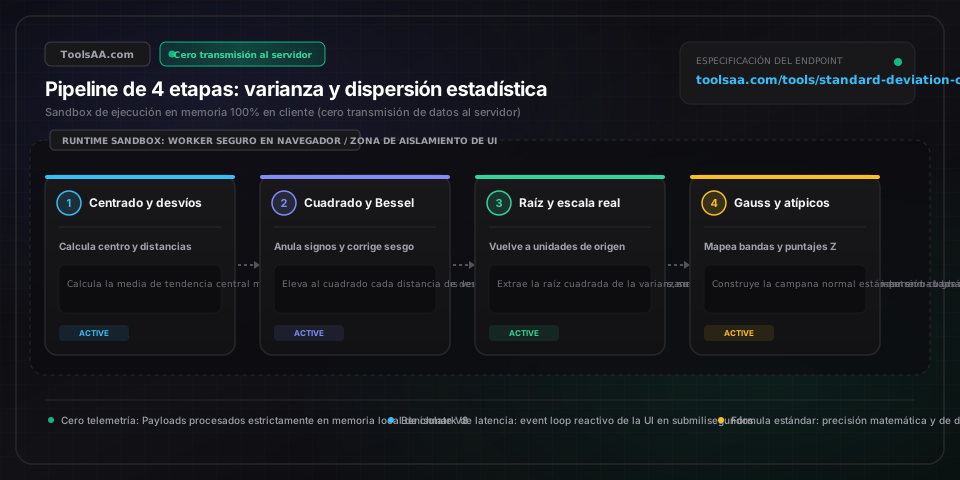
Referencia técnica y guía de arquitectura

Calculadora de Desviación Estándar — Guía de referencia

Calcula al instante la desviación estándar muestral y poblacional, varianza, media y margen de error. Depura datos con detección de atípicos y curva normal.

Calculadora de Desviación Estándar — Guía de referencia — Arquitectura en memoria del lado del cliente y flujo de datos

Parámetros clave y controles

Desviación estándar muestral (s)Estimador de dispersión estadística

Mide la variabilidad en torno a la media muestral aplicando la corrección de Bessel (división entre n - 1). Este ajuste previene la subestimación de la dispersión real al analizar subconjuntos o muestras, como los tiempos por kilómetro de un corredor en un 5K semanal, las calificaciones semestrales de un estudiante o el gasto mensual en la cesta de la compra familiar.

Por defecto: Insesgado (n - 1) grados de libertad
Desviación estándar poblacional (σ)Constante de dispersión paramétrica

Cuantifica la dispersión real de un colectivo cerrado dividiendo la suma de desviaciones al cuadrado entre N. Solo es estrictamente válida cuando se mide la totalidad de los elementos del universo definido sin recurrir a estimaciones, como los 30 alumnos de una clase específica, las 12 facturas de la luz de un año natural o cada latido registrado durante una carrera completada.

Por defecto: Parámetro exacto (N grados de libertad)
Varianza muestral (s²)Métrica de desviación cuadrática media

Promedio de las distancias al cuadrado de cada observación respecto a la media aritmética, expresado en unidades al cuadrado (como segundos² o puntos²). Aunque resulta menos intuitiva para planificar ritmos diarios o presupuestos que la desviación estándar, la varianza constituye el motor aditivo fundamental para comparar la consistencia de grupos en el rendimiento deportivo y académico.

Por defecto: Suma de desviaciones al cuadrado / (n - 1)
Error estándar de la media (SE)Indicador de precisión muestral

Mide la precisión con la que el promedio de la muestra representa la media poblacional real, calculado como s / √n. Mientras que la desviación estándar refleja la dispersión natural entre observaciones individuales (como la frecuencia cardíaca en reposo diaria), el error estándar indica la fiabilidad del promedio global, reduciéndose a medida que registras más entrenamientos o ensayos clínicos.

Por defecto: Índice de precisión s / √n
Coeficiente de variación (CV)Dispersión relativa normalizada

Cociente entre la desviación estándar y la media expresado en porcentaje: (s / Media) × 100%. Proporciona una referencia adimensional para comparar la regularidad entre escalas de magnitud muy dispares, como contrastar la variabilidad cardíaca en sueño profundo (media de 60 ppm, s = 3 ppm, CV = 5%) frente a series de esprints de alta intensidad (media de 170 ppm, s = 8,5 ppm, CV = 5%).

Por defecto: Ratio de volatilidad porcentual ((s / Media) × 100%)
Rango intercuartílico (IQR)Medida de dispersión no paramétrica

Diferencia entre el percentil 75 (Q3) y el percentil 25 (Q1), que delimita el 50% central de las observaciones. Al ser inmune a distorsiones extremas causadas por fallos puntuales del GPS, lecturas erróneas de sensores o gastos atípicos durante las vacaciones, constituye la referencia clínica y deportiva para detectar anomalías reales mediante los límites de Tukey (1,5 × IQR).

Por defecto: Rango del 50% central (Q3 - Q1)

Consejos profesionales y mejores prácticas

Cancelación catastrófica en fórmulas simplificadas

Evita emplear la fórmula abreviada simplificada (Σx² - (Σx)² / n) al analizar números con valores base elevados y escasa dispersión, como cotas altimétricas de GPS (1.842,1 m y 1.842,3 m) o marcas cronometradas de maratón. Restar dos cifras gigantescas casi idénticas provoca una pérdida catastrófica de precisión en los decimales. Calcula siempre primero la media muestral real, halla la desviación de cada punto individual y, a continuación, eleva dichas diferencias al cuadrado.

La falacia de la regla empírica en datos asimétricos

La clásica regla empírica 68-95-99,7% asume de forma estricta una distribución gaussiana simétrica en forma de campana. Al monitorizar métricas cotidianas con asimetría natural —como el ahorro neto familiar, las horas de recuperación entre bloques de maratón o los retrasos en los desplazamientos diarios al trabajo—, los datos se agrupan en torno a un límite físico insalvable de cero. Aplicar ±2 desviaciones estándar sobre datos asimétricos pronostica límites negativos físicamente imposibles; básate en su lugar en la mediana y el rango intercuartílico (IQR).

Subestimación leve de la desviación estándar en muestras reducidas

Aunque la corrección de Bessel (dividir entre n - 1) convierte a la varianza muestral (s²) en un estimador matemáticamente insesgado, la raíz cuadrada reintroduce un leve sesgo a la baja en la desviación estándar muestral (s) debido a la desigualdad de Jensen. Al trabajar con muestras de menos de 10 observaciones —como cronometrar 5 series de velocidad o registrar la tensión arterial matutina durante 7 días consecutivos—, la desviación estándar calculada suele subestimar la dispersión real entre un 3% y un 6%.

Rendimientos decrecientes en la precisión por tamaño muestral

Dado que el error estándar se reduce proporcionalmente a la raíz cuadrada del tamaño de la muestra (√n), reducir el margen de error a la mitad exige cuadruplicar el número de observaciones. Aumentar las sesiones de entrenamiento registradas o las lecturas de consumo de combustible de 10 a 40 entradas recorta la incertidumbre de la estimación en un 50%, pero pasar de 40 a 70 mediciones aporta únicamente una mejora adicional del 18%. Concéntrate en recopilar datos con alta fidelidad y consistencia en vez de obsesionarte con el volumen de la muestra.

Problemas comunes y soluciones

⚠️La desviación estándar muestral devuelve indefinido o división por cero

La desviación estándar muestral requiere al menos dos datos distintos (n ≥ 2) debido a que la corrección de Bessel divide entre (n - 1). Cuando solo se introduce una única observación (n = 1), los grados de libertad son cero, lo que hace que la varianza sea matemáticamente indeterminada. Cambia al modo Población si analizas un evento único y completo (donde N = 1 y σ = 0), o introduce observaciones muestrales adicionales.

⚠️La desviación estándar arroja exactamente cero (s = 0)

Una desviación estándar igual a cero indica que absolutamente todos los valores introducidos son idénticos (por ejemplo, cuatro vueltas consecutivas a la pista de atletismo clavadas en 62,0 segundos). Aunque es un resultado matemáticamente válido que refleja una consistencia absoluta, una dispersión nula provocará errores de división por cero en fórmulas derivadas normalizadas, tales como el coeficiente de variación y las puntuaciones Z.

⚠️Picos de rendimiento legítimos identificados como falsos atípicos

Los filtros estándar de valores atípicos marcan cualquier punto situado más allá de 1,5 × IQR como una anomalía, lo que presupone una distribución simétrica. En la actividad física real y la vida cotidiana —como un pico intencionado de ritmo en un esprint por intervalos o la factura de gas de los meses más fríos del invierno—, los picos de cola pesada son completamente normales. Aumenta el umbral de atípicos a 3,0 × IQR (límites exteriores extremos) o contrasta los registros con tu diario de entrenamiento antes de descartar datos reales.

⚠️El límite inferior del intervalo de confianza cae por debajo de cero

Los intervalos de confianza simétricos (Media ± Margen de error) asumen que la dispersión se distribuye de manera idéntica por encima y por debajo del promedio. Cuando la media es reducida y la varianza relativa es notable —como al contabilizar entrenamientos perdidos a la semana o averías mecánicas del coche—, el límite inferior puede situarse matemáticamente en valores negativos. Ajusta el límite inferior a cero o utiliza la mediana e intervalos de percentiles no paramétricos para variables físicas acotadas que no pueden ser negativas.

Preguntas frecuentes (FAQ)

¿Cómo se calcula la desviación estándar paso a paso?▼

Para calcular la desviación estándar muestral: calcula la media aritmética, resta la media a cada dato observado, eleva al cuadrado cada diferencia individual, suma todas las desviaciones cuadráticas, divide esa suma total entre n - 1 (corrección de Bessel) y extrae la raíz cuadrada positiva: s = √[ Σ(x - Media)² / (n - 1) ]. Por ejemplo, con los valores 4, 8 y 12, la media es 8; las diferencias al cuadrado respecto a 8 son 16, 0 y 16 (que suman 32); al dividir entre (3 - 1 = 2) se obtiene una varianza de 16, lo que da una desviación estándar final de 4.

¿Qué se considera una desviación estándar buena o normal?▼

El valor óptimo de una desviación estándar depende de la magnitud de la media y se evalúa mediante el coeficiente de variación (CV = s / Media × 100%). En la regulación de ritmos deportivos y biometría en reposo, un CV inferior al 5%-8% denota una consistencia de élite, mientras que un rango del 10% al 15% es habitual en corredores recreativos y salud cotidiana. En fabricación de precisión o dosificación farmacológica, se exige un CV por debajo del 1%-2%, mientras que en activos financieros volátiles la desviación estándar supera con frecuencia el 30% de su valor medio.

¿Cuál es la diferencia entre desviación estándar y varianza?▼

La varianza mide la dispersión media en unidades al cuadrado (como segundos² o euros²), mientras que la desviación estándar es la raíz cuadrada de la varianza, expresando la dispersión en las mismas unidades originales de la medición (como segundos o euros). Si bien la varianza es la base matemática indispensable para análisis como ANOVA y modelos estadísticos, la desviación estándar ofrece una lectura intuitiva y tangible directamente comparable con tus registros del día a día.

¿Cuál es la diferencia entre desviación estándar y error estándar?▼

La desviación estándar mide la dispersión intrínseca de los datos individuales dentro de una muestra, mientras que el error estándar de la media (SE = s / √n) cuantifica la proximidad entre el promedio de la muestra y la verdadera media poblacional. La desviación estándar describe la variabilidad natural y permanece relativamente estable al aumentar el número de observaciones, mientras que el error estándar refleja la exactitud de la estimación y disminuye progresivamente hacia cero a medida que amplías la muestra.

¿Por qué se divide entre n menos 1 en lugar de n en la desviación muestral?▼

Se divide entre n - 1 (conocido como corrección de Bessel) porque las observaciones de una muestra tienden a agruparse de forma natural más cerca de su propia media muestral que de la verdadera media de toda la población. Al estimar la media a partir de los propios datos se introduce una restricción algebraica (la suma de las desviaciones siempre es cero), lo que consume un grado de libertad. Dividir entre n subestima sistemáticamente la dispersión poblacional; dividir entre n - 1 corrige dicho sesgo y proporciona una estimación matemáticamente insesgada.

Herramientas y utilidades relacionadas

Todas las herramientas →